Wie wir die Kosten für einen Browser-Agenten um das 76-fache gesenkt und ihn um das 5-fache schneller gemacht haben, indem wir seinen Cache intakt gehalten haben


Eine Studie mit GPT-6 Astra in Codex über vier Modelle – von der Untersuchung des Codes bis zur Messung der Ergebnisse


Warum wir uns damit beschäftigt haben
Asana führt über StackAI die Workflow-Automatisierung für Agenten auf seiner Plattform ein, und bei der Größe von Asana summieren sich kleine Ineffizienzen. Unser Ziel war es, einen Browser-Assistenten kostengünstiger und schneller zu machen, ohne die Qualität der Antworten zu beeinträchtigen.
„So sehen Teams aus Menschen und KI-Assistenten in der Praxis aus. Ein Entwickler gab die Richtung vor, ein Agent führte die Tests durch, und die Ergebnisse wurden über Command in die Produktion übernommen. Dies zeigt, wie Asana Teams aus Mensch und KI zum Leben erweckt.“ – Arnab Bose, CPO bei Asana
Was lief schief?
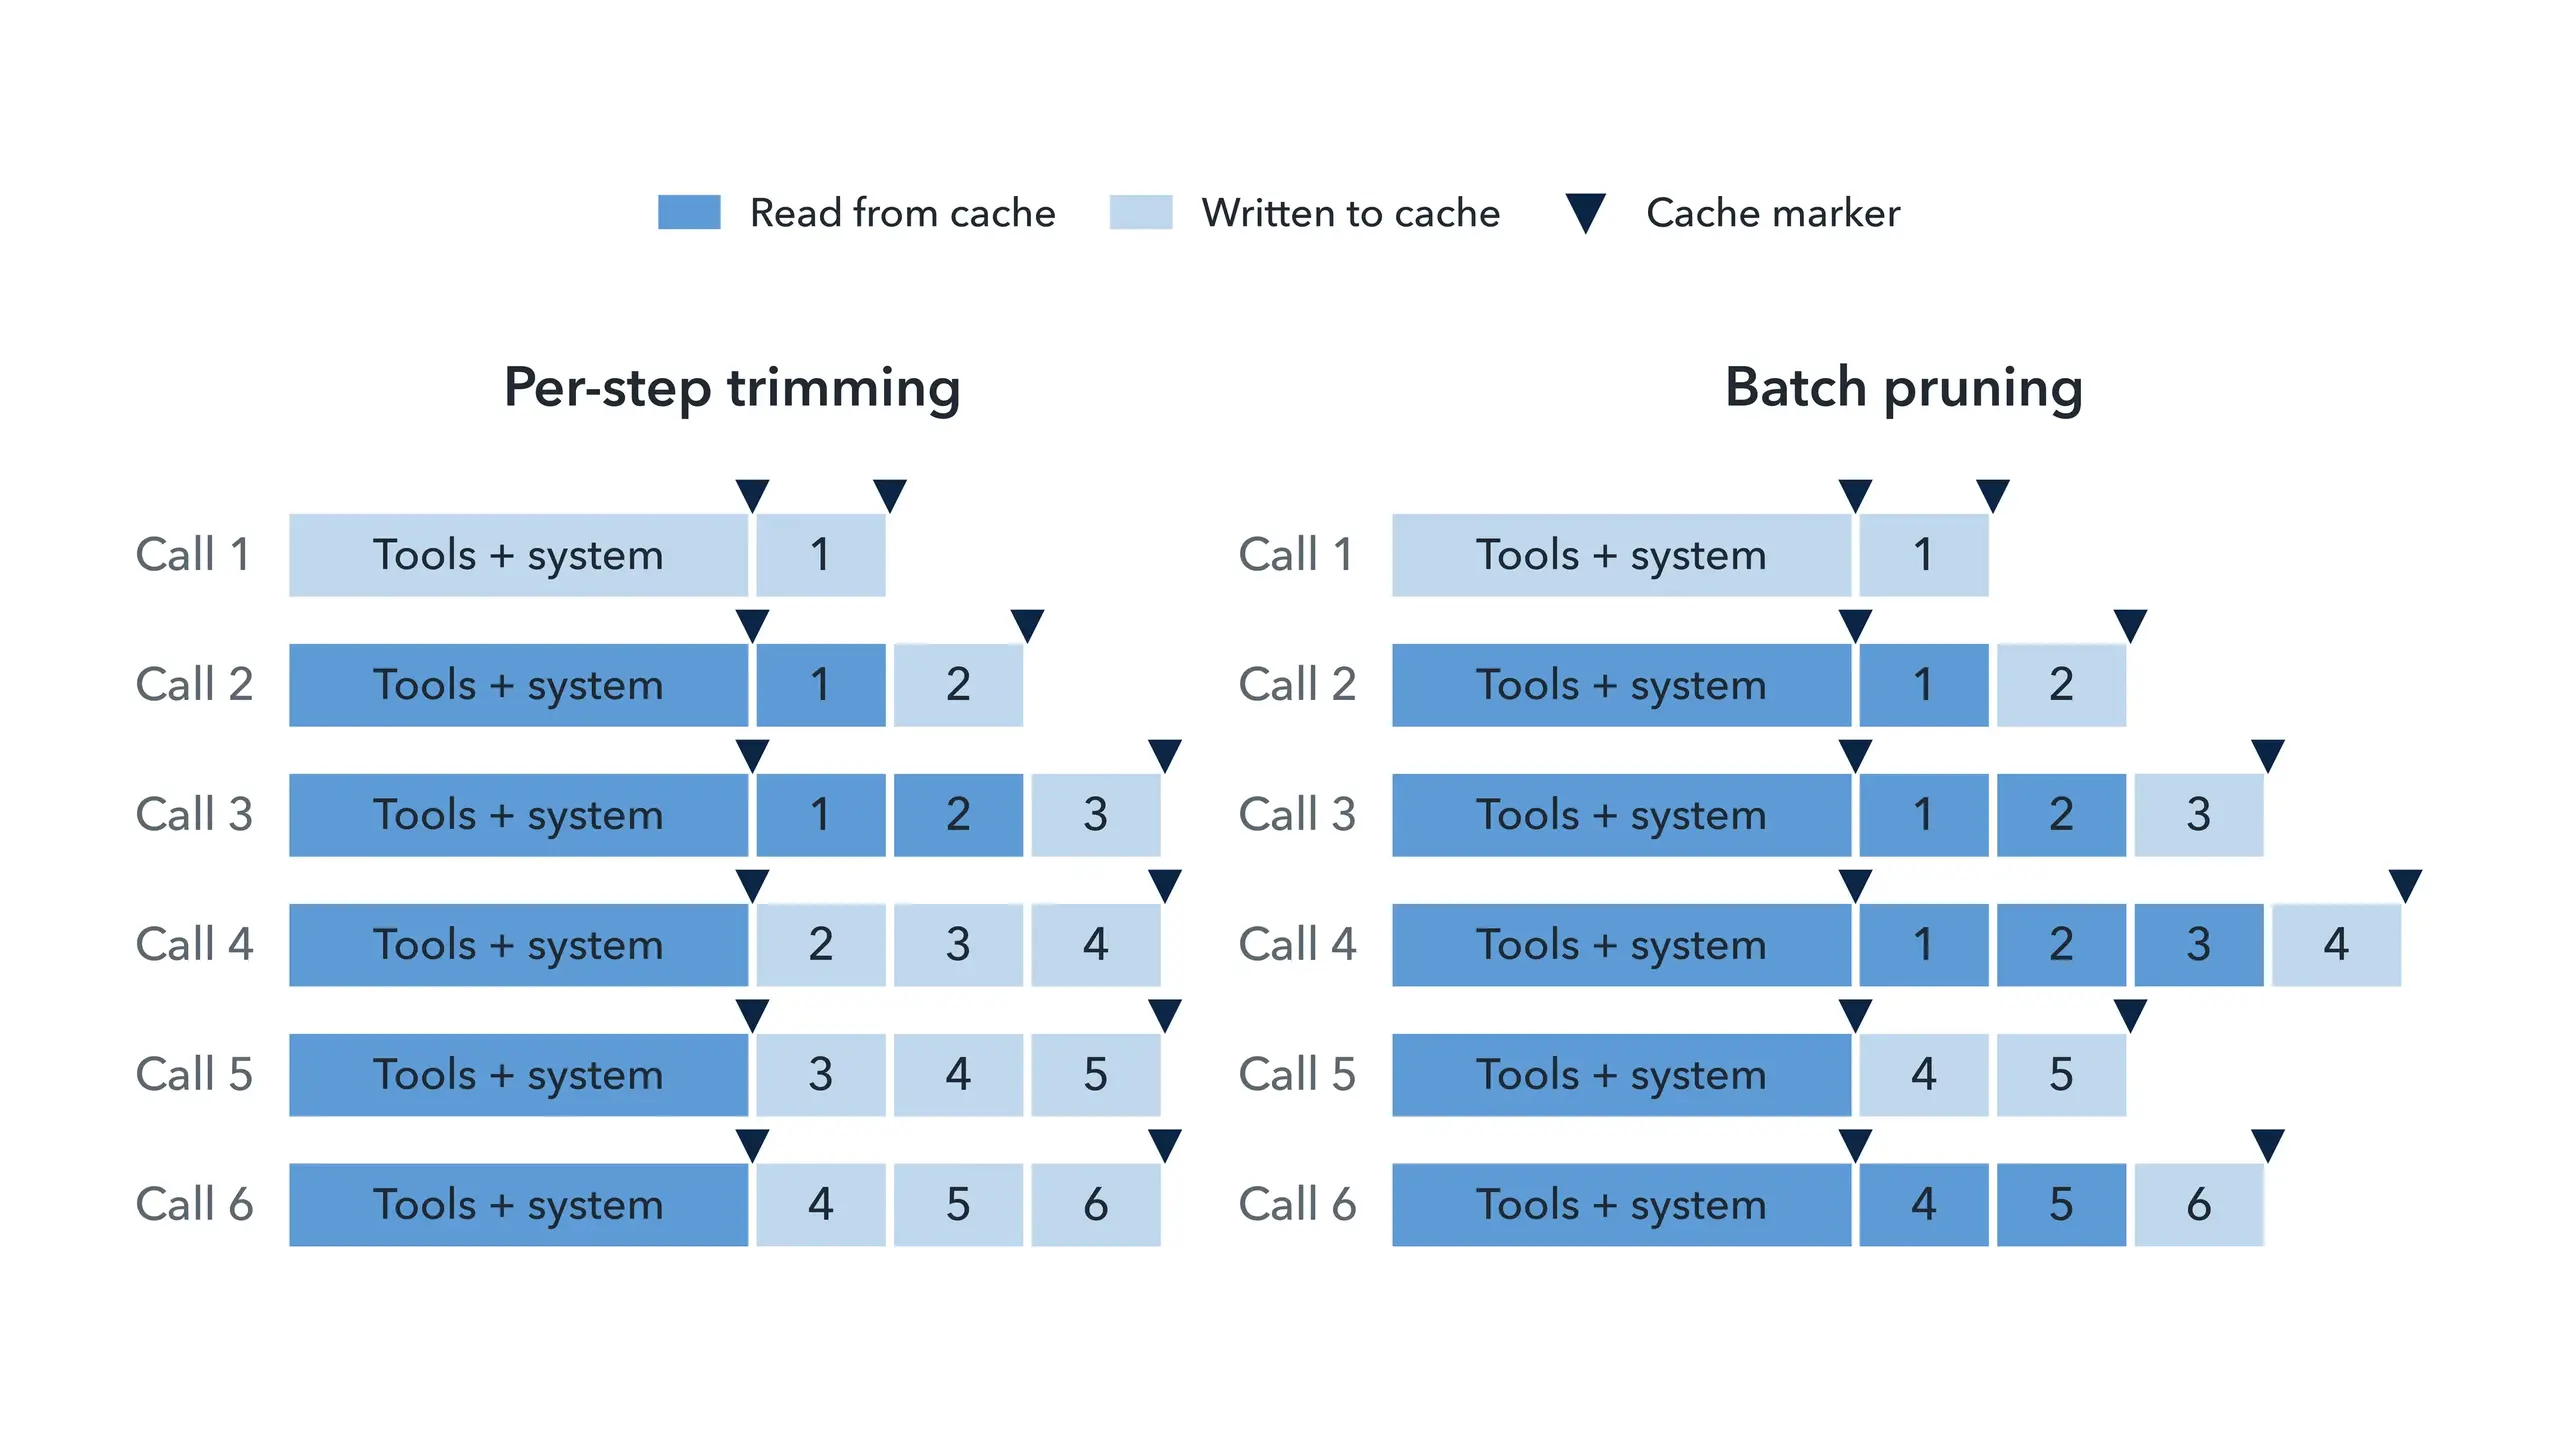
Ein Browser-Assistent sendet bei jedem Aufruf seine Tools, die Systemaufforderung und den wachsenden Verlauf von Seitentext und Screenshots erneut. Das Zwischenspeichern von Prompts senkt die Kosten für wiederholte Eingaben: Bei den von uns getesteten Modellen kosten Cache-Lesevorgänge 0,05- bis 0,1-mal so viel wie der Standardpreis für Eingaben. Ein Cache verwendet jedoch nur das längste unveränderte Präfix einer Anfrage erneut. Unser Assistent hat seine Tools und seine Systemaufforderung zwischengespeichert, aber nicht seinen Verlauf. Und allein das Zwischenspeichern des Verlaufs hätte nicht geholfen: Der Assistent hat bei jedem Schritt den vorherigen Screenshot entfernt und älteren Text gekürzt, um das Budget für den Verlauf einzuhalten. Jede Bearbeitung änderte einen früheren Teil der Anfrage, sodass die Wiederverwendung bei fast jedem Aufruf fehlschlug.
Die Lösung
Speichern Sie zunächst auch den Verlauf im Cache, mit einer Cache-Markierung für das neueste Tool-Ergebnis. Zweitens: Hören Sie auf, ihn bei jedem Aufruf zu bearbeiten. Beim Batch-Pruning werden Screenshots beibehalten und in Batches entfernt: Bei 20:1 behält der Agent bis zu 20 Screenshots und reduziert sie dann auf 1, sodass bei etwa 19 aufeinanderfolgenden Aufrufen der zwischengespeicherte Verlauf wiederverwendet wird. Wir haben auch das Verlaufsbudget von 120.000 auf 480.000 Zeichen erhöht, sodass alter Text nicht mehr gekürzt wurde.

Wie wir es durchgeführt haben
GPT-6 Astra, das in Codex arbeitet, hat den größten Teil der Arbeit erledigt: Es hat den Code überprüft, jede Anfrage instrumentiert, schnelle Tests durchgeführt, um die relevanten Variablen zu ermitteln, den Code so umgestaltet, dass Workflows parallel ausgeführt werden können, die Ausführungen gestartet und die Traces analysiert. Menschen legten das Ziel und die Standards fest und überprüften die Schlussfolgerungen. Command, die Softwarebereitstellungsplattform von Asana, war das Dokumentationssystem: Die Anfragen, Traces und Ergebnisse jeder Sitzung wurden dort aufgezeichnet, sodass wir die gesamte Studie anschließend analysieren konnten. Die Ergebnisse wurden dann in Tickets, Pull Requests und überprüfte Änderungen umgewandelt, die anschließend bereitgestellt wurden.


Ich hätte nie daran gedacht, das alles manuell zu erledigen, da es wahrscheinlich Monate gedauert hätte. Mit Codex dauerte es etwa eine Woche: Ich legte vor dem Schlafengehen ein /Ziel fest und überprüfte die Ergebnisse am nächsten Morgen.
Jetzt fühlt sich jede Nacht, in der unsere Agents nicht aktiv sind, wie eine verschwendete Nacht an.
Wir haben sechs Caching- und Verlaufsrichtlinien mit zwei Budgets auf GPT-6.1 Sol und drei weiteren Frontier-Modellen, den Modellen A, B und C (siehe Tabelle unten), mit jeweils drei Durchläufen pro Bedingung getestet: 144 Durchläufe plus 12 Durchläufe im Rahmen einer Folgestudie. Wir haben die Kosten anhand der Token-Zähler der einzelnen Anbieter berechnet, und jede Antwort wurde anhand einer unabhängig erstellten Referenz bewertet.
Modell | Was ist das genau? | Preis |
Modell A | Ein kleineres, kostengünstigeres Modell eines anderen Frontier-Labors, das im Herbst 2025 veröffentlicht wurde | Die Hälfte des Preises von GPT-6.1 Sol |
Modell B | Das ursprünglich in der Produktion verwendete Modell aus demselben Labor wie Modell A, das im Sommer 2026 veröffentlicht wurde | Wie GPT-6.1 Sol |
Modell C | Eine neuere Version von Modell B, die im Herbst 2026 veröffentlicht wurde | Wie GPT-6.1 Sol |
GPT-6.1 Sol | Das Modell von OpenAI | Referenz |
Ergebnisse

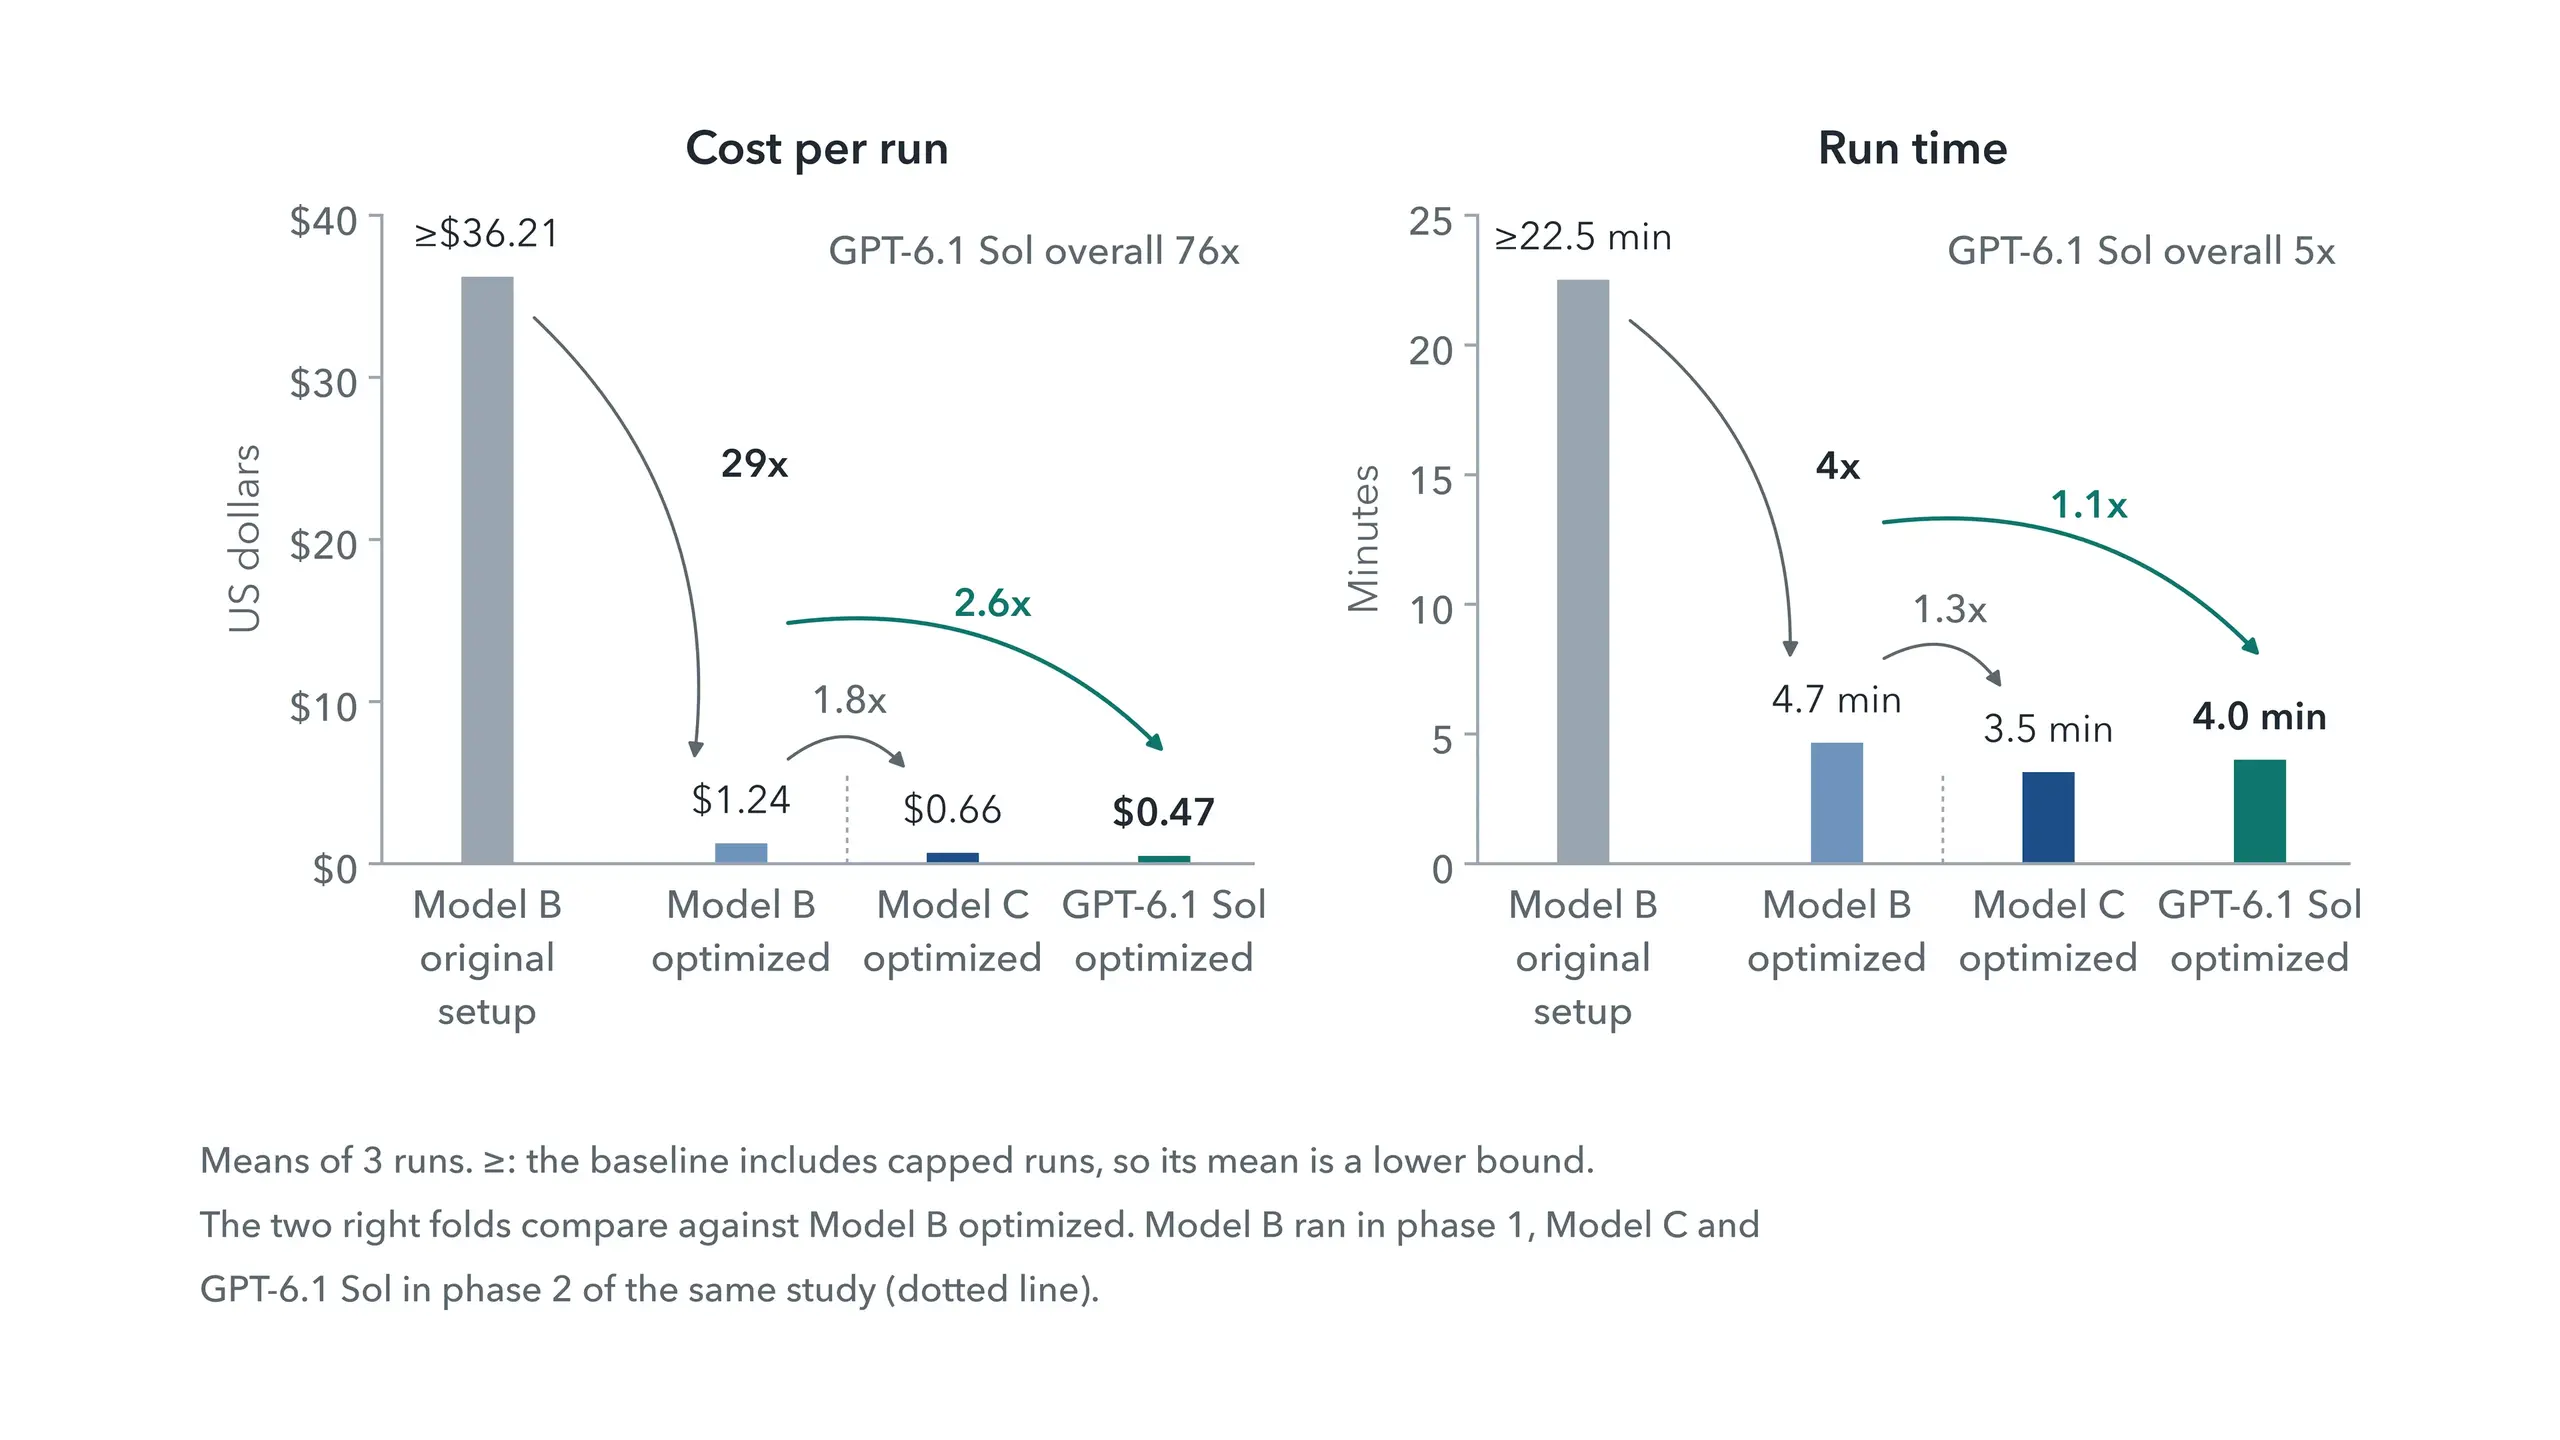
Bei Modell B wurden die Kosten pro Durchlauf unter den besten Bedingungen um das 29-fache gesenkt und der Durchlauf war 4-mal schneller als bei der ursprünglichen Produktionskonfiguration. Bei GPT-6.1 Sol kostete derselbe Agent 76 x weniger und lief 5 x schneller, wobei er 89 % seiner Eingaben aus dem Cache auslas. Bei jedem Modell kostete jeder Ausführungslauf unter optimalen Bedingungen weniger als jeder Ausführungslauf unter Standardbedingungen und berücksichtigte alle 192 Fakten.
Erkenntnisse
Das Budget muss zum Modell passen. Neuere Modelle verbrauchten das kleinere Budget schneller: Modell C kürzte seinen Verlauf erstmals bei Abfrage 10, Modell A bei Abfrage 64. Bei 120.000 Zeichen gab Modell C in keinem der 18 Durchläufe eine Antwort, während Sol in 3 Durchläufen eine Antwort gab, wobei die meisten das Schrittlimit erreichten; bei 480.000 Zeichen gab es in beiden Fällen in jedem Durchlauf eine Antwort.
Caching allein reicht nicht aus. Ohne Batch-Pruning war das Zwischenspeichern des Verlaufs bei dem größeren Budget bei drei von vier Modellen teurer als das Nicht-Zwischenspeichern: Der Cache wurde ständig neu geschrieben und nur selten gelesen.
Müssen Sie überhaupt bereinigen?
Die Daten pro Aufruf deuteten darauf hin, dass hier möglicherweise kein Pruning erforderlich ist, sodass bei einer Folgeanalyse jeder Screenshot beibehalten wurde. Die Kosten pro Aufruf waren 1,2 mal niedriger als bei der besten Bedingung für Modell B und Sol und etwa 5 % niedriger bei Modell C. Das Pruning ist nach wie vor wichtig für lange Aufgaben, kleine Kontextfenster und teurere Cache-Lesevorgänge.
Mit drei oder vier Ausführungen pro Bedingung und einer zwischen den Ausführungen variierenden Anzahl von Aufrufen zeigt diese Studie eher allgemeine Muster, als Bedingungen zu unterscheiden, die nur wenige Prozentpunkte voneinander abweichen.
Leitlinien sind nach wie vor wichtig
Kein Durchlauf erreichte das Budget von 480.000 Zeichen, sodass es diese Durchläufe nicht einschränkte. Limits sind nach wie vor wichtig: Ein abweichender Agent nähert sich dem Kontextlimit, und wenn der Cache ausfällt, wird für jeden Aufruf der volle Preis fällig. Obergrenzen für Schritte, Token und Kosten pro Durchlauf begrenzen die Kosten eines schlechten Durchlaufs. Die Komprimierung ist eine weitere Option, die jedoch nicht Gegenstand dieser Studie ist.
Von den Erkenntnissen zur Produktion
Einige Erkenntnisse ergaben sich später, als andere Agenten jeden in Command protokollierten Trace überprüften. Das ist bei einer einzelnen Sitzung schwierig, da man nicht sicher sein kann, dass alle Daten gespeichert wurden. Da alles in Command gespeichert war, auf das unsere Agenten über MCP zugriffen, mussten wir nie ein Experiment wiederholen, um fehlende Daten zu erhalten, was die Arbeit beschleunigte. Die Ergebnisse wurden zu Tickets für Menschen und Programmier-Assistenten, dort wurden Pull Requests überprüft und die Änderungen an StackAI übermittelt. Seit der Studie haben wir dieselbe Aufgabe auch mit Codex durchgeführt, der seinen Ansatz mit dem des StackAI-Agenten verglich und eine zweite Runde von Verbesserungen vorschlug, die jetzt als Tickets in Command vorliegen.
Unsere Erkenntnisse
Speichern Sie den wachsenden Verlauf im Cache, nicht nur die Systemaufforderung.
Lassen Sie den Verlauf nur im Anfügemodus; wenn ein Bereinigen erforderlich ist, sollten Sie dies in großen Chargen durchführen.
Legen Sie das Verlaufsbudget entsprechend dem Modell fest.
Messen Sie die Cache-Lesevorgänge pro Aufruf mit den eigenen Zählern des Anbieters.
Führen Sie eine vollständige Aufzeichnung jeder Sitzung, damit die Analyse und die anschließenden Arbeiten auf demselben Datensatz basieren.
Asana entwickelt Tools, um solche Experimente zur Routine zu machen. Die vollständige Studie umfasst Methoden, Ergebnisse und Einschränkungen.
Die Geschwindigkeit der Bereitstellung ist nicht mehr der Engpass, sondern die menschliche Aufmerksamkeit. Ich glaube, wir stehen kurz vor einer Welt, in der jeder Entwickler ein Produktmanager ist, der eine Flotte von Agents leitet.