Comment nous avons divisé par 76 le coût d'un agent navigateur et multiplié par 5 sa rapidité en conservant son cache intact


Une étude portant sur GPT-6 Astra dans Codex, menée sur quatre modèles, de l'analyse du code à la mesure des résultats


Pourquoi nous avons mené cette étude
Asana intègre l'automatisation des processus des agents à sa plateforme via StackAI, et à l'échelle d'Asana, les petites inefficacités s'accumulent. Notre objectif était de rendre un agent navigateur moins cher et plus rapide sans compromettre la qualité des réponses.
« Voici à quoi ressemblent les équipes mixtes composées d'humains et d'agents en pratique. Un ingénieur a défini l'orientation, un agent a mené les expériences et les résultats sont passés par Command pour être mis en production. Cela montre comment Asana donne vie aux équipes composées à la fois de collaborateurs et d'agents. » - Arnab Bose, directeur produit chez Asana
Quelles faiblesses avons-nous identifiées ?
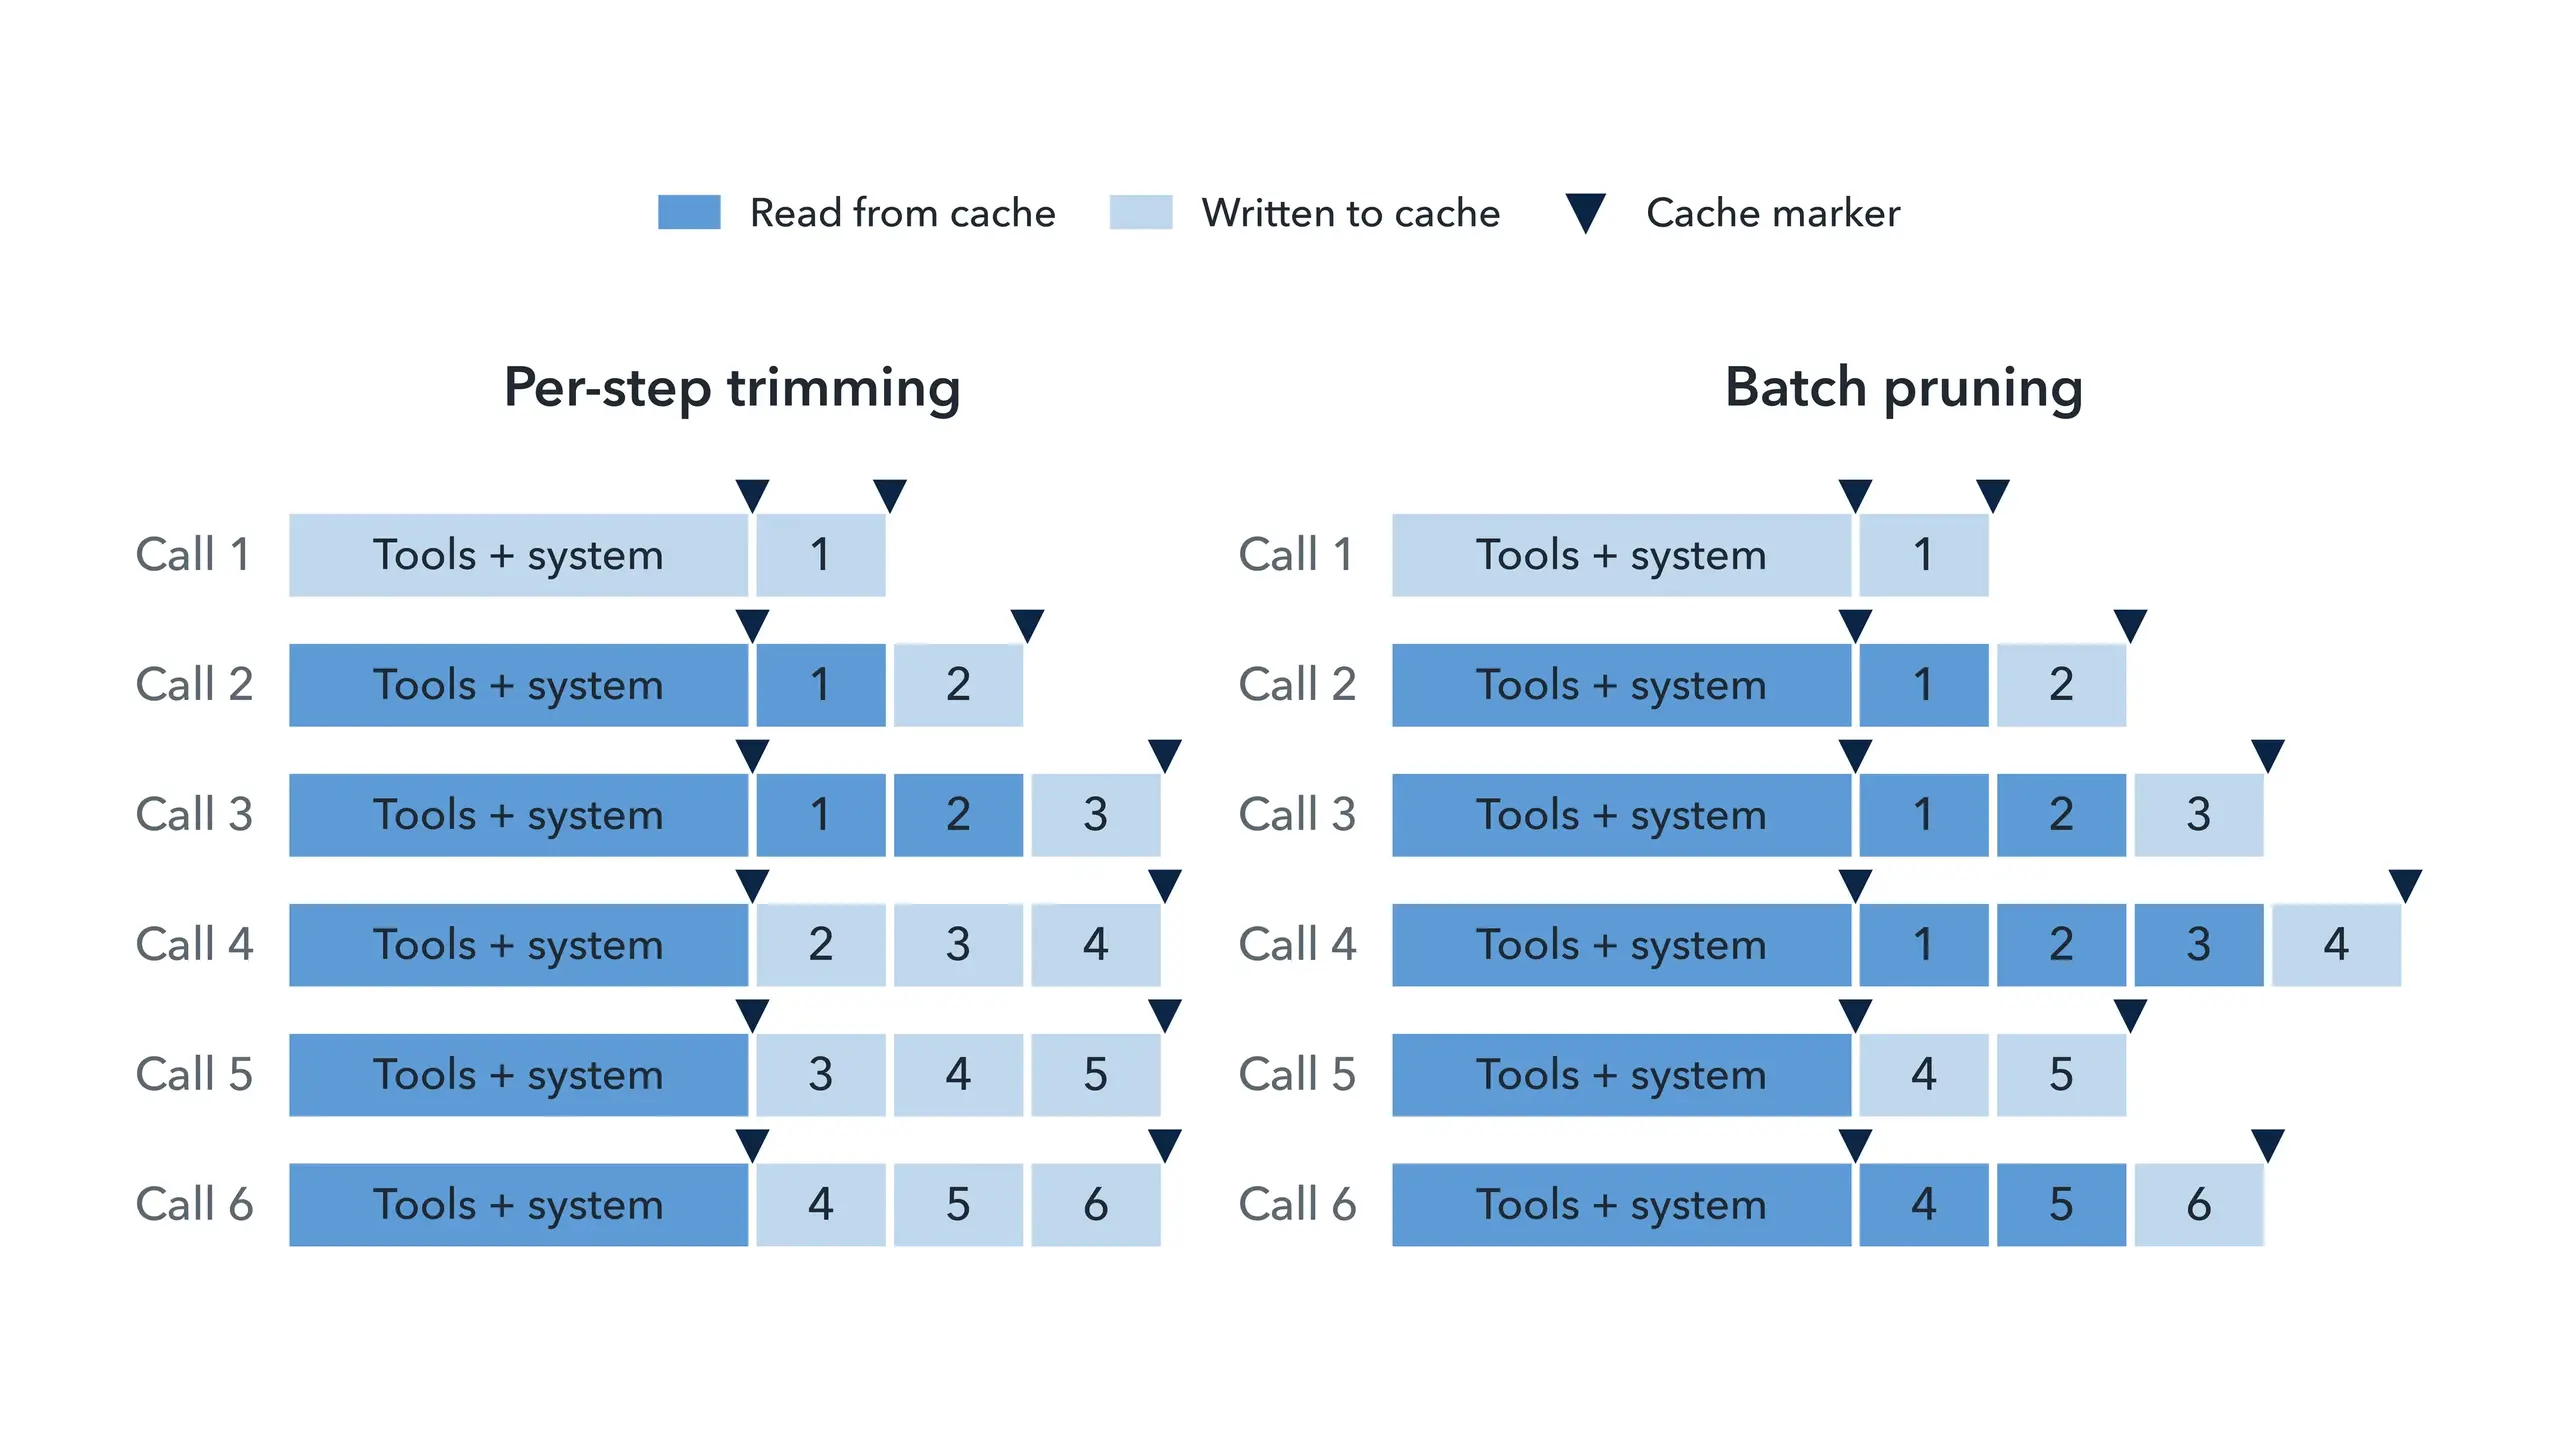
À chaque appel, un agent navigateur renvoie ses outils, son instruction système et son historique croissant de texte de page et de captures d'écran. La mise en cache des prompts réduit le coût des entrées répétées : sur les modèles que nous avons testés, les lectures du cache coûtent de 0,05 fois à 0,1 fois le prix d'une entrée standard. Mais un cache ne réutilise que le plus long préfixe inchangé d'une requête. Notre agent a mis en cache ses outils et son instruction système, mais pas son historique, et la mise en cache de l'historique seul n'aurait pas été utile : l'agent supprimait la capture d'écran précédente à chaque étape et réduisait le texte plus ancien pour respecter la limite de l'historique. Chaque modification altérait une partie antérieure de la requête, de sorte que la réutilisation échouait lors de presque chaque appel.
La solution
Tout d'abord, mettez également l'historique en cache, avec un marqueur de cache sur le dernier résultat de l'outil. Deuxièmement, cesser de le modifier à chaque appel. L'élagage par lots conserve les captures d'écran et les supprime par lots : à 20:1, l'agent conserve jusqu'à 20 captures d'écran, puis en réduit le nombre à 1, de sorte qu'environ 19 appels consécutifs réutilisent l'historique mis en cache. Nous avons également augmenté le budget de l'historique de 120 000 à 480 000 caractères, de sorte que l'ancien texte n'était plus tronqué.

Comment nous avons procédé
GPT-6 Astra, opérant dans Codex, a effectué la majeure partie du travail : il a audité le code, instrumenté chaque requête, exécuté des tests rapides pour identifier les variables importantes, remanié le code pour exécuter les processus en parallèle, lancé les exécutions et analysé les traces. Les humains ont défini l'objectif et les normes, et ont examiné les conclusions. Command, la plateforme de livraison de logiciels d'Asana, était le système d'enregistrement : les requêtes, les traces et les résultats de chaque session y étaient enregistrés, ce qui nous a permis d'analyser l'ensemble de l'étude par la suite. Les résultats ont ensuite été transformés en tickets, en pull requests et en modifications vérifiées qui ont été mises en production.


Je n'ai jamais envisagé de le faire manuellement, car cela m'aurait probablement pris des mois. Avec Codex, cela a pris environ une semaine : je définissais un /objectif avant d'aller me coucher et je passais en revue les résultats le matin.
Désormais, chaque nuit où nos agents ne sont pas en fonctionnement nous semble être une nuit gâchée.
Nous avons testé six politiques de mise en cache et d'historique avec deux budgets sur GPT-6.1 Sol et trois autres modèles de pointe, les modèles A, B et C (tableau ci-dessous), avec trois exécutions par condition : 144 exécutions, plus un suivi de 12 exécutions. Nous avons calculé les coûts à partir des compteurs de jetons de chaque fournisseur, et chaque réponse a été évaluée par rapport à une référence établie indépendamment.
Modèle | Description | Prix |
Modèle A | Un modèle plus petit et moins coûteux d'un autre laboratoire de pointe, lancé à l'automne 2025 | La moitié du prix de GPT-6.1 Sol |
Modèle B | Le modèle initialement utilisé en production, issu du même laboratoire que le modèle A, lancé à l'été 2026 | Identique à GPT-6.1 Sol |
Modèle C | Une version plus récente du modèle B, lancée à l'automne 2026 | Identique à GPT-6.1 Sol |
GPT-6.1 Sol | Modèle d'OpenAI | Référence |
Résultats

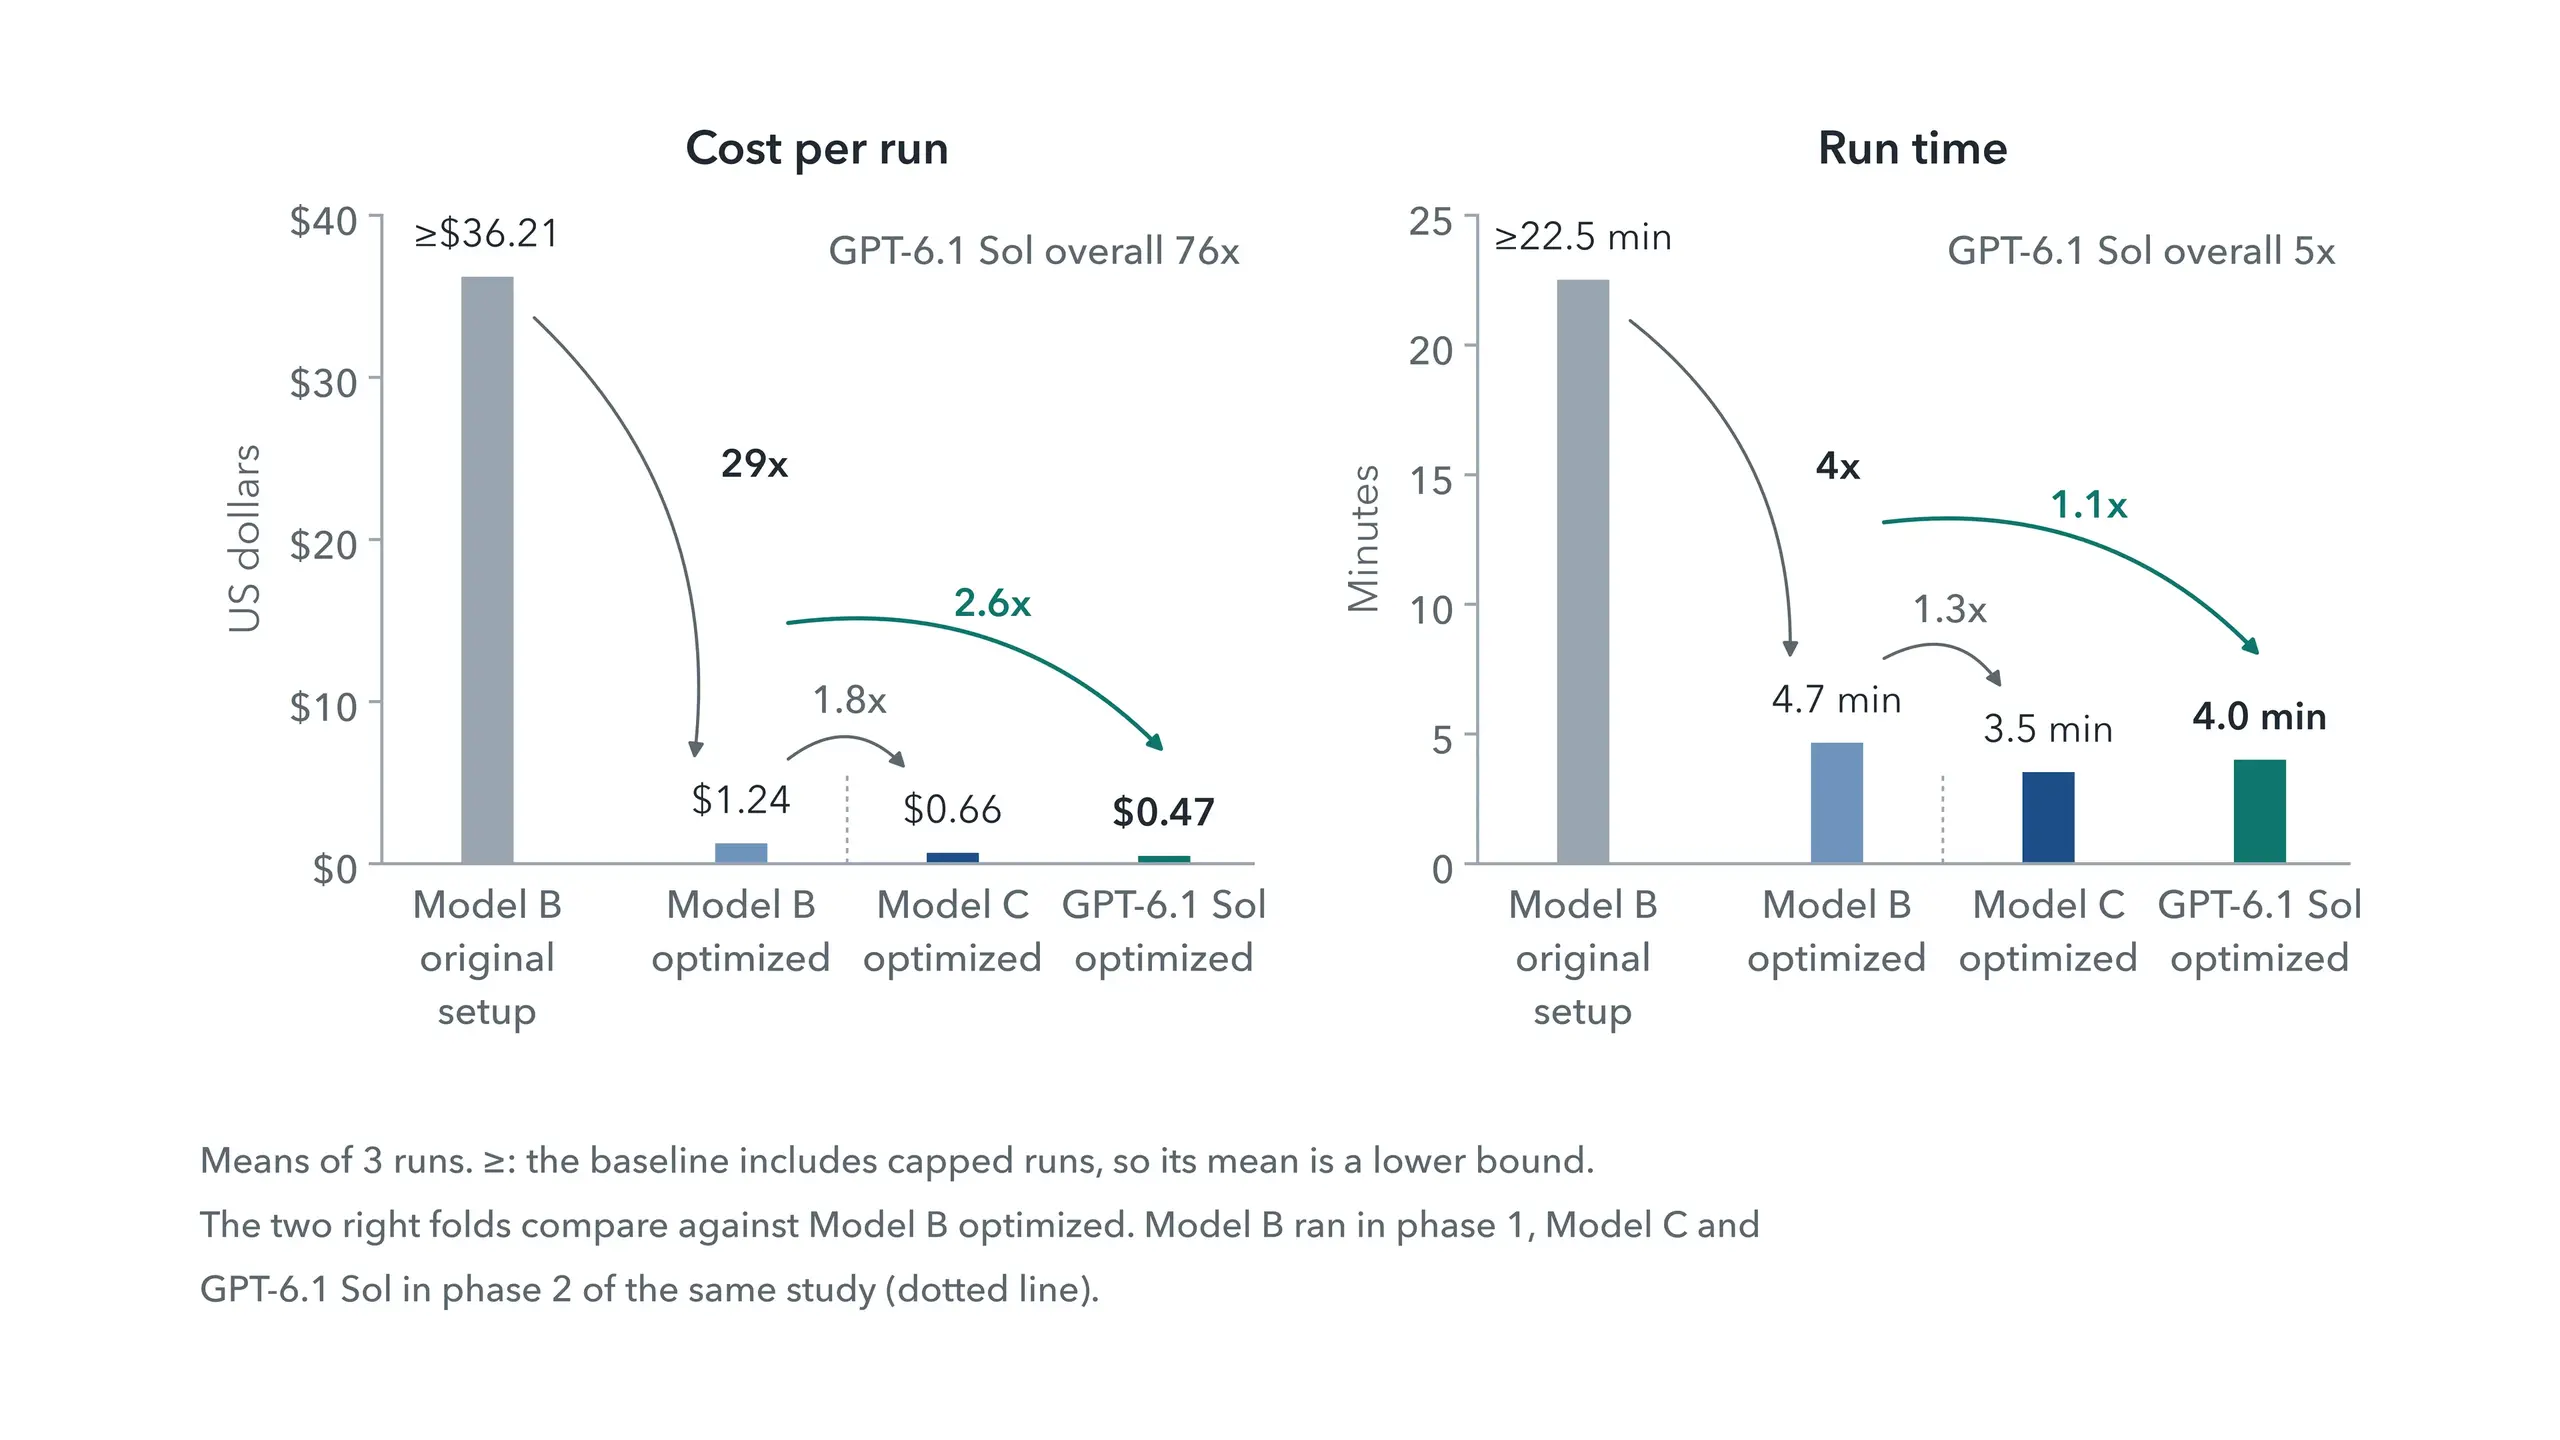
Sur le modèle B, la meilleure condition a divisé le coût par exécution par 29 et a permis une exécution 4 fois plus rapide que la configuration de production initiale. Sur GPT-6.1 Sol, le même agent coûtait 76 fois moins cher et s'exécutait 5 fois plus vite, lisant 89 % de ses entrées à partir du cache. Sur chaque modèle, chaque exécution dans les meilleures conditions a coûté moins cher que chaque exécution de référence et a pris en compte l'ensemble des 192 faits.
Enseignements
Le budget doit être adapté au modèle. Les modèles plus récents ont épuisé le budget le plus faible plus rapidement : le modèle C a d'abord réduit son historique à l'appel 10, le modèle A à l'appel 64. À 120 000 caractères, le modèle C n'a répondu lors d'aucune des 18 exécutions et Sol lors de 3 exécutions, la plupart ayant atteint la limite d'étapes ; à 480 000 caractères, les deux modèles ont répondu lors de chaque exécution.
La mise en cache seule ne suffit pas. Sans élagage par lots, la mise en cache de l'historique avec le budget le plus élevé coûtait plus cher que de ne pas le mettre en cache sur trois des quatre modèles : le cache était continuellement réécrit et rarement lu.
Avez-vous vraiment besoin d'élaguer ?
Les données par appel ont suggéré que l'élagage n'était peut-être pas nécessaire ici, c'est pourquoi une tâche de suivi a conservé toutes les captures d'écran. Le coût par appel était 1,2 fois inférieur à celui de la meilleure condition pour le modèle B et Sol, et environ 5 % inférieur pour le modèle C. L'élagage reste important pour les tâches longues, les petites fenêtres de contexte et les lectures de cache plus coûteuses.
Avec trois ou quatre exécutions par condition et des nombres d'appels qui varient d'une exécution à l'autre, cette étude met en évidence des tendances générales plutôt que de distinguer des conditions qui ne diffèrent que de quelques pour cent.
Les garde-fous restent importants
Aucune exécution n'a atteint le budget de 480 000 caractères, de sorte que celui-ci n'a pas constitué une contrainte pour ces exécutions. Les limites restent importantes : un agent qui dérive se rapproche de la limite de contexte, et si le cache tombe en panne, chaque appel est facturé au prix fort. Les plafonds appliqués aux étapes, aux jetons et au coût par exécution limitent le coût d'une exécution défaillante. Le compactage est une autre option, qui dépasse le cadre de cette étude.
Des résultats à la production
Certains résultats sont apparus plus tard, lorsque d'autres agents ont examiné chaque trace enregistrée dans Command by Asana. Il est difficile de le faire à partir d'une seule session, où vous ne pouvez pas être sûr que toutes les données ont été stockées. En conservant toutes les informations dans Command, auquel nos agents accédaient via MCP, nous n'avons jamais eu à répéter une expérience pour récupérer des données manquantes, ce qui a accéléré le travail. Les résultats ont été transformés en tickets pour les humains et les agents de codage, les demandes d'extraction y ont été examinées et les modifications ont été envoyées à StackAI. Depuis l'étude, nous avons également exécuté la même tâche avec Codex, qui a comparé son approche avec celle de l'agent StackAI et a suggéré une deuxième série d'améliorations, désormais sous forme de tickets dans Command.
Nos enseignements
Mettez en cache l'historique croissant, et pas seulement l'instruction système.
Conservez un historique en mode ajout uniquement ; lorsqu'un nettoyage est nécessaire, effectuez-le par grands lots.
Définissez le budget de l'historique en fonction du modèle.
Mesurez les lectures du cache par appel à l'aide des compteurs du fournisseur.
Conservez un enregistrement complet de chaque session, afin que l'analyse et le travail de suivi utilisent le même enregistrement.
Asana élabore des outils pour que des expériences comme celle-ci deviennent monnaie courante. L'étude complète couvre les méthodes, les résultats et les limites.
La vitesse de livraison n'est plus le frein ; c'est l'attention humaine qui l'est. Je pense que nous sommes proches d'un monde où chaque ingénieur est un chef de projet dirigeant une flotte d'agents.