Como reduzimos o custo de um agente de navegador em 76 vezes e o tornamos 5 vezes mais rápido mantendo o seu cache intacto


Um estudo com o GPT-6 Astra no Codex em quatro modelos, desde a investigação do código até a medição dos resultados


Por que investigamos
A Asana está trazendo a automatização de fluxos de trabalho de agentes para a sua plataforma por meio da StackAI, e, na escala da Asana, pequenas ineficiências se acumulam. Nosso objetivo era tornar um agente de navegador mais barato e rápido sem reduzir a qualidade das respostas.
“É assim que são as equipes de pessoas e agentes na prática. Um engenheiro definiu a direção, um agente realizou os experimentos e os resultados passaram pelo Command para chegar ao ambiente de produção. Isso demonstra como a Asana dá vida às equipes compostas por pessoas e agentes.” — Arnab Bose, diretor de produtos da Asana
O que não estava funcionando
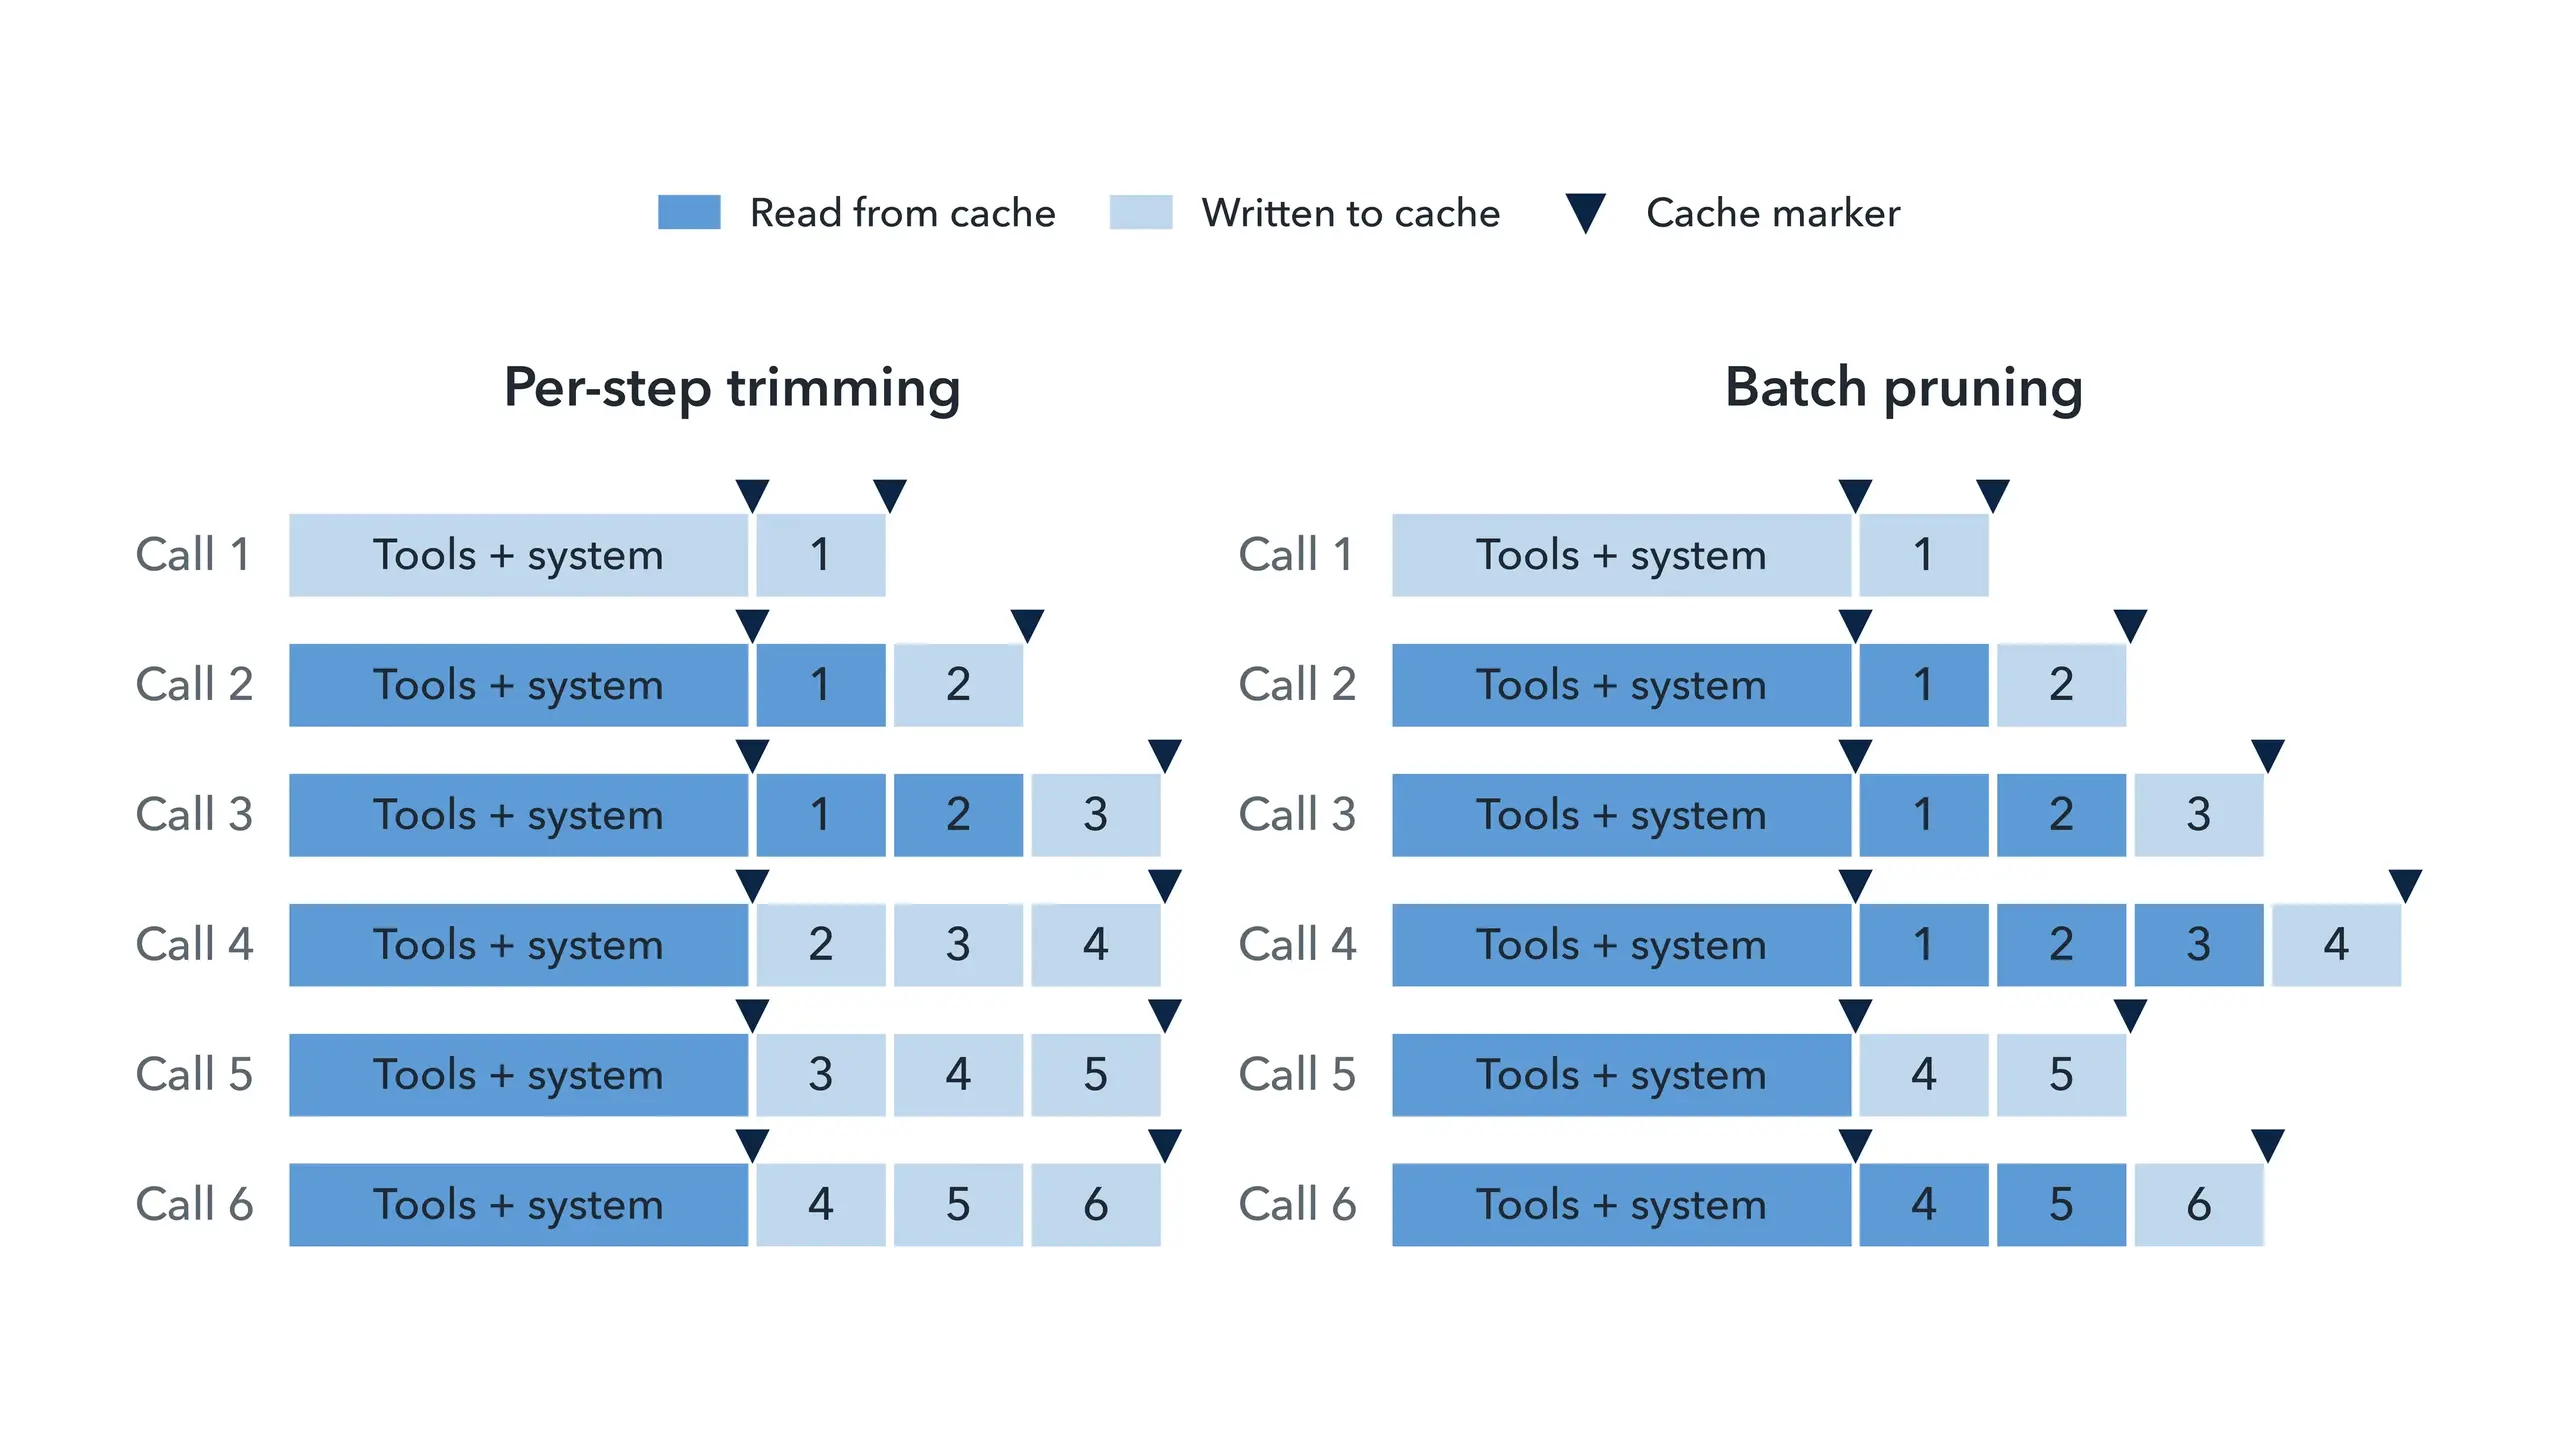
Um agente de navegador reenvia suas ferramentas, o comando do sistema e o histórico crescente de texto da página e capturas de tela a cada chamada. O cache de prompts reduz o custo de entradas repetidas: nos modelos que testamos, as leituras de cache custam de 0,05x a 0,1x o preço padrão de entrada. Mas um cache só reutiliza o prefixo mais longo de uma solicitação que não tenha sido alterado. O nosso agente armazenou em cache as suas ferramentas e o comando do sistema, mas não o seu histórico, e armazenar apenas o histórico em cache não teria ajudado: o agente removia a captura de tela anterior a cada etapa e reduzia o texto mais antigo para se ajustar ao limite de tamanho do histórico. Cada edição alterava uma parte anterior da solicitação, de modo que a reutilização falhava em quase todas as chamadas.
A solução
Primeiro, armazene também o histórico em cache, com um marcador de cache no resultado mais recente da ferramenta. Em segundo lugar, parar de editá-lo em todas as chamadas. A remoção em lote mantém as capturas de tela e as remove em lotes: na proporção de 20:1, o agente mantém até 20 e depois reduz para 1, de modo que cerca de 19 chamadas consecutivas reutilizam o histórico armazenado em cache. Também aumentamos o limite de caracteres do histórico de 120.000 para 480.000, para que o texto antigo não fosse mais cortado.

Como executamos o processo
O GPT-6 Astra, operando no Codex, fez a maior parte do trabalho: auditou o código, instrumentou todas as solicitações, executou testes rápidos para identificar as variáveis relevantes, refatorou o código para executar fluxos de trabalho em paralelo, iniciou as execuções e analisou os rastreamentos. Os humanos definiram a meta e os padrões e revisaram as conclusões. O Command, a plataforma de entrega de software da Asana, foi o sistema de registro: as solicitações, os rastreamentos e os resultados de cada sessão foram registrados nele, para que pudéssemos analisar o estudo completo posteriormente, e as conclusões se transformaram em tíquetes, pull requests e alterações revisadas que foram implementadas.


Nunca pensei em fazer isso manualmente, pois provavelmente teria levado meses. Com o Codex, levou cerca de uma semana: eu definia uma /meta antes de dormir e analisava os resultados pela manhã.
Agora, toda noite em que nossos agentes não estão em execução parece uma noite desperdiçada.
Testamos seis políticas de cache e histórico com dois orçamentos no GPT-6.1 Sol e em três outros modelos de ponta, os Modelos A, B e C (tabela abaixo), com três execuções por condição: 144 execuções, mais um acompanhamento de 12 execuções. Calculamos os custos a partir dos contadores de tokens de cada provedor, e cada resposta foi avaliada em relação a uma referência preparada de forma independente.
Modelo | O que é | Preço |
Modelo A | Um modelo menor e de menor custo de outro laboratório de ponta, lançado no segundo semestre de 2025 | Metade do preço do GPT-6.1 Sol |
Modelo B | O modelo originalmente usado na produção, do mesmo laboratório do Modelo A, lançado no segundo semestre de 2026 | Igual ao GPT-6.1 Sol |
Modelo C | Uma versão mais recente do Modelo B, lançada no outono de 2026 | Igual ao GPT-6.1 Sol |
GPT-6.1 Sol | Modelo da OpenAI | Referência |
Resultados

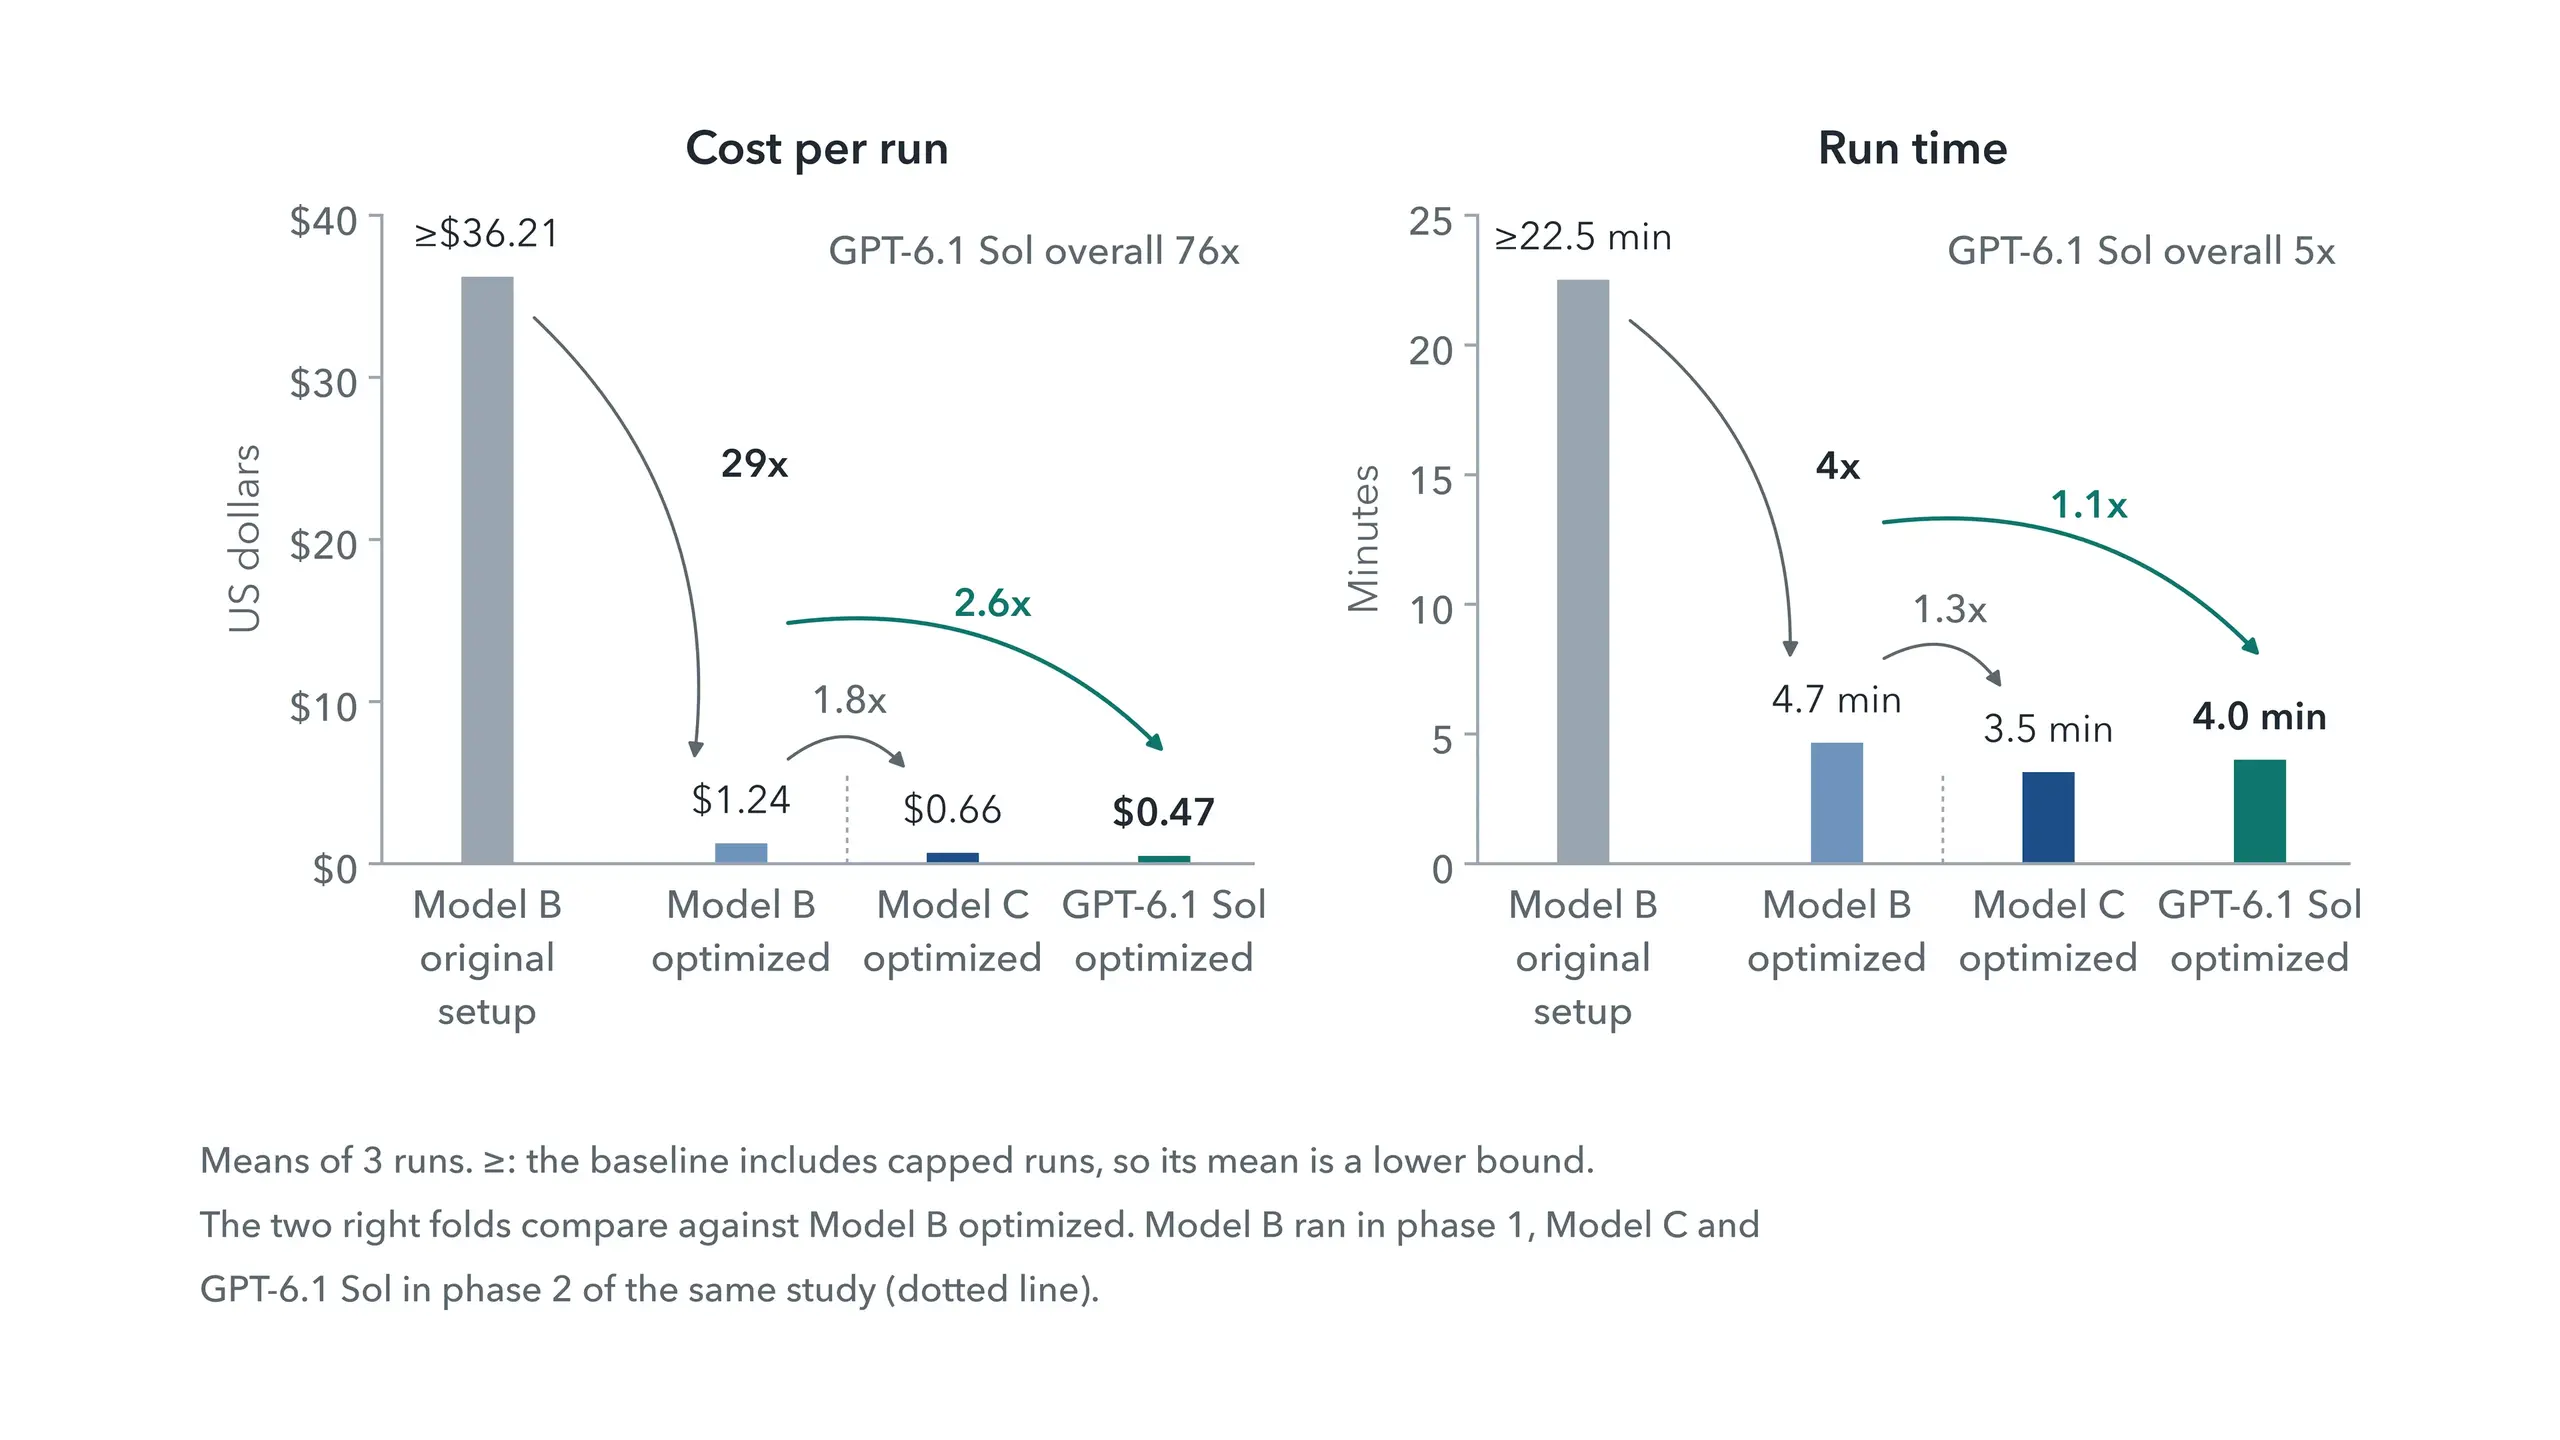
No Modelo B, a melhor condição reduziu o custo por execução em 29 vezes e foi 4 vezes mais rápida do que a configuração de produção original. No GPT-6.1 Sol, o mesmo agente custou 76 vezes menos e foi executado 5 vezes mais rápido, lendo 89 % de sua entrada a partir do cache. Em todos os modelos, cada execução na melhor condição custou menos do que cada execução de referência e encontrou todos os 192 fatos.
Lições aprendidas
O orçamento deve ser adequado ao modelo. Os modelos mais recentes consumiram o orçamento menor mais rapidamente: o Modelo C reduziu seu histórico pela primeira vez na chamada 10, e o Modelo A, na chamada 64. Com 120.000 caracteres, o Modelo C não respondeu em nenhuma das 18 execuções e o Sol respondeu em 3, sendo que a maioria atingiu o limite de etapas; com 480.000 caracteres, ambos responderam em todas as execuções.
O armazenamento em cache por si só não é suficiente. Sem a remoção em lote, armazenar o histórico em cache com o orçamento maior custou mais do que não armazená-lo em cache em três dos quatro modelos: o cache era continuamente regravado e raramente lido.
É preciso fazer o recorte?
Os dados por chamada sugeriram que a remoção poderia não ser necessária neste caso, por isso, um acompanhamento manteve todas as capturas de tela. O custo por chamada foi 1,2 vez menor do que na melhor condição para o Modelo B e o Sol, e cerca de 5 % menor para o Modelo C. A remoção ainda é importante para tarefas longas, janelas de contexto pequenas e leituras de cache mais caras.
Com três ou quatro execuções por condição e contagens de chamadas que variam entre as execuções, este estudo mostra padrões amplos, em vez de distinguir condições com diferenças de apenas alguns pontos percentuais.
Os limites ainda são importantes
Nenhuma execução atingiu o limite de 480.000 caracteres, portanto, ele não restringiu essas execuções. Os limites ainda são importantes: um agente que se desvia cresce em direção ao limite de contexto e, se o cache falhar, cada chamada paga o preço total. Os limites de etapas, tokens e custo por execução restringem o custo de uma execução ruim. A compactação é outra opção, que está fora do escopo deste estudo.
Das descobertas à produção
Algumas conclusões surgiram mais tarde, quando outros agentes revisaram todos os registros armazenados no Command. Isso é difícil de fazer a partir de uma única sessão, em que não é possível ter certeza de que todos os dados foram armazenados. Manter tudo no Command, que os nossos agentes acessavam por meio do MCP, significava que nunca precisávamos repetir um experimento para recuperar dados ausentes, o que acelerou o trabalho. As descobertas se tornaram tíquetes para humanos e agentes de programação, as pull requests foram revisadas lá e as alterações foram enviadas para a StackAI. Desde o estudo, também executamos a mesma tarefa com o Codex, que comparou a sua abordagem com a do agente da StackAI e sugeriu uma segunda rodada de melhorias, agora em forma de tíquetes no Command.
O que aprendemos
Armazene em cache o histórico crescente, não apenas o comando do sistema.
Mantenha o histórico apenas para acréscimos; quando for necessário fazer a limpeza, faça-a em lotes grandes.
Defina o orçamento do histórico para se adequar ao modelo.
Medir as leituras de cache por chamada usando os próprios contadores do provedor.
Mantenha um registro completo de cada sessão, para que a análise e o trabalho de acompanhamento usem o mesmo registro.
A Asana está desenvolvendo ferramentas para tornar experimentos como este uma rotina. O estudo completo abrange métodos, resultados e limitações.
A velocidade de entrega já não é o gargalo; a atenção humana é. Acho que estamos perto de um mundo em que todo engenheiro é um gerente de produto que lidera uma equipe de agentes.