Jak 76-krotnie obniżyliśmy koszty związane z agentem przeglądarki i sprawiliśmy, że działa on 5 razy szybciej, pozostawiając jego pamięć podręczną nienaruszoną


Badanie z wykorzystaniem GPT-6 Astra w Codex na czterech modelach, od analizy kodu po pomiar wyników


Dlaczego przeprowadziliśmy badanie
Asana wprowadza na swoją platformę automatyzację przepływów pracy agentów za pośrednictwem StackAI, a na skalę Asany nawet niewielkie niedociągnięcia mogą się kumulować. Naszym celem było sprawienie, aby jeden agent przeglądarki był tańszy i szybszy, bez obniżania jakości odpowiedzi.
„Tak właśnie wyglądają w praktyce zespoły ludzi i agentów. Inżynier wyznaczył kierunek, agent przeprowadził eksperymenty, a wyniki zostały przekazane przez Command do środowiska produkcyjnego. To pokazuje, w jaki sposób Asana tworzy zespoły złożone z ludzi i agentów”. – Arnab Bose, dyrektor ds. produktu w Asanie
Co było nie tak
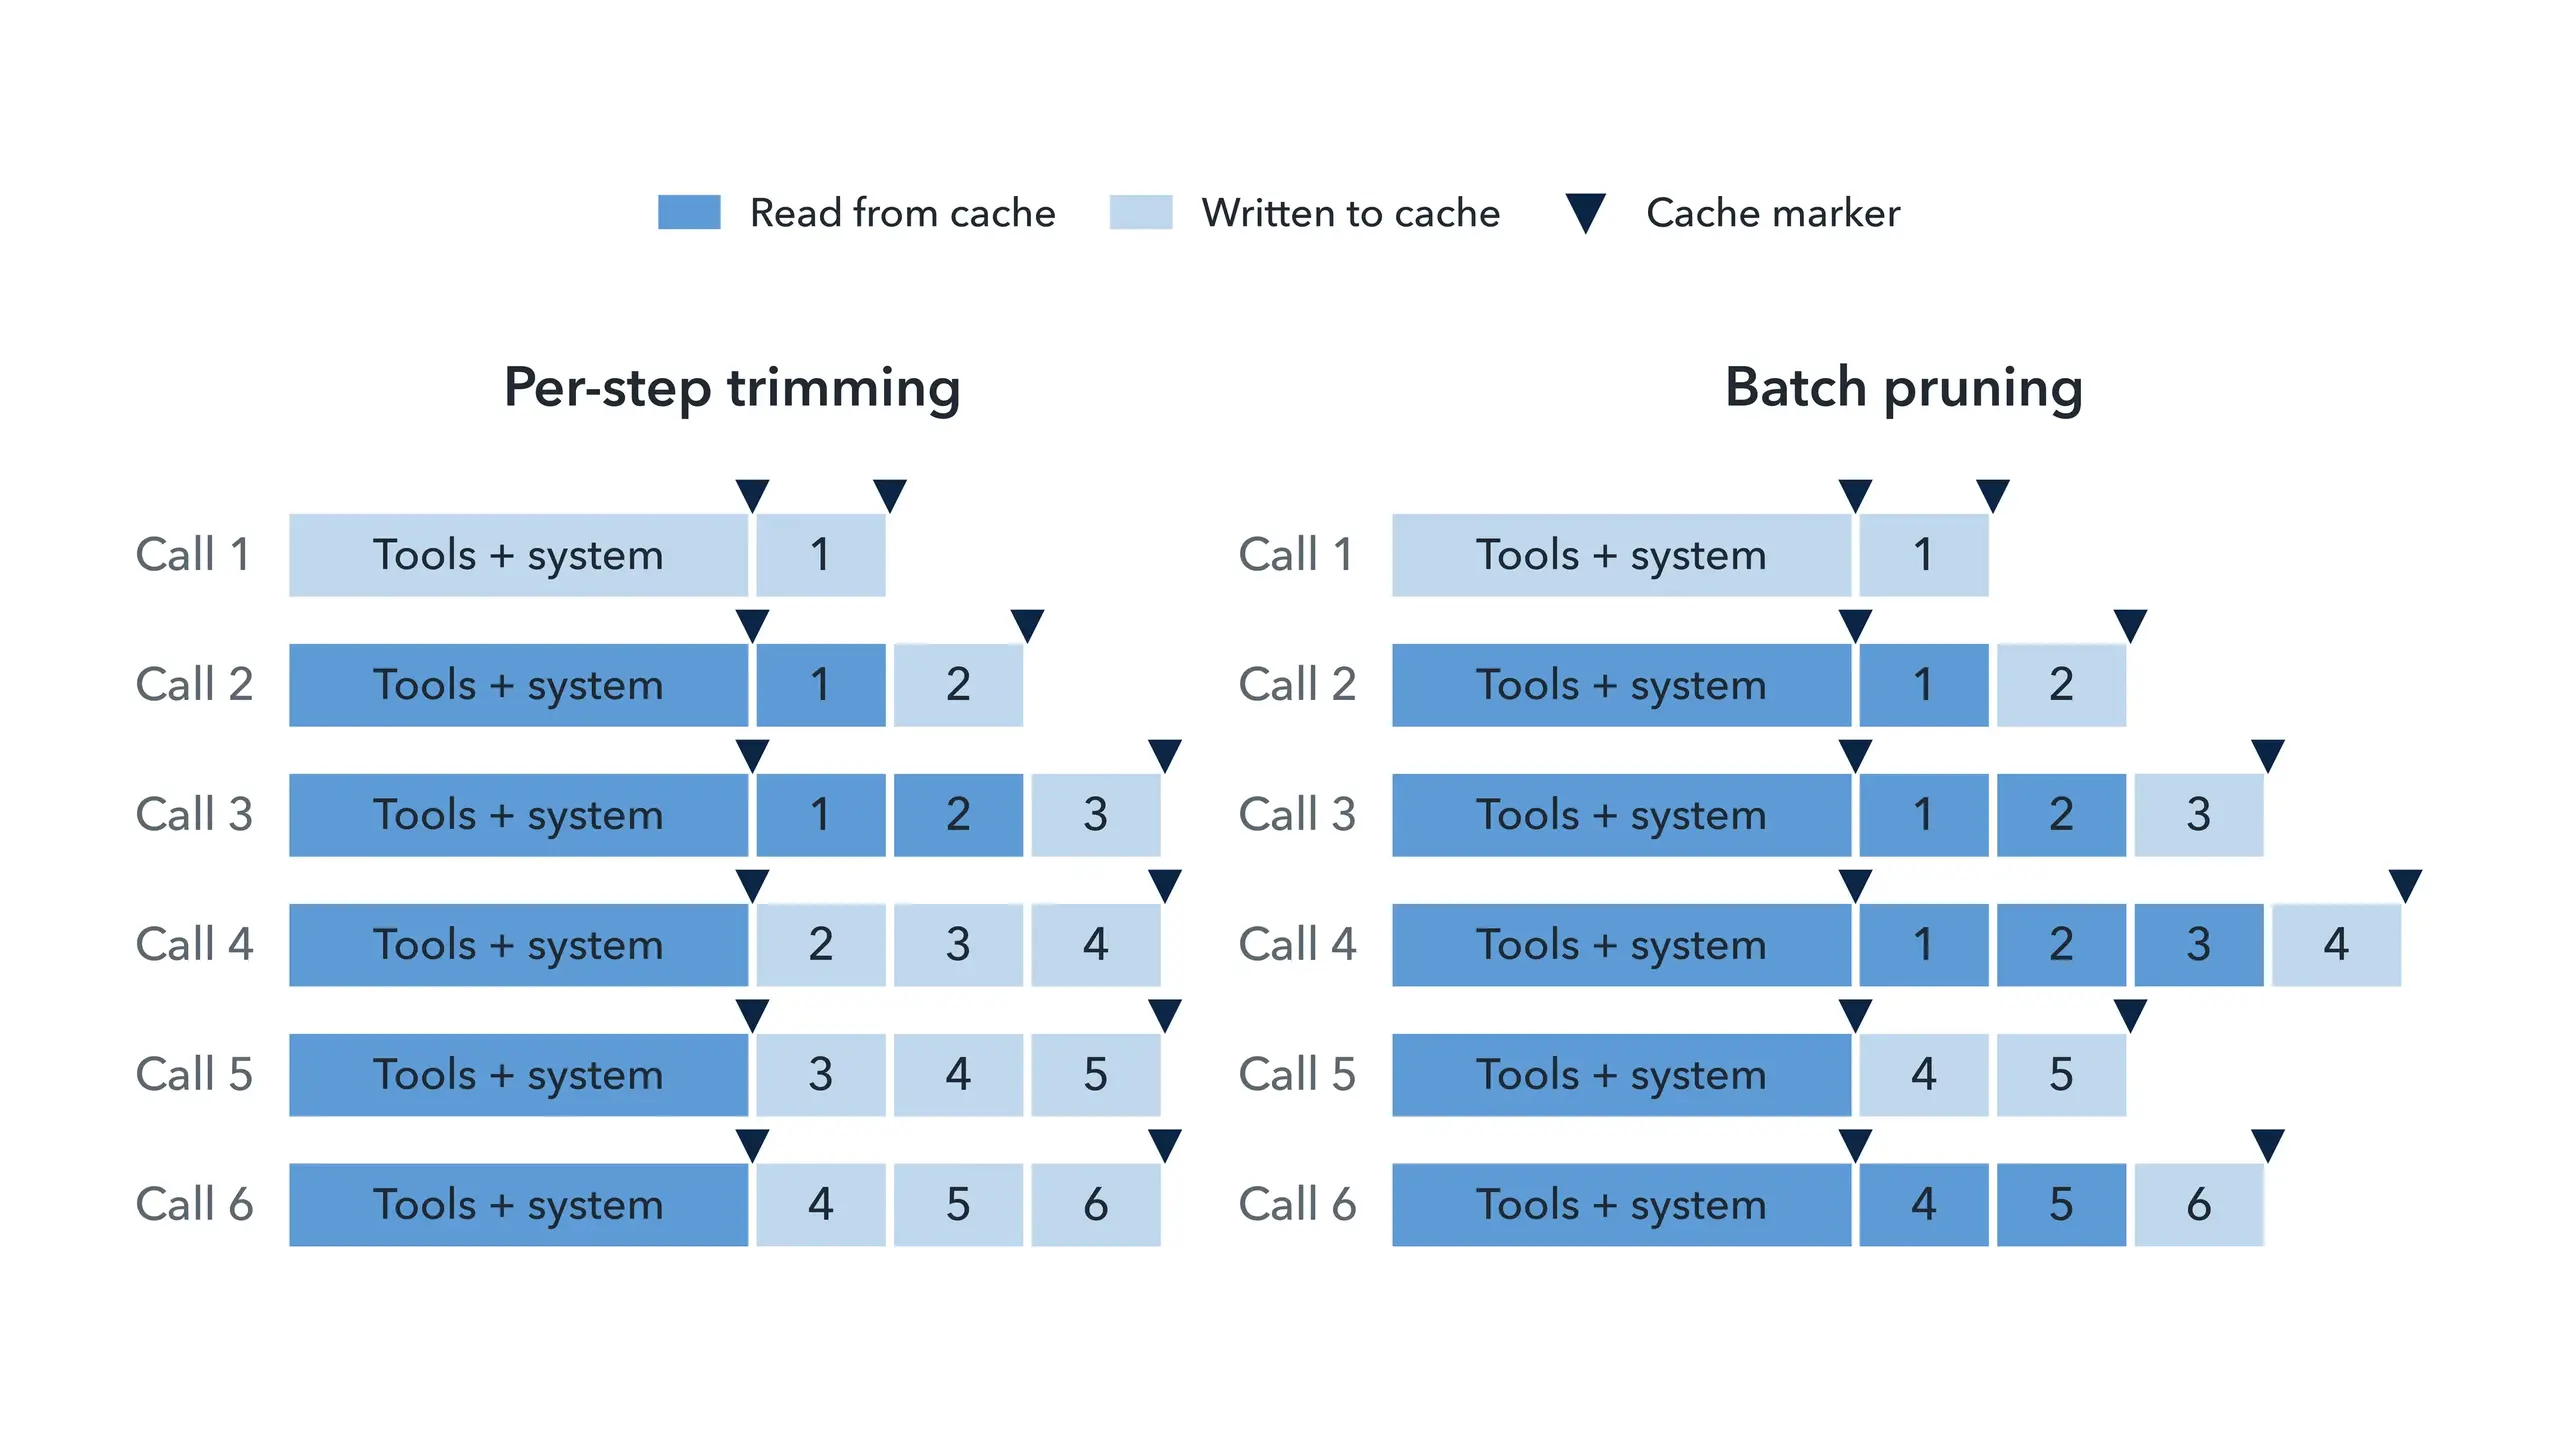
Agent przeglądarki przy każdym wywołaniu ponownie wysyła swoje narzędzia, monit systemowy oraz rosnącą historię tekstu strony i zrzutów ekranu. Buforowanie monitów obniża koszt powtarzających się danych wejściowych: w testowanych przez nas modelach odczyty z pamięci podręcznej kosztują od 0,05x do 0,1x standardowej ceny danych wejściowych. Jednak pamięć podręczna ponownie wykorzystuje tylko najdłuższy niezmieniony prefiks zlecenia. Nasz agent zapisywał w pamięci podręcznej swoje narzędzia i monit systemowy, ale nie historię, a samo zapisywanie historii w pamięci podręcznej nie pomogłoby: agent usuwał poprzedni zrzut ekranu na każdym etapie i skracał starszy tekst, aby zmieścił się w limicie historii. Każda edycja zmieniała wcześniejszą część żądania, więc ponowne użycie nie działało przy prawie każdym wywołaniu.
Rozwiązanie
Najpierw należy również zapisać w pamięci podręcznej historię, dodając znacznik pamięci podręcznej do najnowszego wyniku działania narzędzia. Po drugie, przestań edytować historię przy każdym wywołaniu. Usuwanie partiami polega na zachowywaniu zrzutów ekranu i usuwaniu ich partiami: przy proporcji 20:1 agent zachowuje do 20 zrzutów, a następnie redukuje ich liczbę do 1, więc podczas około 19 kolejnych wywołań ponownie wykorzystywana jest historia zapisana w pamięci podręcznej. Zwiększyliśmy również limit znaków w historii z 120 000 do 480 000, dzięki czemu stary tekst nie był już przycinany.

Jak to przeprowadziliśmy
GPT-6 Astra, działający w środowisku Codex, wykonał większość pracy: przeprowadził audyt kodu, instrumentował każde żądanie, przeprowadził szybkie testy w celu zidentyfikowania istotnych zmiennych, zrefaktorował kod, aby umożliwić równoległe wykonywanie przepływów pracy, uruchomił wykonania i przeanalizował ślady. Ludzie wyznaczyli cel i standardy oraz zweryfikowali wnioski. Command, platforma Asany do dostarczania oprogramowania, pełniła rolę systemu dokumentacji: rejestrowano w niej żądania, ślady i wyniki każdej sesji, dzięki czemu mogliśmy później przeanalizować całe badanie, a ustalenia stały się zgłoszeniami, pull requestami i zweryfikowanymi zmianami, które zostały wdrożone.


Nigdy nie przyszło mi do głowy, żeby zrobić to ręcznie, ponieważ prawdopodobnie zajęłoby mi to miesiące. Dzięki Codexowi zajęło to około tygodnia: przed pójściem spać wyznaczałem /cel, a rano przeglądałem wyniki.
Teraz każda noc, w której nasze agenty nie działają, wydaje się być zmarnowaną nocą.
Przetestowaliśmy sześć zasad dotyczących buforowania i historii przy dwóch budżetach na modelu GPT-6.1 Sol oraz na trzech innych modelach najnowszej generacji – modelach A, B i C (tabela poniżej), przeprowadzając po trzy uruchomienia dla każdego warunku: 144 uruchomienia plus 12 uruchomień w ramach działań uzupełniających. Koszty obliczyliśmy na podstawie liczników tokenów każdego dostawcy, a każdą odpowiedź oceniliśmy w odniesieniu do niezależnie przygotowanego wzorca.
Model | Co to jest | Cena |
Model A | Mniejszy, tańszy model z innego laboratorium zajmującego się badaniami przełamującymi granice, wydany jesienią 2025 r. | Połowa ceny GPT-6.1 Sol |
Model B | Model pierwotnie używany w środowisku produkcyjnym, pochodzący z tego samego laboratorium co model A, wydany latem 2026 roku | Taka sama jak GPT-6.1 Sol |
Model C | Nowsza wersja modelu B, wydana jesienią 2026 roku | Taki sam jak GPT-6.1 Sol |
GPT-6.1 Sol | Model OpenAI | Odniesienie |
Wyniki

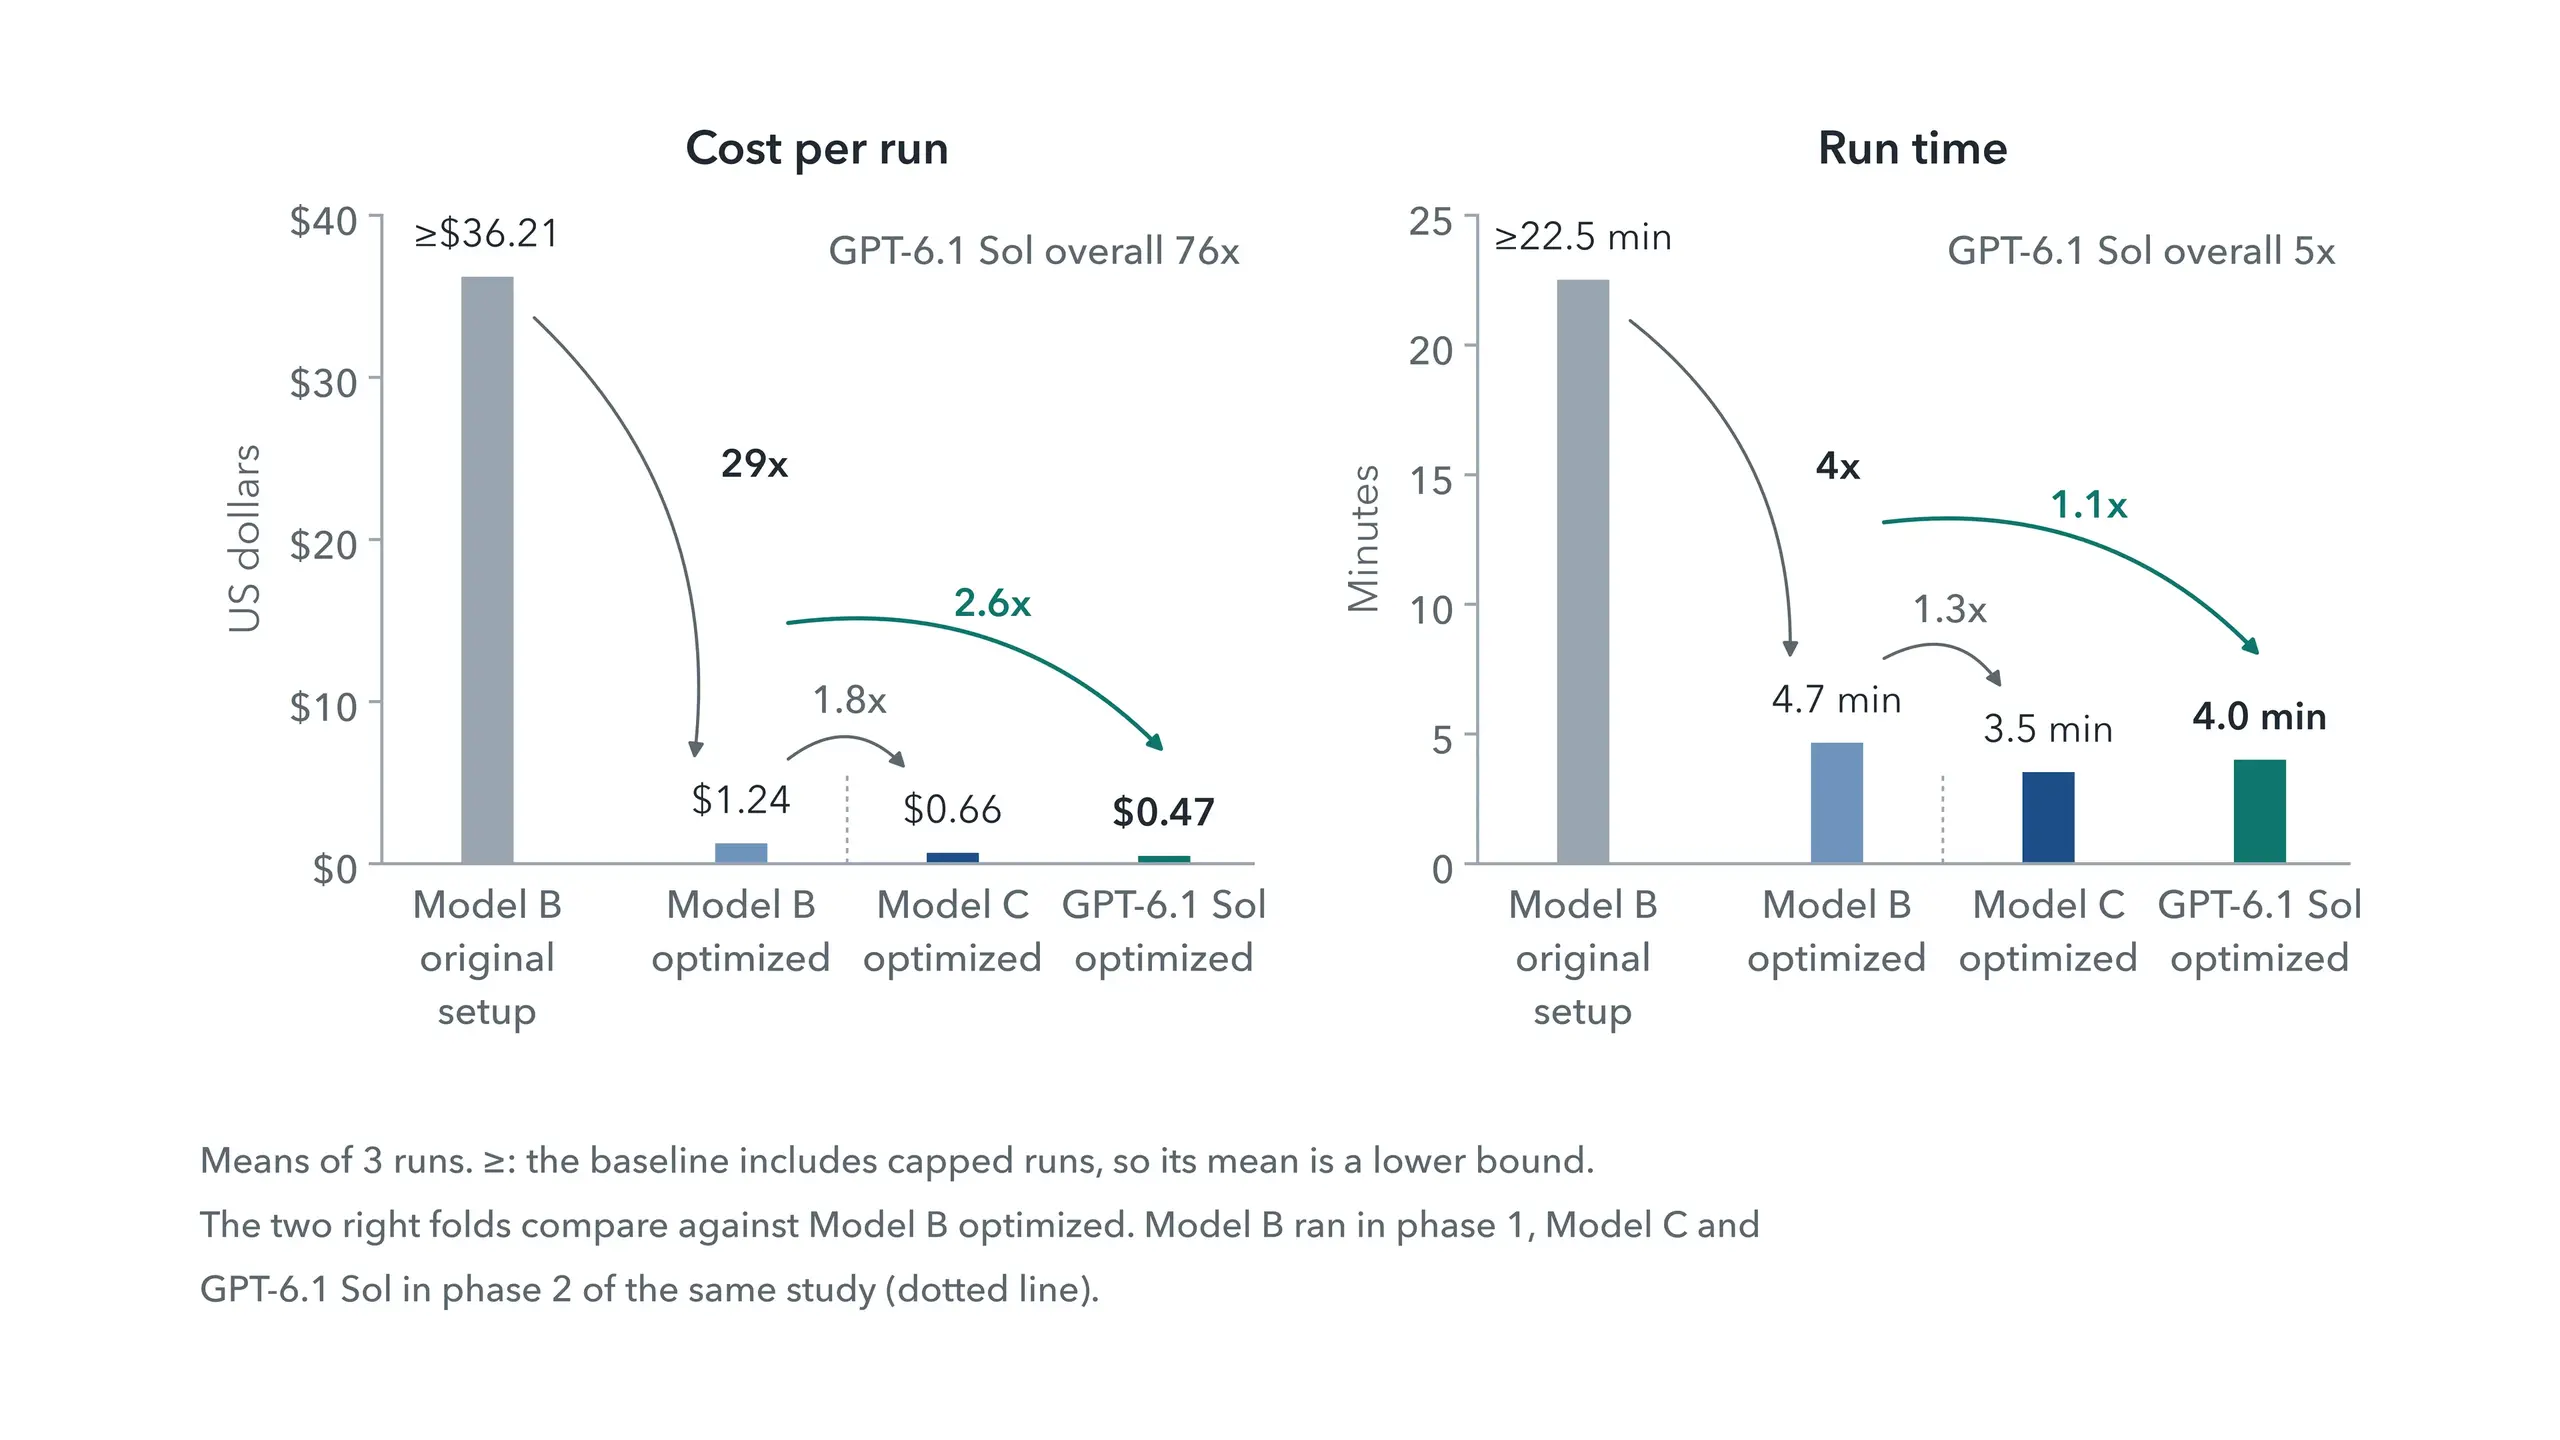
W przypadku modelu B najlepszy warunek obniżył koszt na uruchomienie 29-krotnie i zapewnił 4-krotnie szybsze działanie w porównaniu z pierwotną konfiguracją produkcyjną. W przypadku modelu GPT-6.1 Sol ten sam agent kosztował 76 razy mniej i działał 5 razy szybciej, odczytując 89% danych wejściowych z pamięci podręcznej. W przypadku każdego modelu każde uruchomienie w najlepszych warunkach kosztowało mniej niż każde uruchomienie w warunkach bazowych i obejmowało wszystkie 192 fakty.
Wnioski
Budżet musi być dopasowany do modelu. Nowsze modele szybciej wyczerpywały mniejszy budżet: model C po raz pierwszy skrócił swoją historię przy wywołaniu nr 10, a model A – przy wywołaniu nr 64. Przy 120 000 znaków model C nie udzielił odpowiedzi w żadnym z 18 uruchomień, a model Sol – w 3 uruchomieniach, przy czym w większości przypadków osiągnięto limit kroków; przy 480 000 znaków oba modele udzieliły odpowiedzi w każdym uruchomieniu.
Samo buforowanie nie wystarcza. Bez przycinania partii buforowanie historii przy większym budżecie kosztowało więcej niż jego brak w przypadku trzech z czterech modeli: pamięć podręczna była stale nadpisywana i rzadko odczytywana.
Czy w ogóle potrzebne jest przycinanie?
Dane dotyczące poszczególnych wywołań sugerowały, że w tym przypadku usuwanie może nie być konieczne, dlatego w ramach dalszych działań zachowano każdy zrzut ekranu. Koszt na wywołanie był 1,2 raza niższy niż w najlepszym warunku w przypadku modelu B i Sol oraz około 5% niższy w przypadku modelu C. Usuwanie nadal ma znaczenie w przypadku długich zadań, małych okien kontekstowych i droższych operacji odczytu z pamięci podręcznej.
Przy trzech lub czterech uruchomieniach na warunek i liczbie wywołań różniącej się między uruchomieniami badanie to pokazuje ogólne wzorce, a nie rozróżnia warunków różniących się od siebie tylko o kilka procent.
Ograniczenia nadal mają znaczenie
Żadne uruchomienie nie osiągnęło limitu 480 000 znaków, więc nie stanowiło to ograniczenia dla tych uruchomień. Limity nadal mają znaczenie: agent, który się rozjeżdża, zbliża się do limitu kontekstu, a jeśli pamięć podręczna przestanie działać, każde wywołanie będzie wiązało się z pełną opłatą. Limity dotyczące kroków, tokenów i kosztu na uruchomienie ograniczają koszt nieudanego uruchomienia. Kompaktowanie to kolejna opcja, wykraczająca poza zakres niniejszego badania.
Od ustaleń do wdrożenia
Niektóre ustalenia pojawiły się później, gdy inne agenty przeanalizowały każdy ślad zarejestrowany w Command. Jest to trudne do wykonania w ramach jednej sesji, w przypadku której nie można mieć pewności, że wszystkie dane zostały zapisane. Przechowywanie wszystkich informacji w Command, do którego nasi agenci mieli dostęp za pośrednictwem MCP, oznaczało, że nigdy nie musieliśmy powtarzać eksperymentu w celu odzyskania brakujących danych, co przyspieszyło pracę. Ustalenia stały się zgłoszeniami dla ludzi i agentów kodujących, tam też sprawdzano pull requesty, a zmiany były wysyłane do StackAI. Po zakończeniu badania wykonaliśmy również to samo zadanie przy użyciu Codexa, który porównał swoje podejście z podejściem agenta StackAI i zasugerował drugą rundę ulepszeń, teraz w postaci zgłoszeń w Command.
Czego się nauczyliśmy
Przechowuj w pamięci podręcznej rosnącą historię, a nie tylko monit systemowy.
Utrzymuj historię w trybie tylko dołączania; gdy konieczne jest usuwanie danych, rób to w dużych partiach.
Ustaw budżet historii odpowiednio do modelu.
Mierz liczbę odczytów z pamięci podręcznej na każde wywołanie, korzystając z własnych liczników dostawcy.
Prowadź pełny rejestr każdej sesji, aby analiza i dalsze prace opierały się na tym samym rejestrze.
Asana tworzy narzędzia, dzięki którym takie eksperymenty staną się rutyną. Pełne badanie obejmuje metody, wyniki i ograniczenia.
Szybkość dostawy nie jest już wąskim gardłem; takim wąskim gardłem jest ludzka uwaga. Myślę, że jesteśmy blisko świata, w którym każdy inżynier jest kierownikiem projektu zarządzającym zespołem agentów.