キャッシュをそのままにして、ブラウザーエージェントのコストを 76 分の 1 に削減し、5 倍高速化した方法


コードの調査から結果の測定まで、Codex で GPT-6 Astra を使用した 4 つのモデルに関する調査


調査の目的
Asana は、StackAI を通じてエージェントのワークフローのオートメーションをプラットフォームに導入しています。Asana の規模では、小さな非効率性が積み重なっていきます。 私たちの目標は、回答の質を落とすことなく、ブラウザーエージェント 1 つ分のコストを削減し、処理速度を向上させることでした。
「これが、人間とエージェントのチームが実際にどのように機能するかを示しています。 エンジニアが方向性を定め、エージェントが実験を行い、結果は Command を経由して本番環境に反映されました。 これは、Asana がどのように人と AI エージェントの協働を実現しているかを示すものです。」- Arnab Bose、Asana 最高製品責任者
問題点
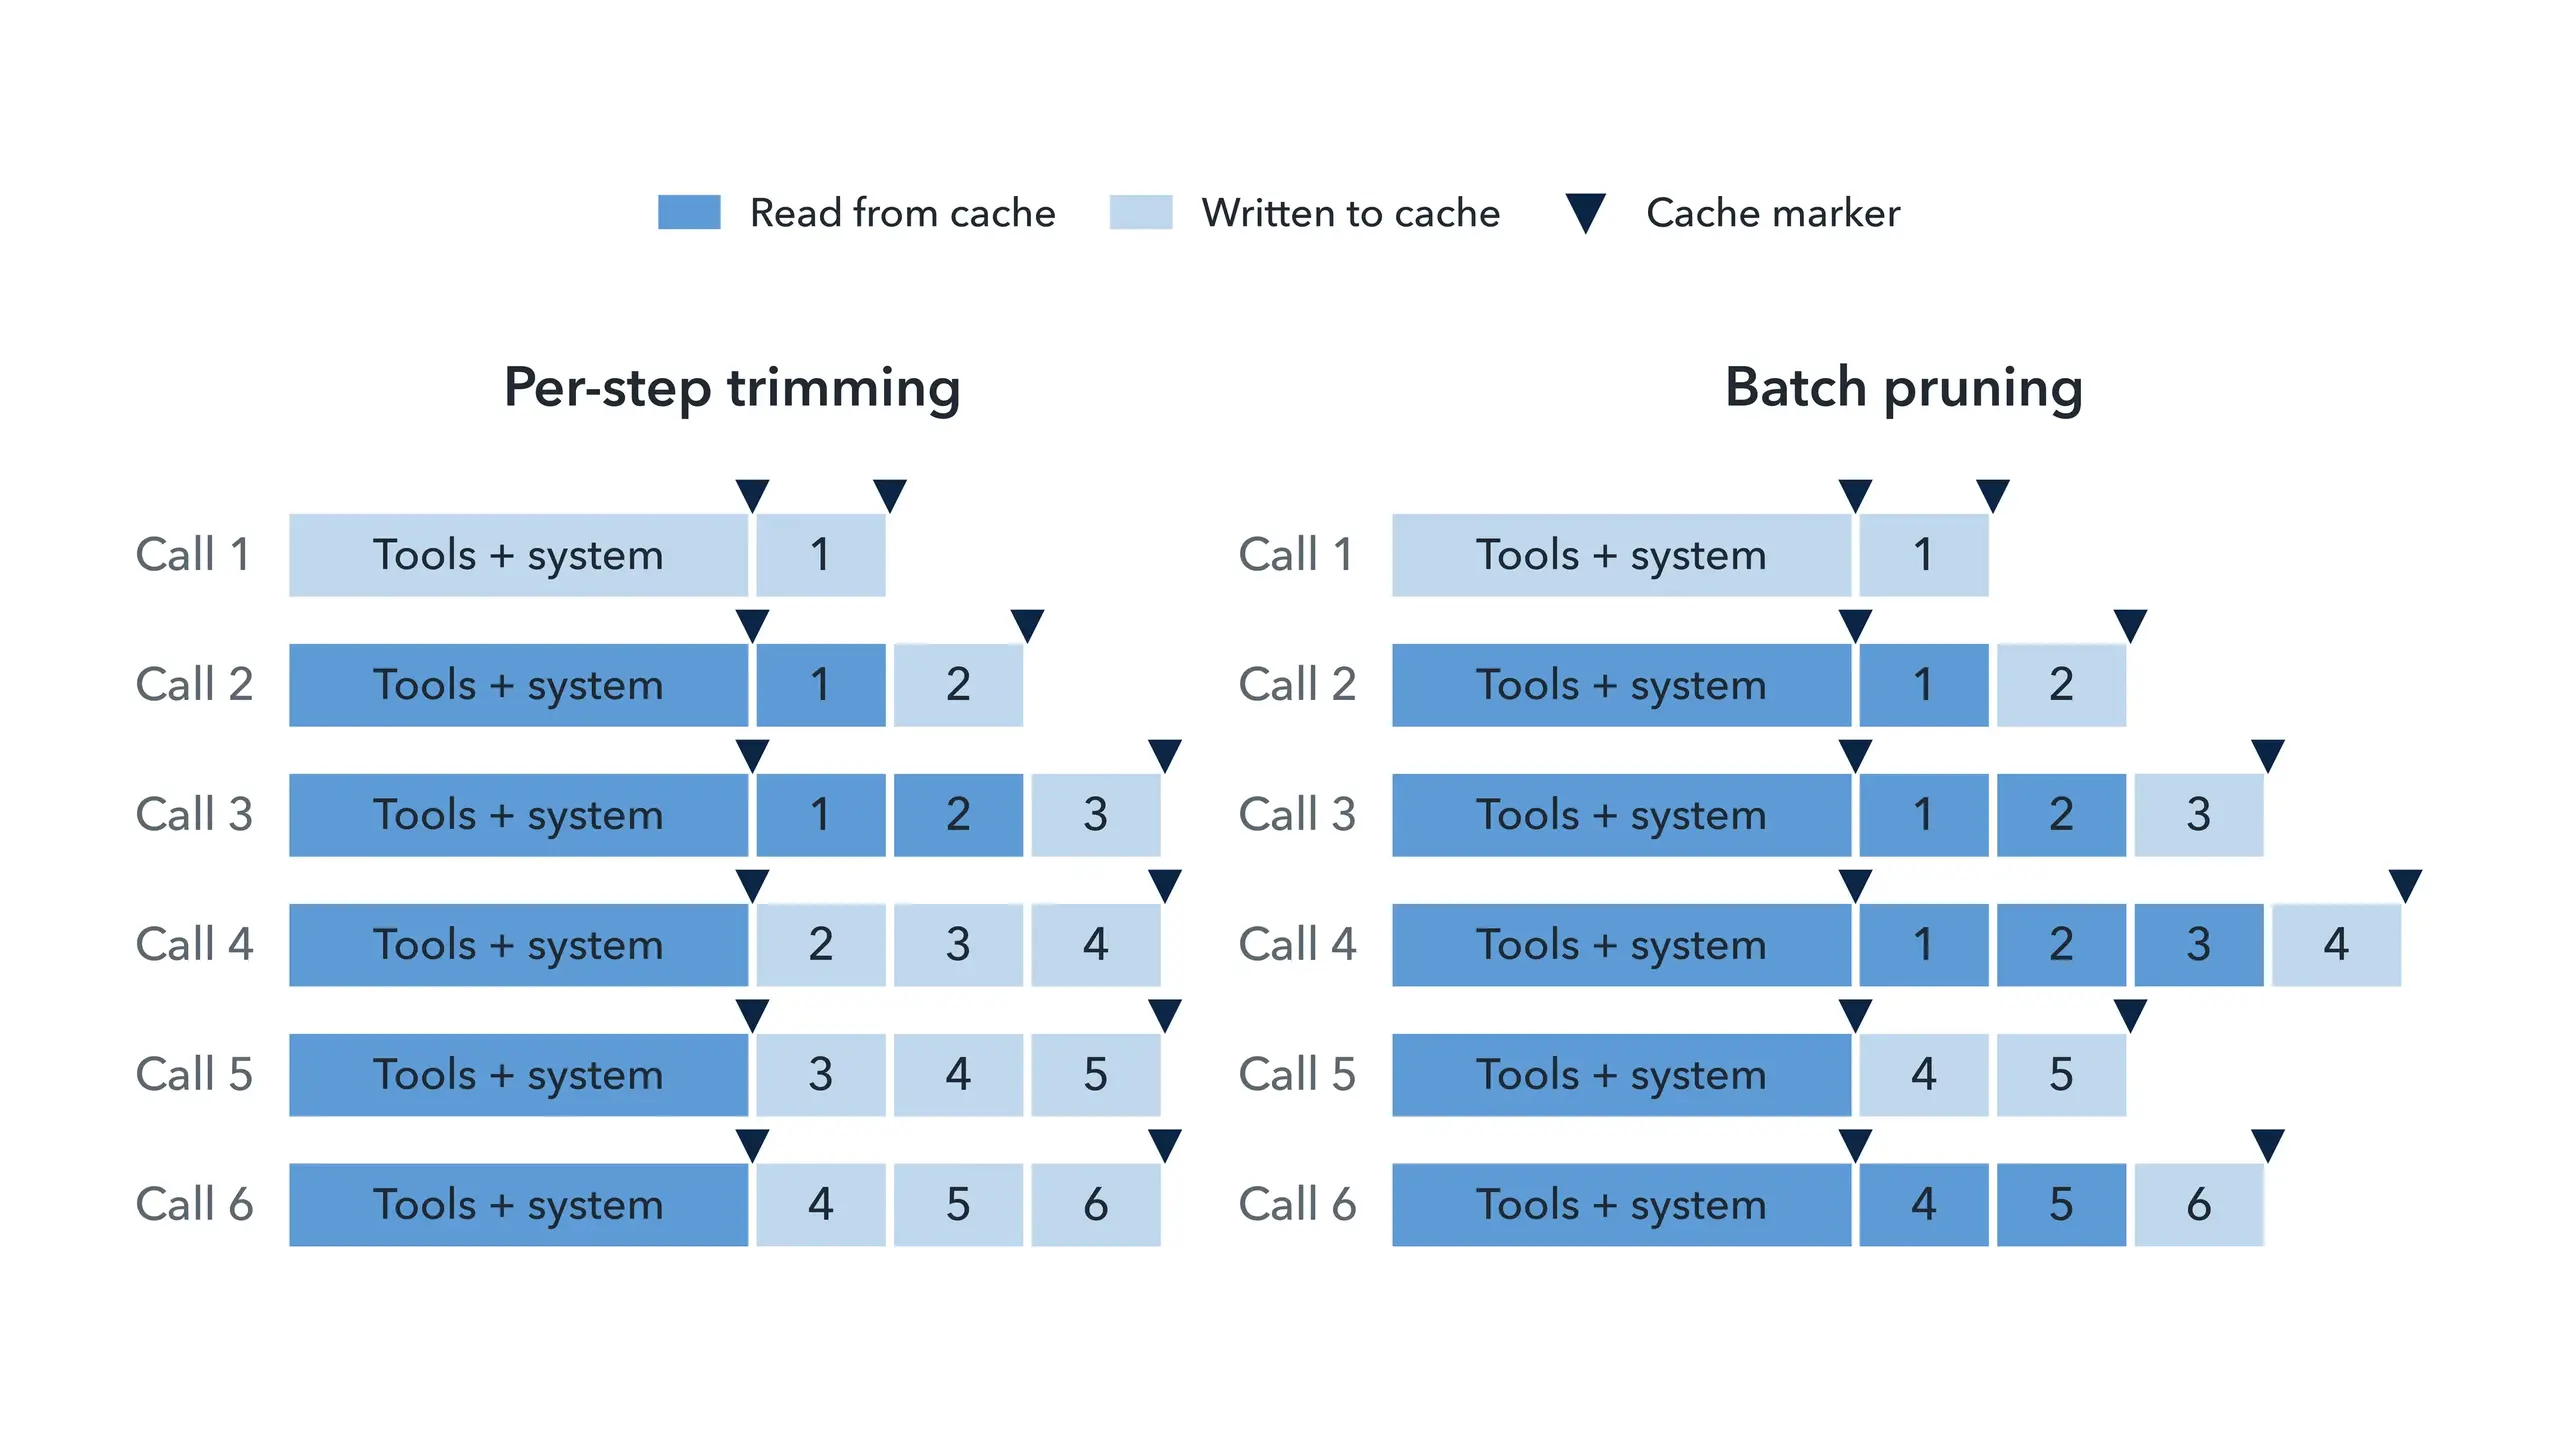
ブラウザーエージェントは、すべての呼び出しにおいて、ツール、システムプロンプト、およびページテキストとスクリーンショットの増加する履歴を再送信します。 プロンプトキャッシュを使用すると、繰り返し入力する際のコストが削減されます。当社がテストしたモデルでは、キャッシュ読み取りのコストは標準の入力コストの 0.05~0.1 倍でした。 ただし、キャッシュはリクエストの中で最も長く変更されていないプレフィックスのみを再利用します。 当社のエージェントは、ツールとシステムプロンプトをキャッシュしていましたが、履歴はキャッシュしていませんでした。また、履歴だけをキャッシュしても意味がありませんでした。エージェントはすべてのステップで前のスクリーンショットを削除し、履歴の予算に収まるように古いテキストをトリミングしていたからです。 編集が行われるたびにリクエストの前半部分が変更されたため、ほぼすべての呼び出しで再利用が機能しませんでした。
修正策
まず、履歴もキャッシュし、最新のツール結果にキャッシュマーカーを付けます。 2 つ目は、すべてのコールで履歴を編集しないことです。 バッチプルーニングは、スクリーンショットを保持し、バッチで削除します。20:1 の場合、エージェントは最大 20 枚を保持し、その後 1 枚に削減するため、約 19 回の連続した呼び出しでキャッシュされた履歴が再利用されます。 また、履歴の予算を 120,000 文字から 480,000 文字に引き上げたため、古いテキストがトリミングされることはなくなりました。

実行方法
Codex で動作する GPT-6 Astra がほとんどの作業を担当しました。コードの監査、すべてのリクエストの計測、重要な変数を特定するためのクイックテストの実行、ワークフローを並行して実行するためのコードのリファクタリング、実行の開始、トレースの分析を行いました。 人間が目標と基準を設定し、結論をレビューしました。 Asana のソフトウェアデリバリープラットフォームであるCommand が記録システムとして機能しました。各セッションのリクエスト、トレース、結果がそこに記録されたため、後で調査全体を分析することができました。また、調査結果はチケット、プルリクエスト、レビュー済みの変更としてリリースされました。


手作業で行うことは考えもしませんでした。おそらく数か月はかかったでしょう。 Codex を使用した場合は、約 1 週間かかりました。就寝前に /goal を設定し、朝に結果を確認しました。
今では、エージェントが稼働していない夜は、無駄な夜のように感じられます。
GPT-6.1 Sol と他の 3 つの最先端モデル (モデル A、B、C。下表を参照) を使用し、2 つの予算で 6 つのキャッシュおよび履歴ポリシーをテストしました。各条件で 3 回実行し、合計 144 回の実行と、さらに 12 回のフォローアップ実行を行いました。 各プロバイダーのトークンカウンターからコストを算出し、すべての回答を独立して用意されたリファレンスに照らしてスコア化しました。
モデル | 詳細 | 料金 |
モデルA | 2025年秋季にリリースされた、別の最先端ラボによるより小規模で低コストのモデル | GPT-6.1 Sol の価格の半分 |
モデル B | モデル A と同じラボが開発し、2026年夏にリリースされた、元々本番環境で使用されていたモデル | GPT-6.1 Solと同じ |
モデル C | モデル B の新バージョン。2026年秋にリリース | GPT-6.1 Solと同じ |
GPT-6.1 Sol | OpenAIのモデル | リファレンス |
成果

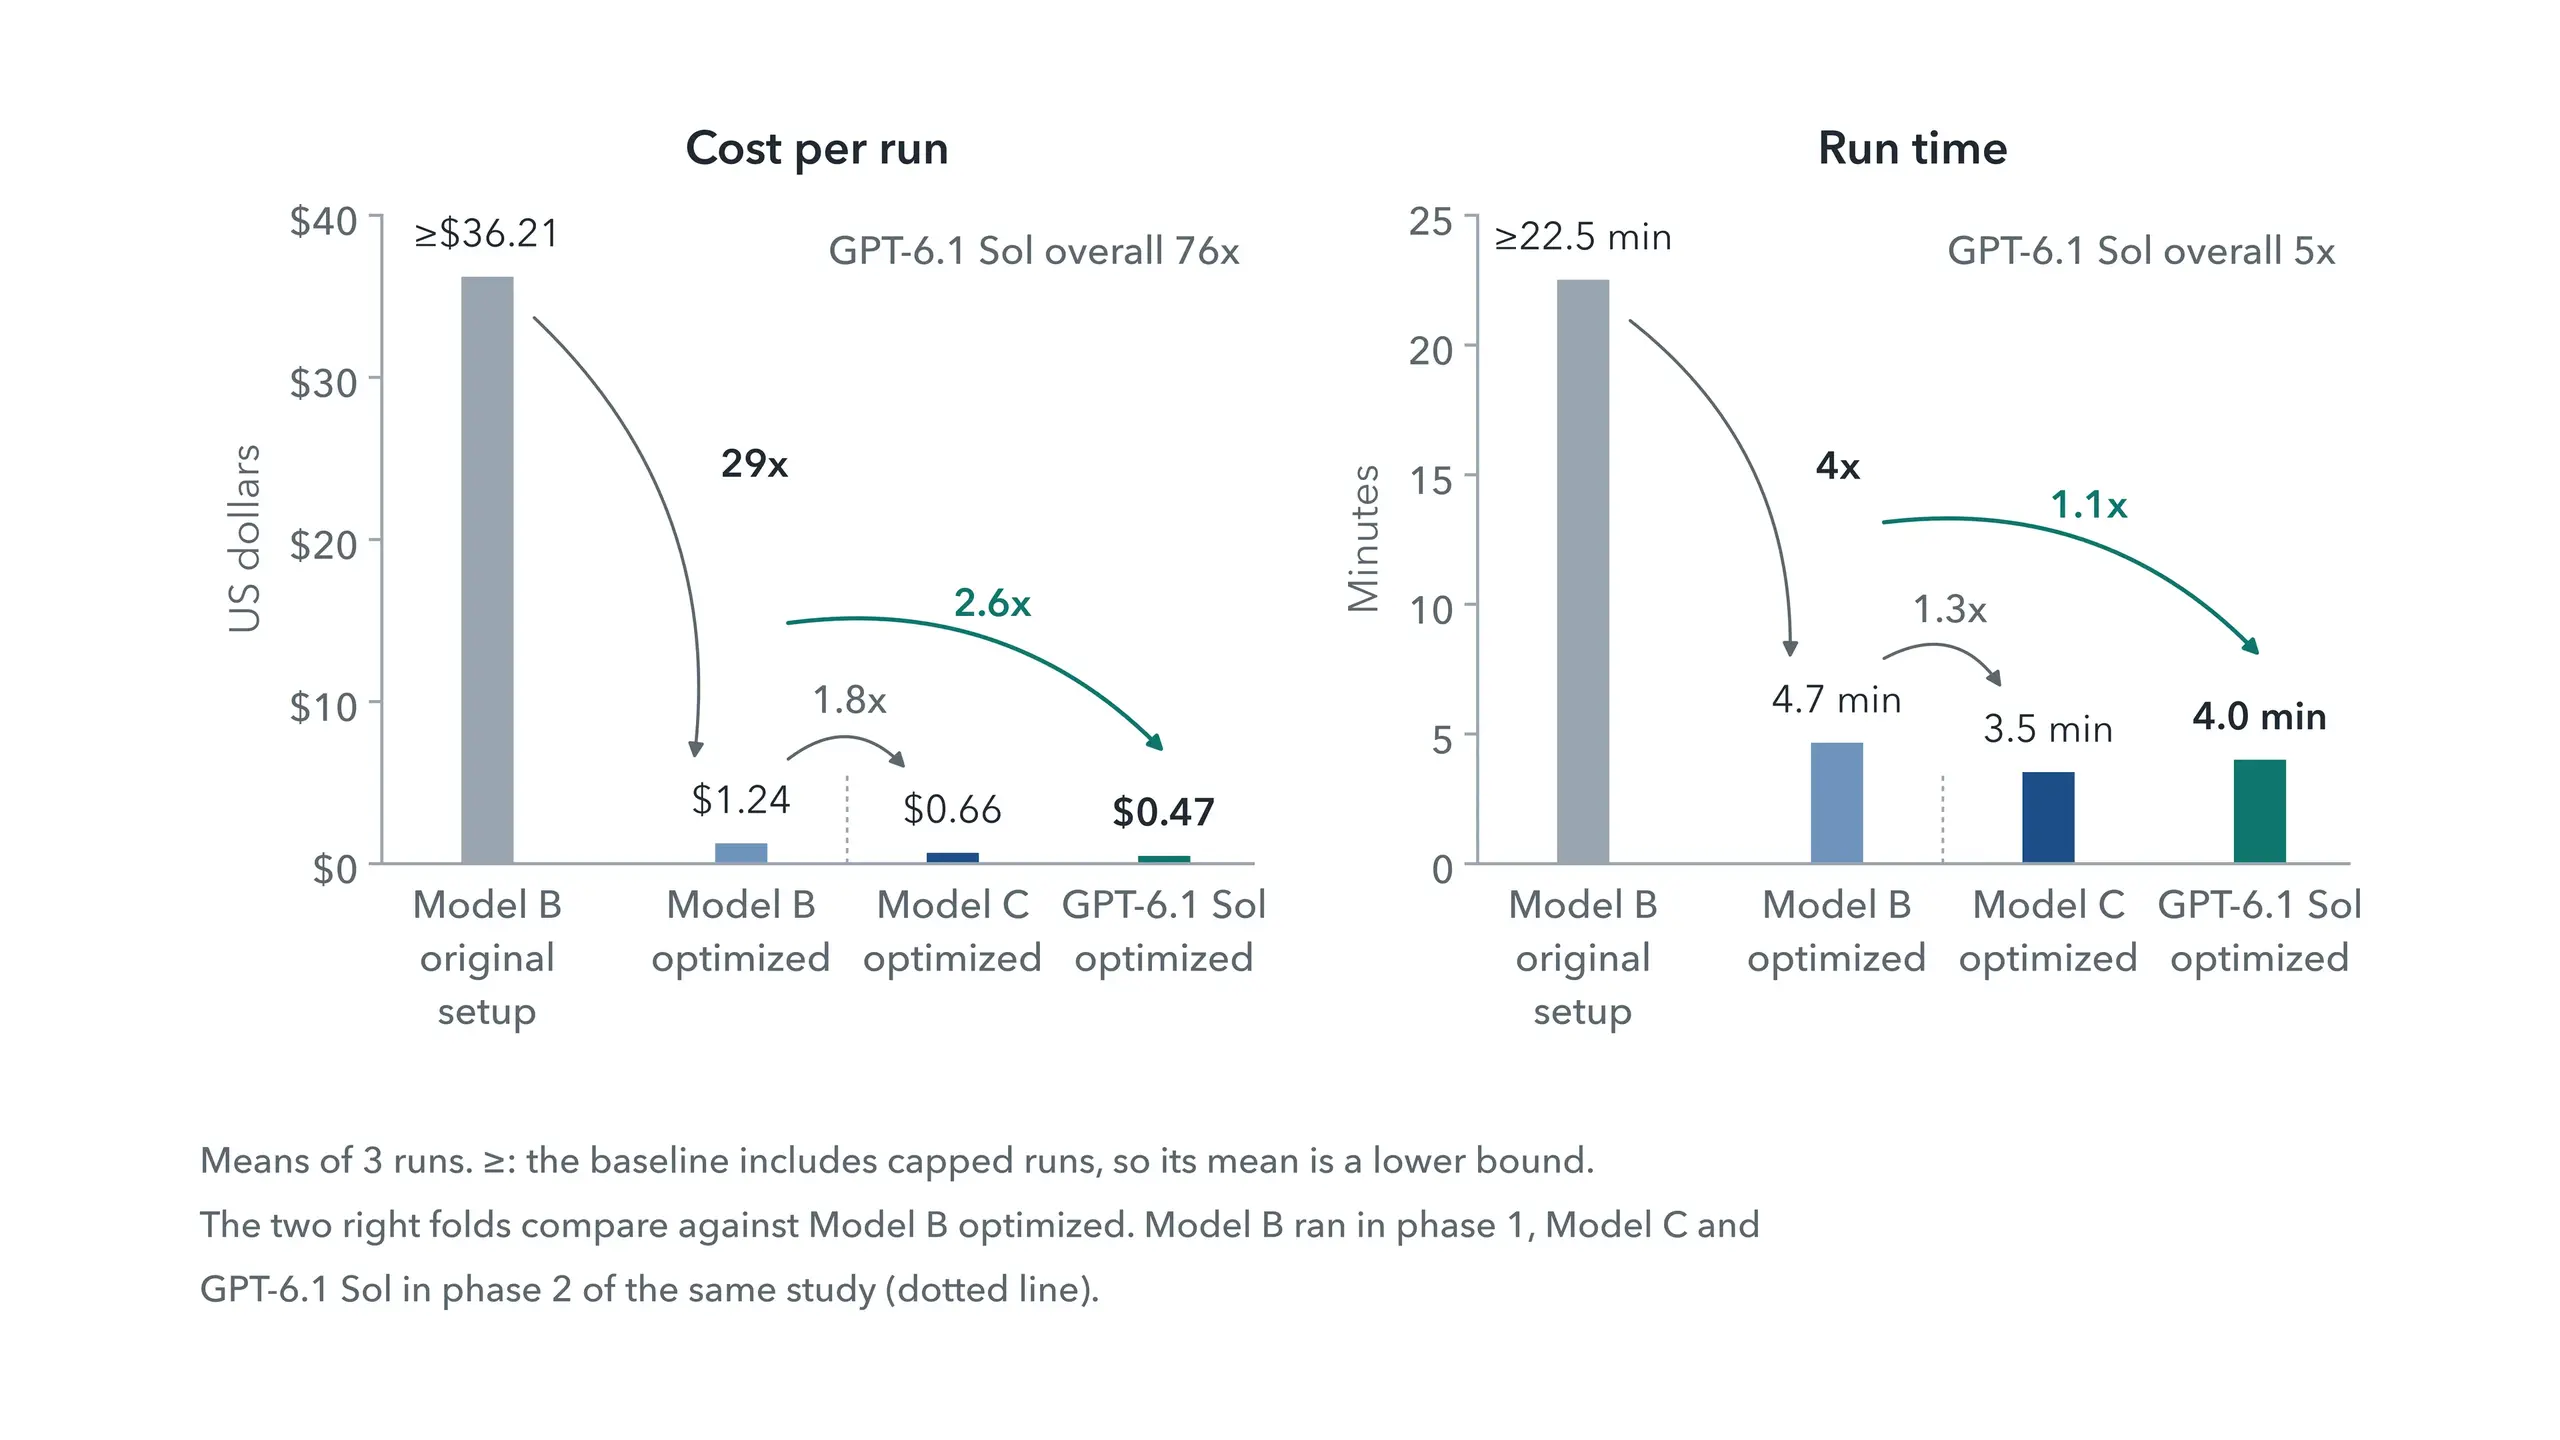
モデル B では、最適な条件で実行あたりのコストが 29 分の 1 に削減され、元の本番環境の設定よりも 4 倍速く実行されました。 GPT-6.1 Sol では、同じエージェントのコストが 76 分の 1 に削減され、実行速度が 5 倍向上し、インプットの 89% をキャッシュから読み取りました。 すべてのモデルにおいて、最適な条件での実行はすべて、ベースラインでの実行よりもコストが低く、192 件の事実すべてに遭遇しました。
学び
予算はモデルに合わせる必要があります。 新しいモデルほど、少ない予算をより早く使い切りました。モデルCはコール10で最初に履歴をトリミングし、モデルAはコール64でトリミングしました。 120,000文字では、モデルCは18回の実行のうち1回も回答せず、Solは3回回答し、ほとんどがステップ制限に達しました。480,000文字では、両方のモデルで毎回回答しました。
キャッシュだけでは不十分です。 バッチプルーニングを行わない場合、4つのモデルのうち3つでは、より大きな予算で履歴をキャッシュすることが、キャッシュしない場合よりもコストがかかりました。キャッシュは継続的に上書きされ、読み取られることはほとんどありませんでした。
そもそもプルーニングは必要か?
コールごとのデータによると、ここではプルーニングは必要ない可能性が示唆されたため、フォローアップではすべてのスクリーンショットを保持しました。 1 回の呼び出しあたりのコストは、モデル B と Sol の最良の条件と比較して 1.2 倍低く、モデル C では約 5% 低くなりました。長いタスク、コンテキストウィンドウが小さい場合、およびキャッシュ読み取りのコストが高い場合には、プルーニングが依然として重要です。
条件ごとに 3~4 回の実行を行い、実行ごとに呼び出し回数が異なるこの調査では、わずか数パーセントの差しかない条件を区別するのではなく、大まかな傾向を示しています。
ガードレールは依然として重要です
どの実行も 480,000 文字の予算に達しなかったため、これらの実行を制限することはありませんでした。 制限は依然として重要です。ドリフトするエージェントはコンテキスト制限に向かって肥大し、キャッシュが破損すると、すべての呼び出しに全額の料金がかかります。 ステップ数、トークン数、実行あたりのコストに上限を設けることで、不適切な実行のコストを抑えることができます。 圧縮も別の選択肢ですが、本調査の範囲外となります。
結果から本番環境へ
一部の知見は、他のエージェントが Command に記録されたすべてのトレースを確認した際に明らかになりました。 これは、すべてのデータが確実に保存されているとは限らない単一のセッションでは困難です。 すべての情報を Command に保管することで、エージェントは MCP を介してそれらにアクセスできました。そのため、欠落したデータを回復するために実験を繰り返す必要がなくなり、作業が効率化されました。 調査結果は、人間とコーディングエージェント向けのチケットとなり、そこでプルリクエストがレビューされ、変更が StackAI に送信されました。 この調査以降、Codex でも同じタスクを実行し、そのアプローチを StackAI エージェントのアプローチと比較した結果、2回目の改善を提案しました。現在は Command でチケットとして管理されています。
得られた教訓
システムプロンプトだけでなく、増え続ける履歴をキャッシュする。
履歴は追加のみに限定し、プルーニングが必要な場合は、まとめて大量に実行します。
モデルに合わせて履歴の予算を設定する。
プロバイダー独自のカウンターを使用して、呼び出しごとのキャッシュ読み取り回数を測定します。
すべてのセッションの完全な記録を保持し、分析とフォローアップ作業で同じ記録を使用できるようにします。
Asana は、このような実験を日常的に行えるようにするためのツールを開発しています。 完全な調査結果には、方法、結果、制限事項が記載されています。
ボトルネックはもはや出荷速度ではなく、人間の注意力です。 すべてのエンジニアが、多数のエージェントを率いる PM となる世界が近づいていると思います。