Cómo redujimos el costo de un agente de navegador 76 veces y lo hicimos 5 veces más rápido al mantener su caché intacta


Un estudio con GPT-6 Astra en Codex en cuatro modelos, desde la investigación del código hasta la medición de los resultados


Por qué lo analizamos
Asana está incorporando la automatización de flujos de trabajo de agentes a su plataforma a través de StackAI, y a la escala de Asana, las pequeñas ineficiencias se acumulan. Nuestro objetivo era hacer que un agente de navegador fuera más económico y rápido sin reducir la calidad de las respuestas.
“Así es como se ven los equipos de personas y agentes en la práctica. Un ingeniero definió la dirección, un agente realizó los experimentos y los resultados pasaron por Command hasta llegar a producción. Esto demuestra cómo Asana da vida a los equipos con personas y agentes”. - Arnab Bose, director de Producto de Asana
Qué estaba saliendo mal
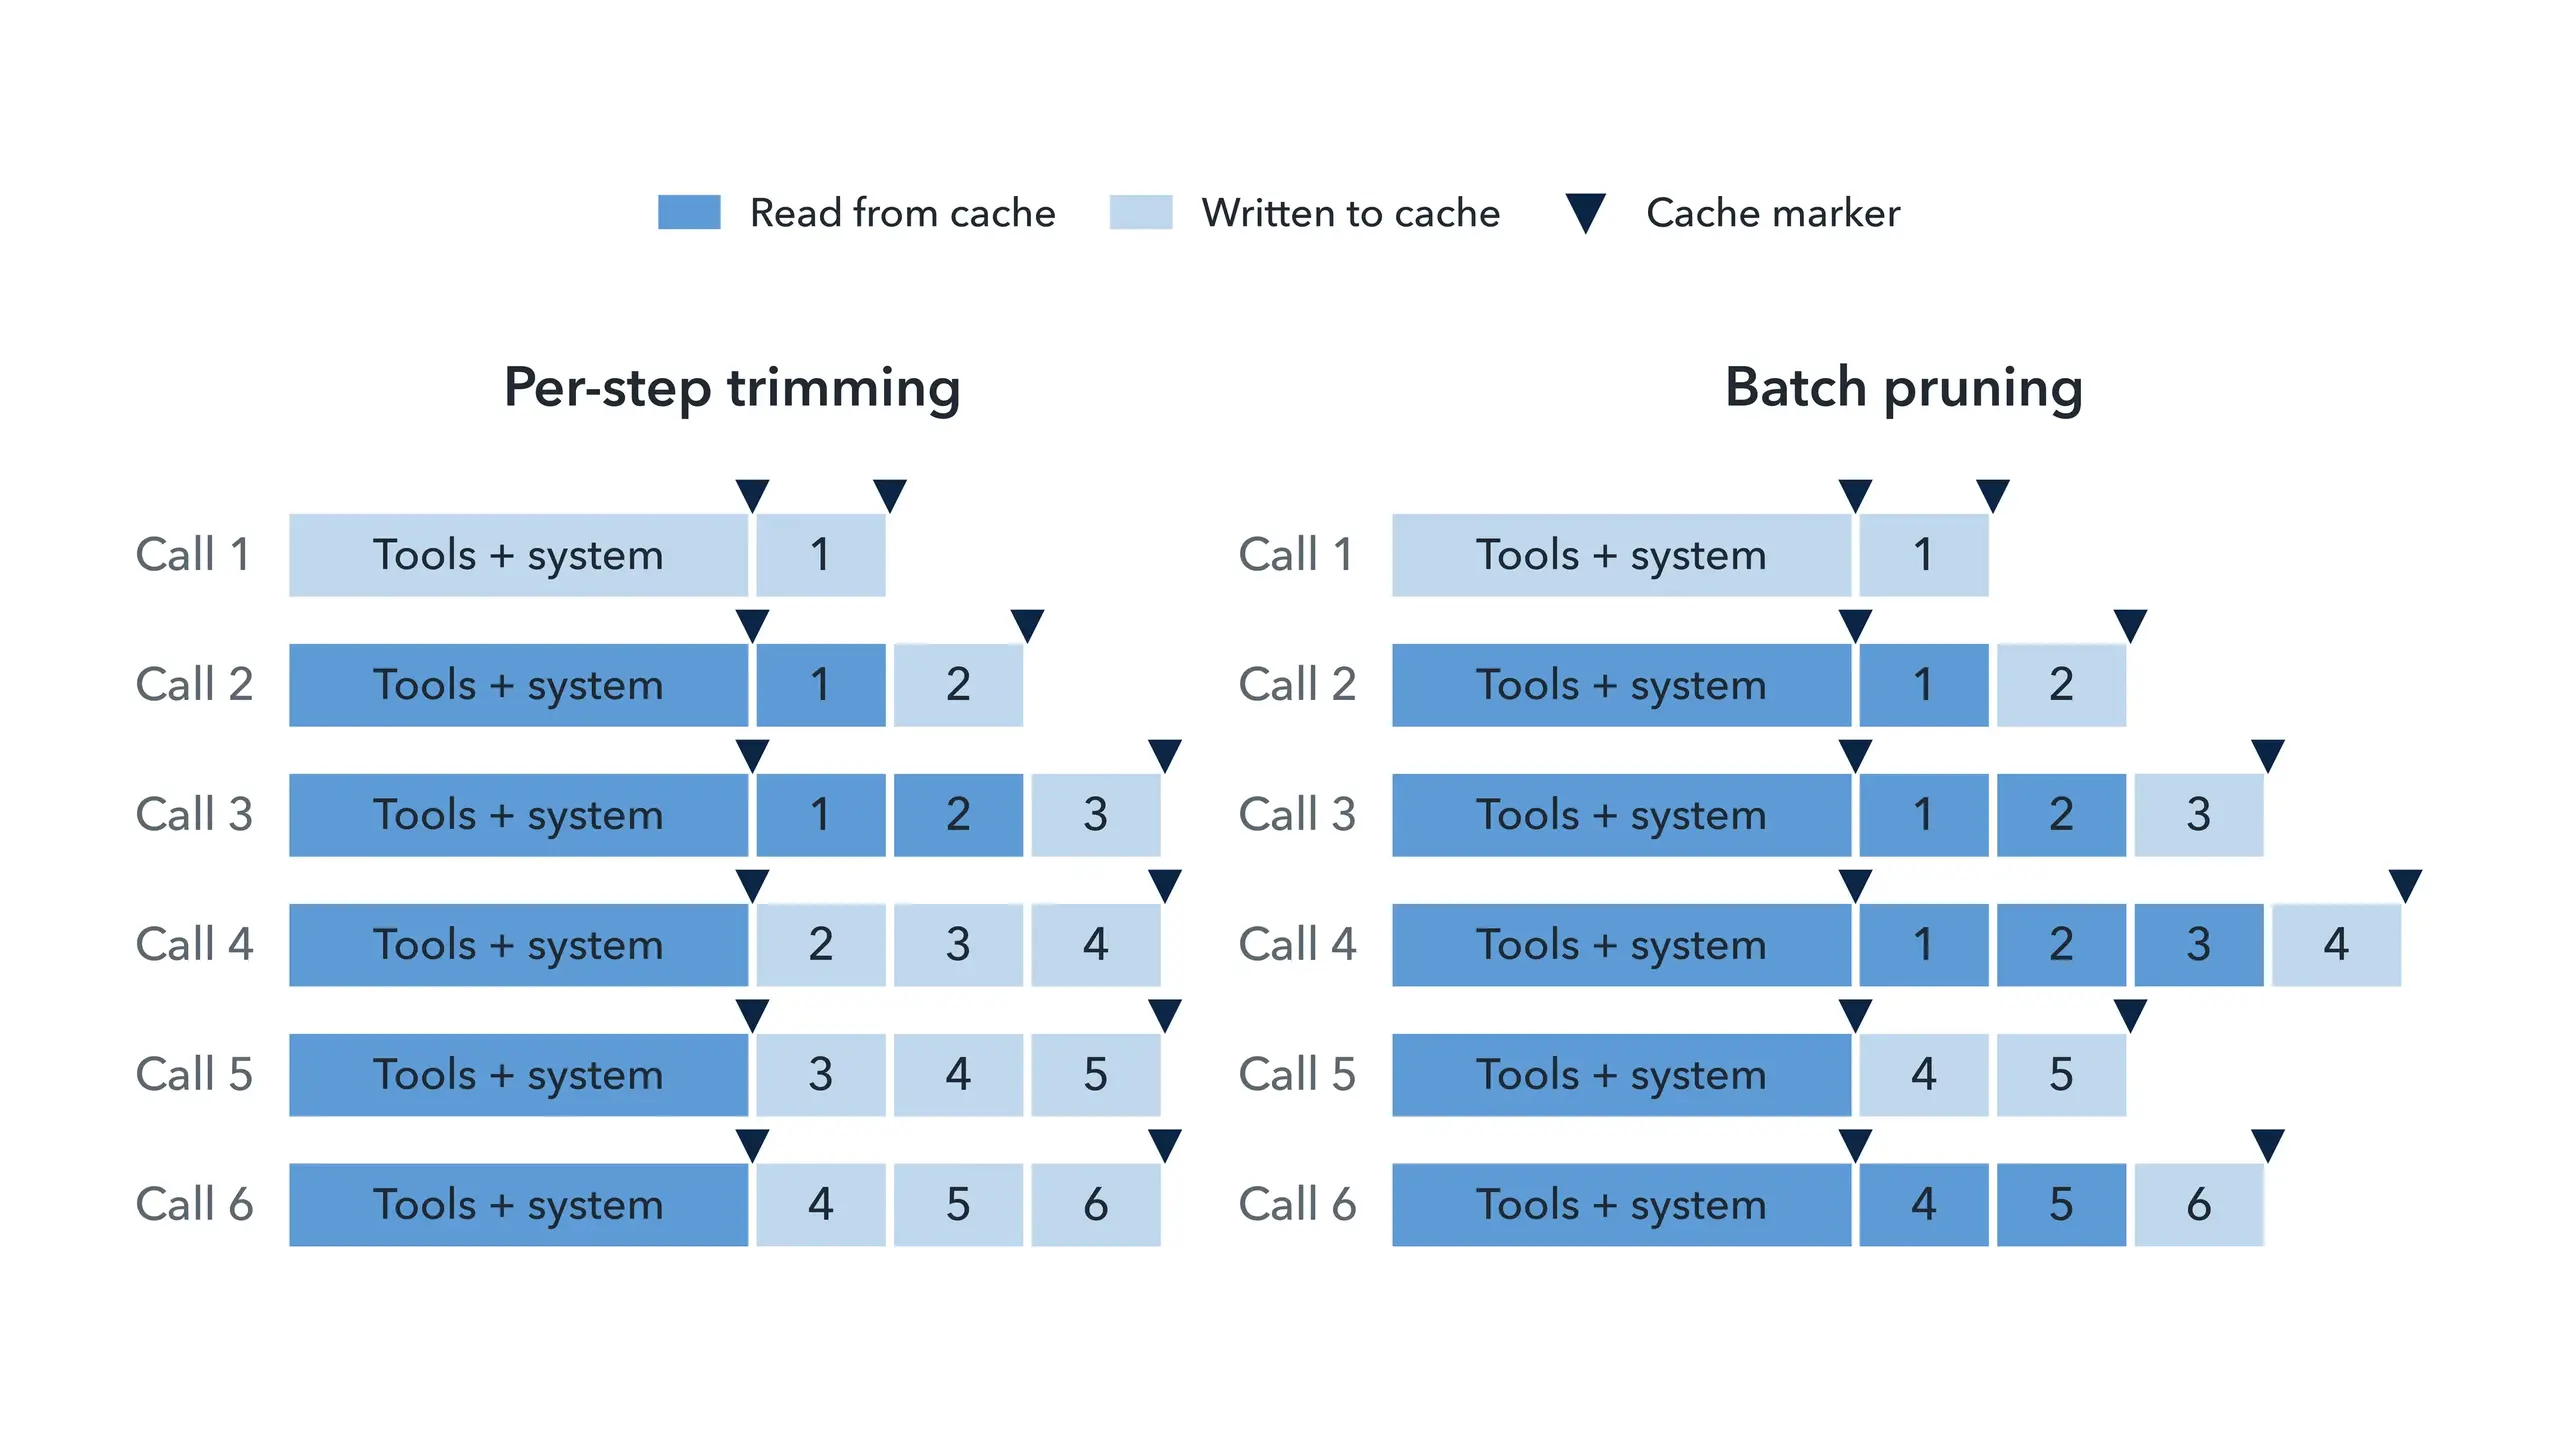
Un agente de navegador vuelve a enviar sus herramientas, la indicación del sistema y el historial cada vez mayor del texto de la página y las capturas de pantalla en cada llamada. El almacenamiento en caché de prompts reduce el costo de las entradas repetidas: en los modelos que probamos, las lecturas de la caché cuestan entre 0,05 veces y 0,1 veces el precio estándar de las entradas. Pero una caché solo reutiliza el prefijo más largo de una solicitud que no haya cambiado. Nuestro agente almacenó en caché sus herramientas y la indicación del sistema, pero no su historial, y almacenar en caché solo el historial no habría ayudado: el agente eliminaba la captura de pantalla anterior en cada paso y recortaba el texto más antiguo para ajustarse a un límite de historial. Cada modificación alteraba una parte anterior de la solicitud, por lo que la reutilización fallaba en casi todas las llamadas.
La solución
En primer lugar, también se debe almacenar en caché el historial, con un marcador de caché en el resultado más reciente de la herramienta. En segundo lugar, dejar de editarlo en cada llamada. La eliminación por lotes conserva las capturas de pantalla y las elimina por lotes: con una proporción de 20:1, el agente conserva hasta 20 y luego las reduce a 1, por lo que unas 19 llamadas consecutivas reutilizan el historial almacenado en caché. También aumentamos el límite del historial de 120 000 a 480 000 caracteres, por lo que ya no se recortaba el texto antiguo.

Cómo lo ejecutamos
GPT-6 Astra, trabajando en Codex, hizo la mayor parte del trabajo: auditó el código, instrumentó cada solicitud, ejecutó pruebas rápidas para identificar las variables importantes, refactorizó el código para ejecutar los flujos de trabajo en paralelo, inició las ejecuciones y analizó los rastreos. Los humanos establecieron el objetivo y los estándares y revisaron las conclusiones. Command, la plataforma de entrega de software de Asana, fue el sistema de registro: las solicitudes, los seguimientos y los resultados de cada sesión se registraron allí, para que pudiéramos analizar el estudio completo posteriormente, y los hallazgos se convirtieron en tickets, solicitudes de extracción y cambios revisados que se implementaron.


Nunca se me ocurrió hacerlo manualmente, ya que probablemente me habría llevado meses. Con Codex, tardé aproximadamente una semana: establecía un /objetivo antes de irme a dormir y revisaba los resultados por la mañana.
Ahora, cada noche en la que nuestros agentes no están funcionando se siente como una noche desperdiciada.
Probamos seis políticas de almacenamiento en caché e historial con dos presupuestos en GPT-6.1 Sol y otros tres modelos de vanguardia, los modelos A, B y C (tabla a continuación), con tres ejecuciones por condición: 144 ejecuciones, más un seguimiento de 12 ejecuciones. Calculamos los costos a partir de los contadores de tokens de cada proveedor, y cada respuesta se evaluó en función de una referencia preparada de forma independiente.
Modelo | Qué es | Precio |
Modelo A | Un modelo más pequeño y de menor costo de otro laboratorio de vanguardia, lanzado en el otoño de 2025 | La mitad del precio de GPT-6.1 Sol |
Modelo B | El modelo utilizado originalmente en producción, del mismo laboratorio que el Modelo A, lanzado en el verano de 2026 | Igual que GPT-6.1 Sol |
Modelo C | Una versión más reciente del Modelo B, lanzada en el otoño de 2026 | Igual que GPT-6.1 Sol |
GPT-6.1 Sol | Modelo de OpenAI | Referencia |
Resultados

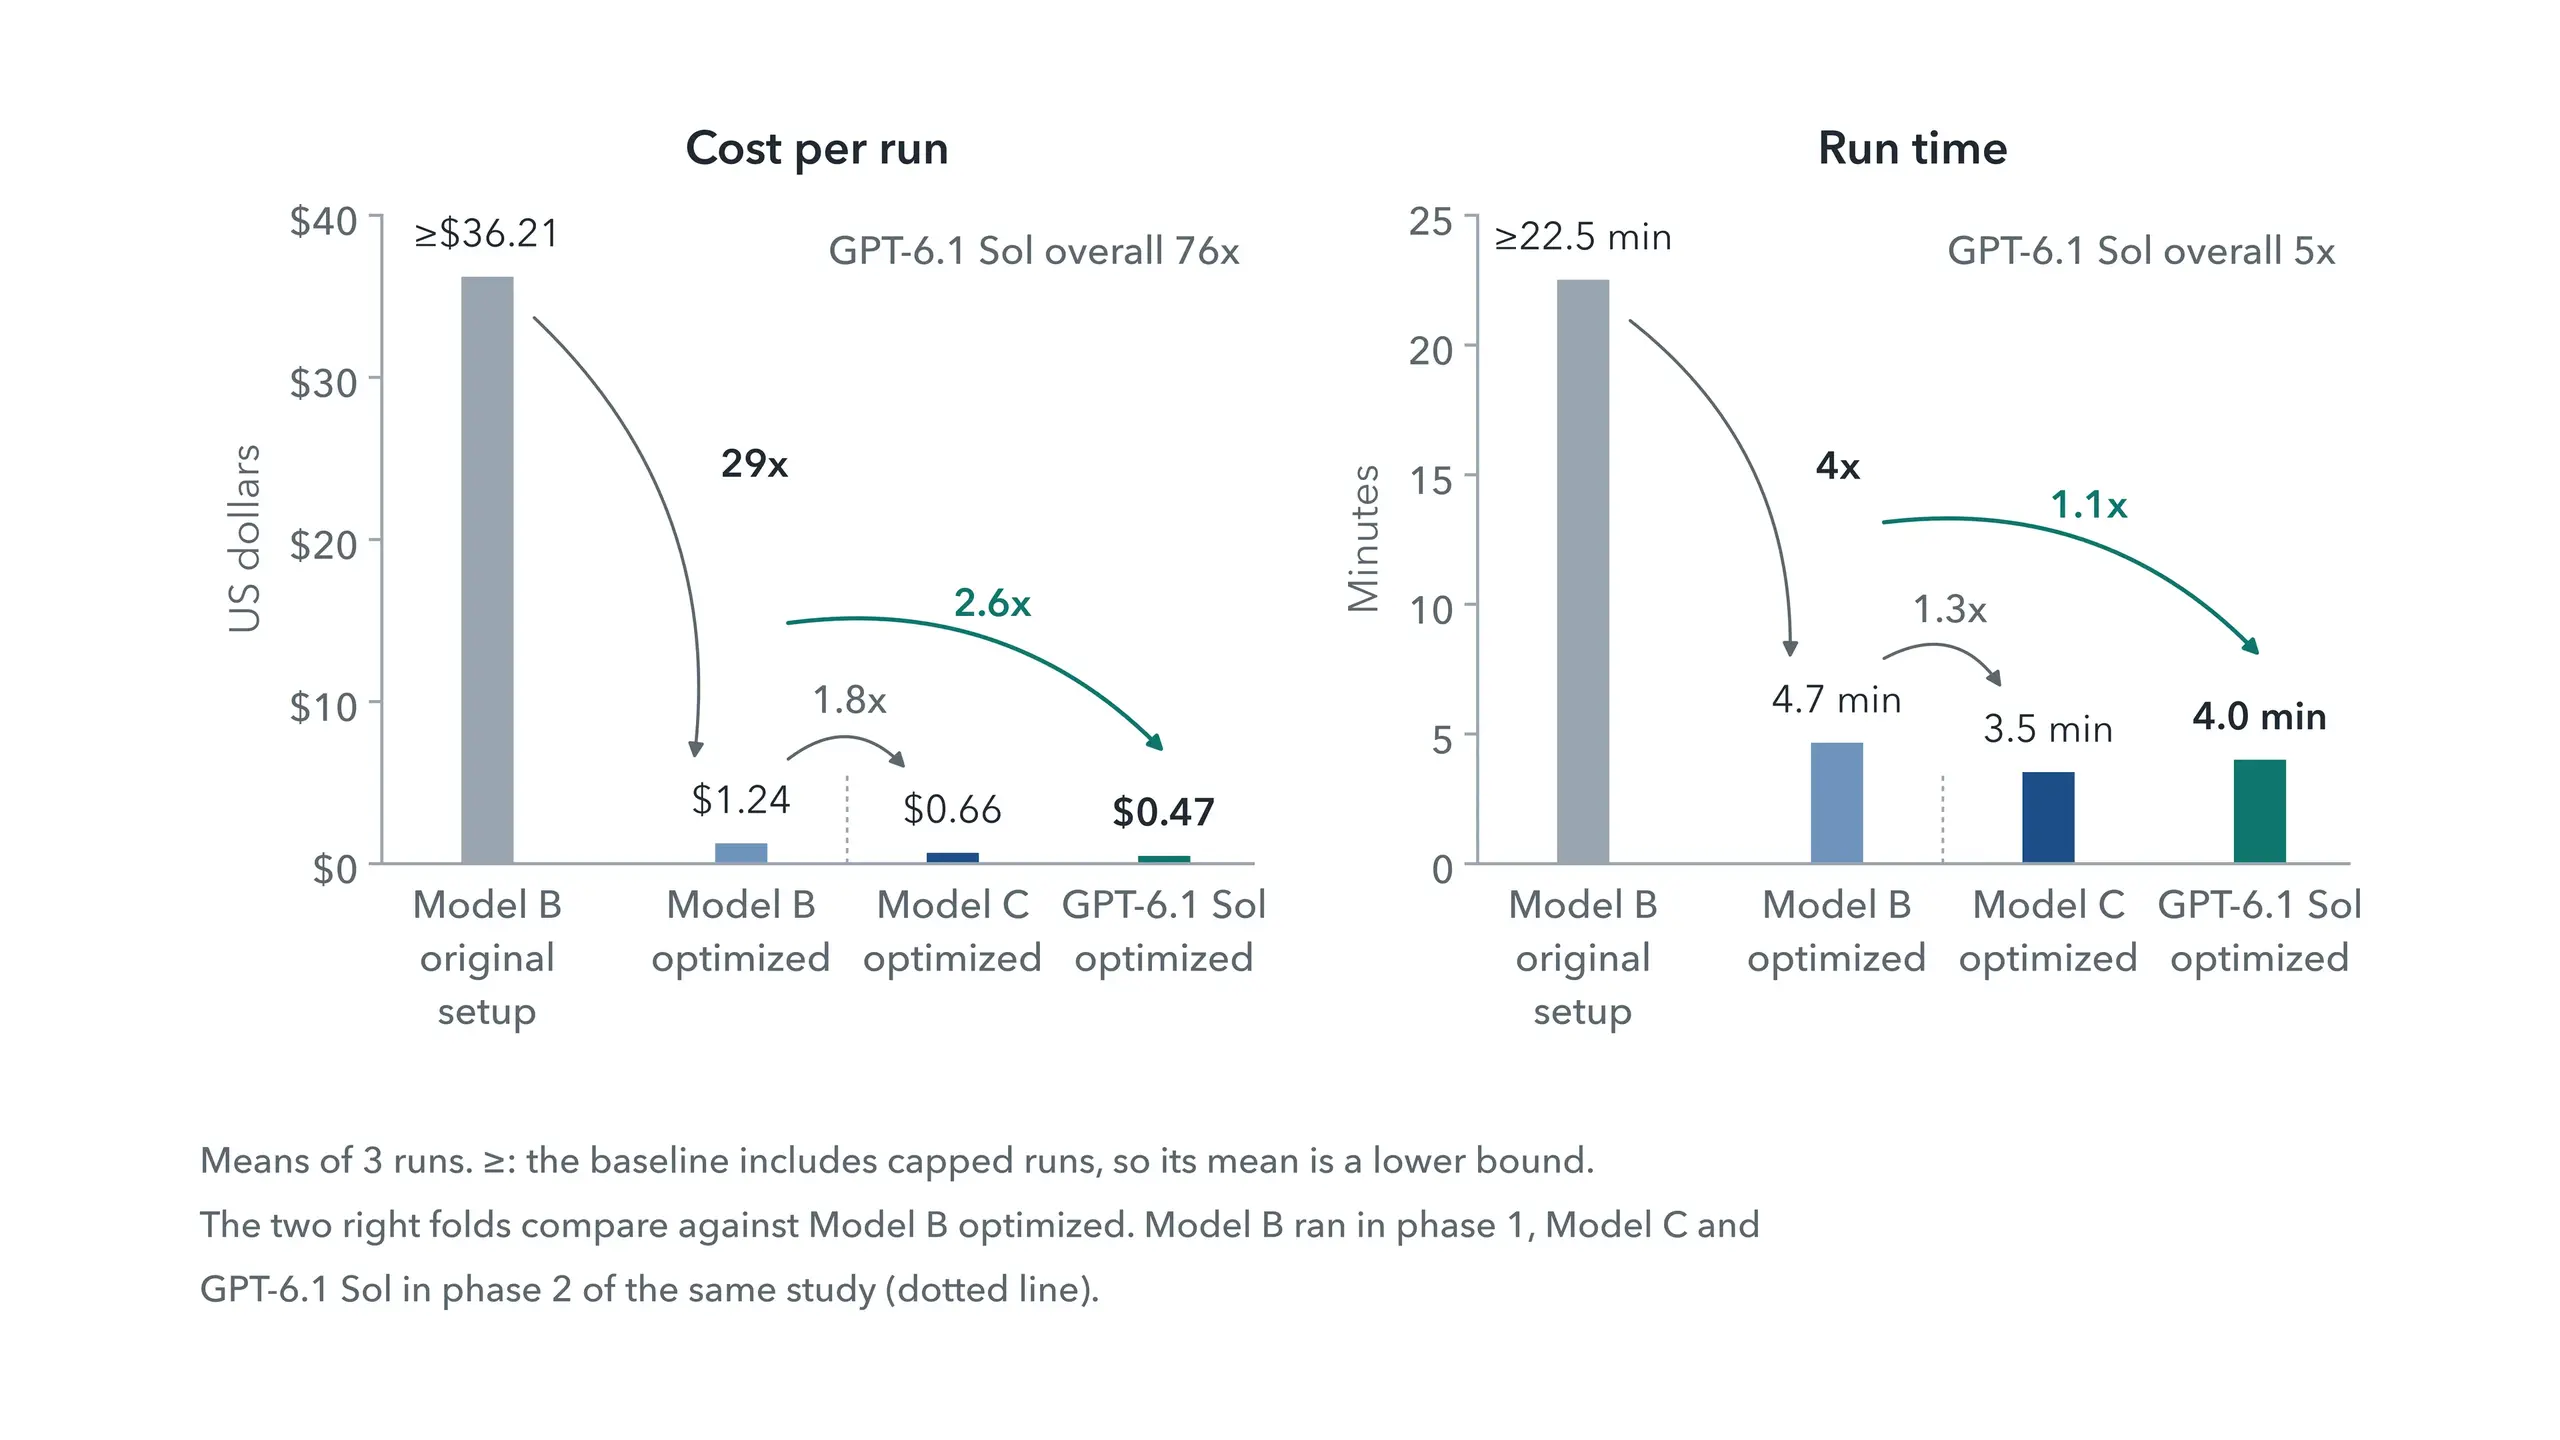
En el modelo B, la mejor condición redujo el costo por ejecución 29 veces y se ejecutó 4 veces más rápido que la configuración de producción original. En GPT-6.1 Sol, el mismo agente costó 76 veces menos y se ejecutó 5 veces más rápido, leyendo el 89 % de sus entradas desde la memoria caché. En todos los modelos, cada ejecución en las mejores condiciones costó menos que cada ejecución de referencia y encontró los 192 hechos.
Aprendizajes
El presupuesto debe ajustarse al modelo. Los modelos más nuevos agotaron el presupuesto más reducido con mayor rapidez: el modelo C redujo por primera vez su historial en la llamada 10, y el modelo A, en la llamada 64. Con 120 000 caracteres, el modelo C no respondió en ninguna de las 18 ejecuciones y Sol respondió en 3, la mayoría alcanzando el límite de pasos; con 480 000, ambos modelos respondieron en todas las ejecuciones.
El almacenamiento en caché por sí solo no es suficiente. Sin la poda por lotes, almacenar en caché el historial con el presupuesto más grande costó más que no almacenarlo en caché en tres de los cuatro modelos: la caché se reescribía continuamente y se leía en pocas ocasiones.
¿Realmente necesitas podar?
Los datos por llamada sugirieron que es posible que no sea necesario realizar una poda en este caso, por lo que en un seguimiento se conservaron todas las capturas de pantalla. El costo por llamada fue 1,2 veces menor que en la mejor condición en el modelo B y en Sol, y alrededor de un 5 % menor en el modelo C. La poda sigue siendo importante para tareas largas, ventanas de contexto pequeñas y lecturas de caché más costosas.
Con tres o cuatro ejecuciones por condición y recuentos de llamadas que varían entre ejecuciones, este estudio muestra patrones generales en lugar de distinguir condiciones con solo unos pocos puntos porcentuales de diferencia.
Las barreras de seguridad siguen siendo importantes
Ninguna ejecución alcanzó el presupuesto de 480 000 caracteres, por lo que no limitó estas ejecuciones. Los límites siguen siendo importantes: un agente que se desvía crece hacia el límite del contexto, y si la caché falla, cada llamada paga el precio completo. Los límites de pasos, tokens y costo por ejecución restringen el costo de una ejecución deficiente. La compactación es otra opción, pero queda fuera del alcance de este estudio.
De los hallazgos a la producción
Algunos hallazgos surgieron más tarde, cuando otros agentes revisaron todos los registros guardados en Command. Eso es difícil de hacer desde una sola sesión, donde no se puede estar seguro de que se hayan almacenado todos los datos. Al mantener todo en Command, al que nuestros agentes accedían a través de MCP, nunca tuvimos que repetir un experimento para recuperar datos faltantes, lo que aceleró el trabajo. Los hallazgos se convirtieron en tickets para las personas y los agentes de codificación, allí se revisaron las solicitudes de extracción y los cambios se enviaron a StackAI. Desde el estudio, también hemos ejecutado la misma tarea con Codex, que comparó su enfoque con el del agente de StackAI y sugirió una segunda ronda de mejoras, ahora en forma de tickets en Command.
Lo que aprendimos
Almacena en caché el historial en crecimiento, no solo la indicación del sistema.
Mantén el historial solo para agregar información; cuando sea necesario eliminar datos, hazlo en lotes grandes.
Establece el presupuesto del historial para que se adapte al modelo.
Mide las lecturas de la caché por llamada usando los contadores del proveedor.
Lleven un registro completo de cada sesión, para que el análisis y el trabajo de seguimiento usen el mismo registro.
Asana está creando herramientas para hacer que experimentos como este sean algo habitual. El estudio completo abarca los métodos, los resultados y las limitaciones.
La velocidad de envío ya no es el cuello de botella; la atención humana lo es. Creo que estamos cerca de un mundo en el que cada ingeniero es un jefe de proyecto que dirige una flota de agentes.