Hur vi minskade kostnaden för en webbläsaragent med 76 gånger och gjorde den 5 gånger snabbare genom att behålla dess cache minne intakt


En studie med GPT-6 Astra i Codex över fyra modeller, från att undersöka koden till att mäta resultaten


Varför vi undersökte det
Asana inför automatisering av agentarbetsflöden på sin plattform genom StackAI, och i Asanas skala blir små ineffektiviteter snabbt ett problem. Vårt mål var att göra en webbläsaragent billigare och snabbare utan att försämra kvaliteten på svaren.
"Så här ser team med människor och agenter ut i praktiken. En tekniker fastställde riktningen, en agent genomförde experimenten och resultaten gick via Command till produktionen. Det här visar hur Asana förverkligar team bestående av människor och agenter.” – Arnab Bose, produktchef på Asana
Vad fungerade inte?
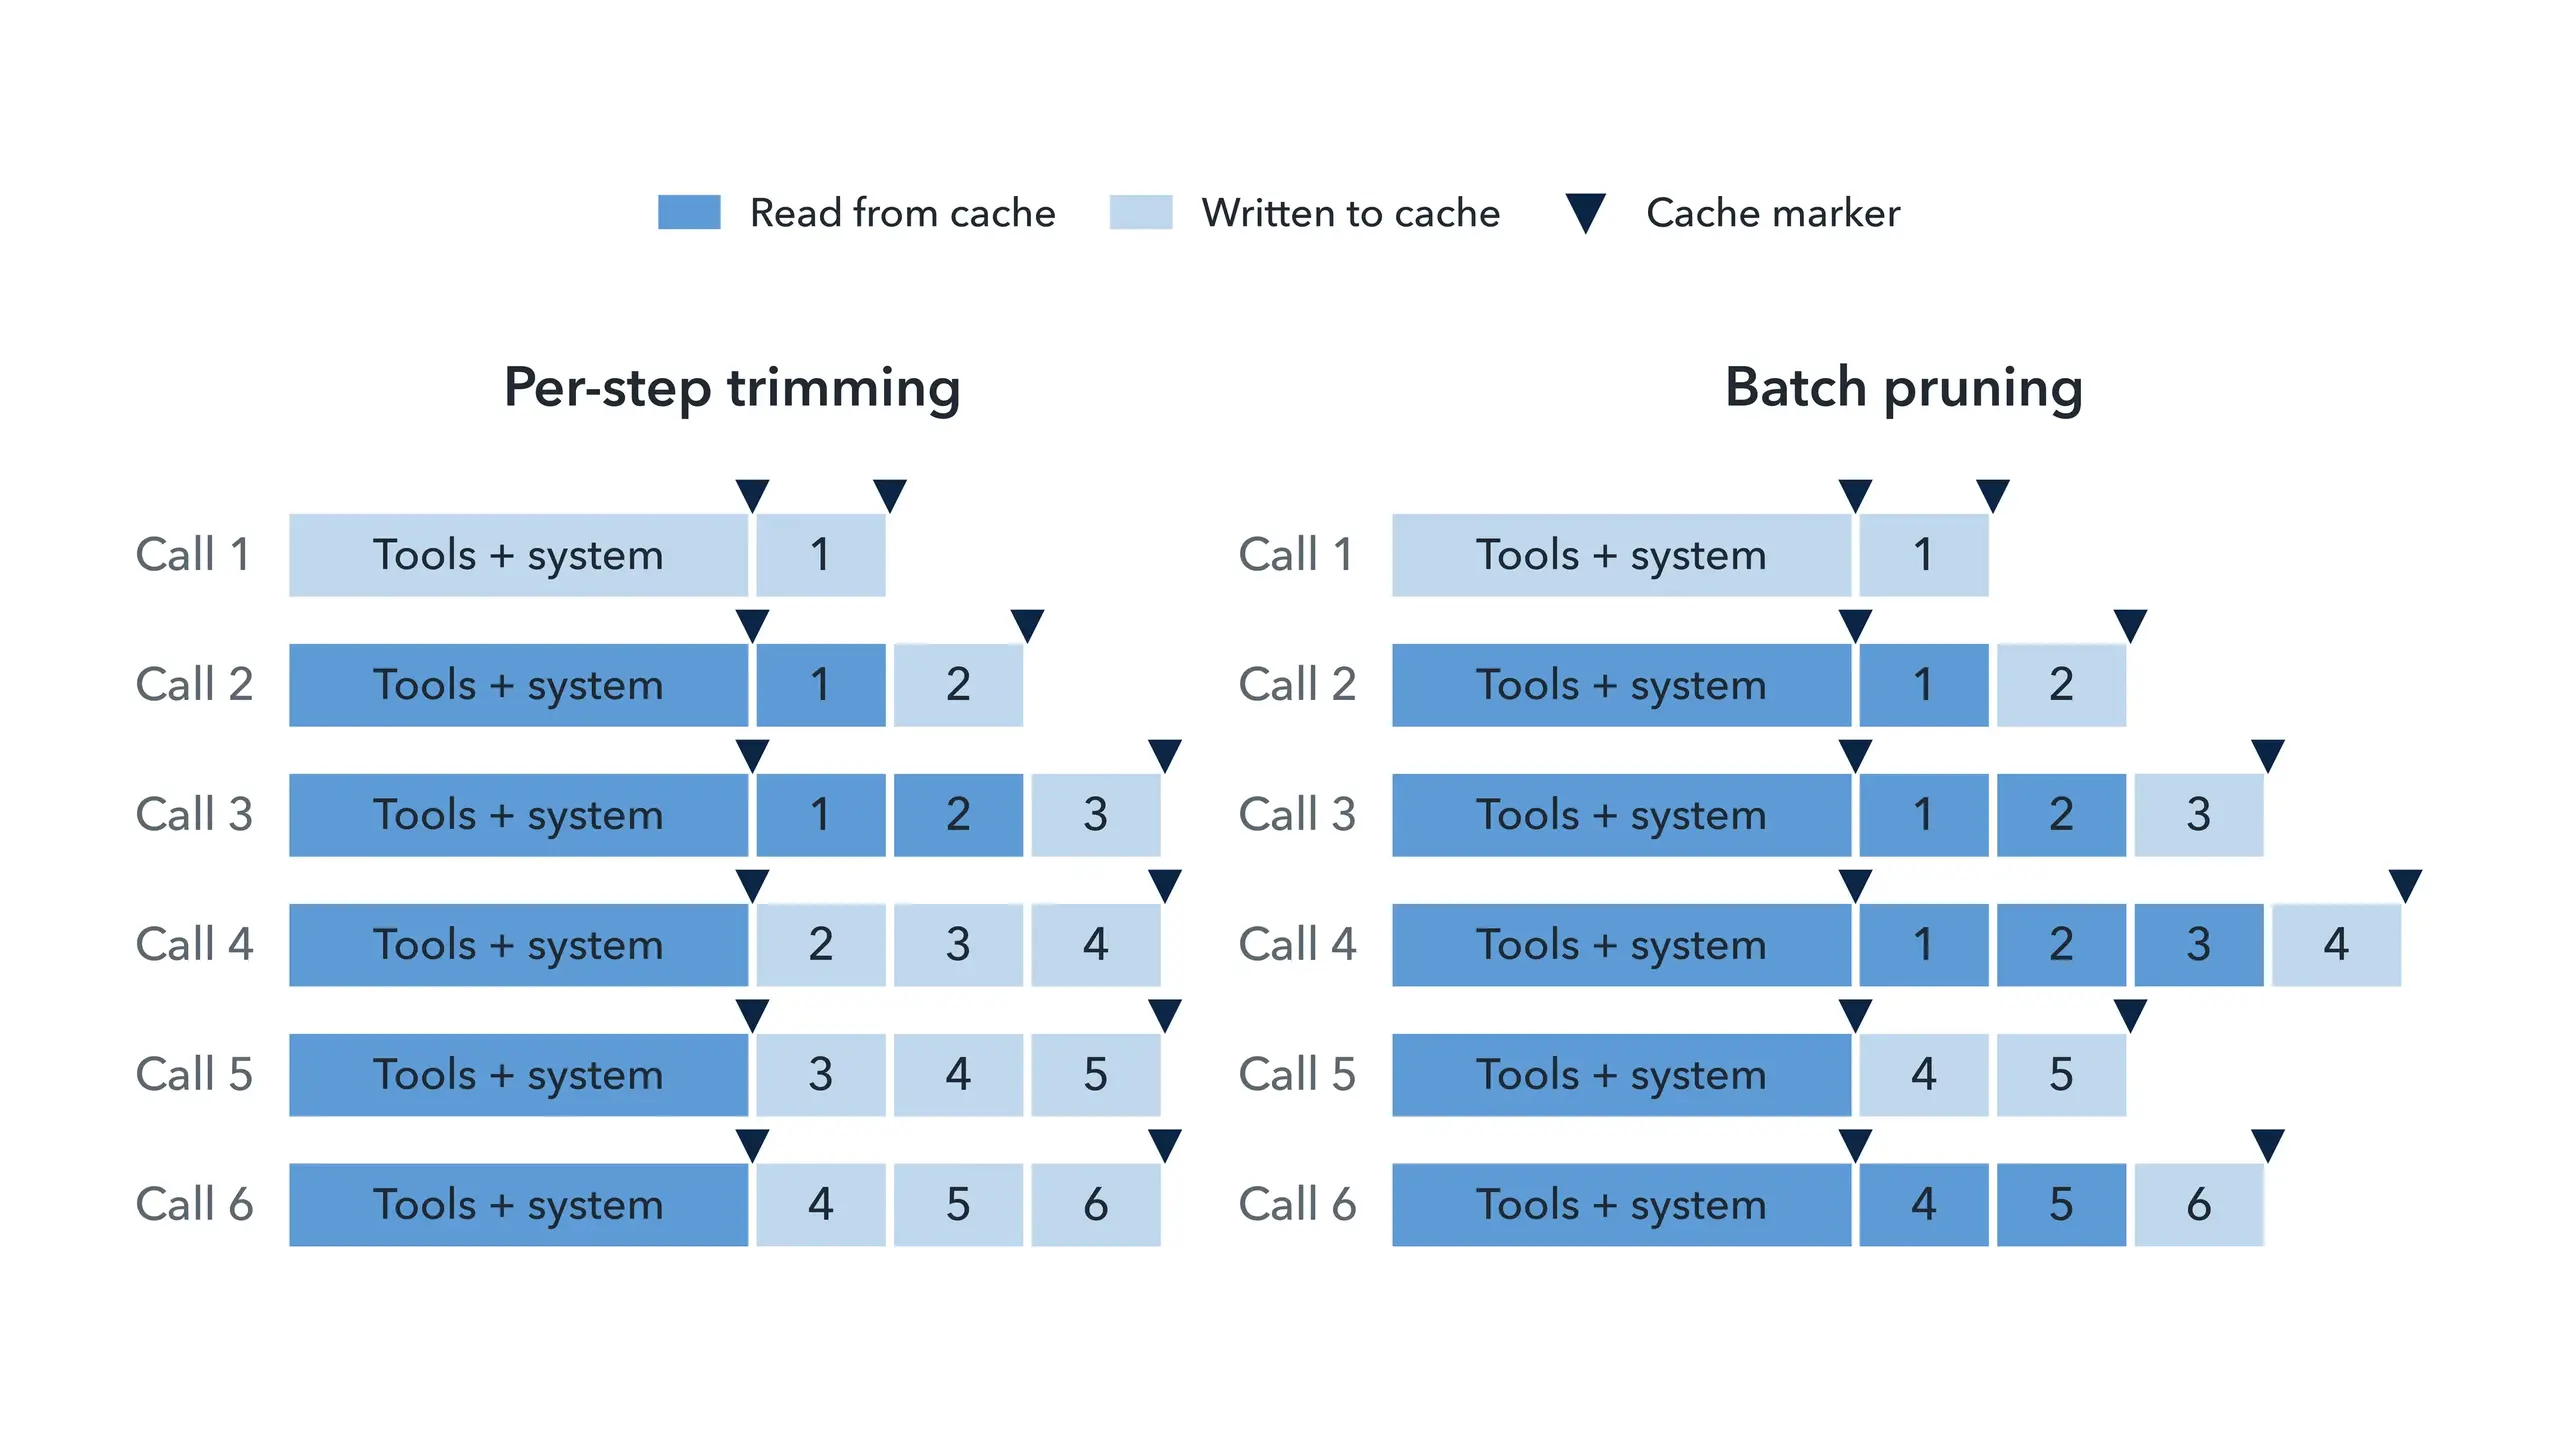
En webbläsaragent skickar om sina verktyg, sin systemuppmaning och sin växande historik av sidtext och skärmdumpar vid varje anrop. Promptcaching sänker kostnaden för upprepad inmatning: på de modeller vi testade kostade cacheläsningar 0,05–0,1 gånger standardpriset för inmatning. Men en cache återanvänder bara det längsta oförändrade prefixet i en förfrågan. Vår agent cachelagrade sina verktyg och sin systemuppmaning men inte sin historik, och att enbart cachelagra historiken skulle inte ha hjälpt: agenten tog bort den tidigare skärmdumpen i varje steg och beskar äldre text för att få plats inom historikbudgeten. Varje redigering ändrade en tidigare del av förfrågan, så återanvändningen fungerade inte vid nästan varje anrop.
Lösningen
För det första ska även historiken cachas, med en cachemarkör på det senaste verktygsresultatet. För det andra, sluta redigera den vid varje anrop. Batchvis rensning behåller skärmdumpar och tar bort dem i batcher: vid 20:1 behåller agenten upp till 20 och minskar sedan till 1, så cirka 19 på varandra följande anrop återanvänder den cachelagrade historiken. Vi ökade också historikbudgeten från 120 000 till 480 000 tecken, så att gammal text inte längre kortades av.

Så här genomförde vi det
GPT-6 Astra, som arbetade i Codex, utförde det mesta av arbetet: den granskade koden, instrumenterade varje förfrågan, körde snabba tester för att identifiera de variabler som var viktiga, refaktorerade koden för att köra arbetsflöden parallellt, startade körningarna och analyserade spårningarna. Människor fastställde målet och standarderna och granskade slutsatserna. Command, Asanas plattform för programvaruleverans, var dokumenteringssystemet: varje sessions förfrågningar, spårningar och resultat registrerades där, så att vi kunde analysera hela studien i efterhand, och resultaten blev ärenden, pull-förfrågningar och granskade ändringar som lanserades.


Jag tänkte aldrig på att göra det manuellt eftersom det sannolikt skulle ha tagit mig månader. Med Codex tog det ungefär en vecka: Jag satte ett /mål innan jag gick och la mig och granskade resultaten på morgonen.
Nu känns varje natt då våra agenter inte körs som en bortkastad natt.
Vi testade sex policyer för cachelagring och historik med två budgetar på GPT-6.1 Sol och tre andra avancerade modeller, modellerna A, B och C (tabellen nedan), med tre körningar per villkor: 144 körningar, plus en uppföljning med 12 körningar. Vi beräknade kostnaderna utifrån varje leverantörs tokenräknare, och varje svar bedömdes mot en oberoende utarbetad referens.
Modell | Vad det är | Pris |
Modell A | En mindre, billigare modell från ett annat banbrytande laboratorium, släppt hösten 2025 | Hälften av priset för GPT-6.1 Sol |
Modell B | Den modell som ursprungligen användes i produktionen, från samma labb som modell A, lanserades sommaren 2026 | Samma som GPT-6.1 Sol |
Modell C | En nyare version av modell B, släppt hösten 2026 | Samma som GPT-6.1 Sol |
GPT-6.1 Sol | OpenAIs modell | Referens |
Resultat

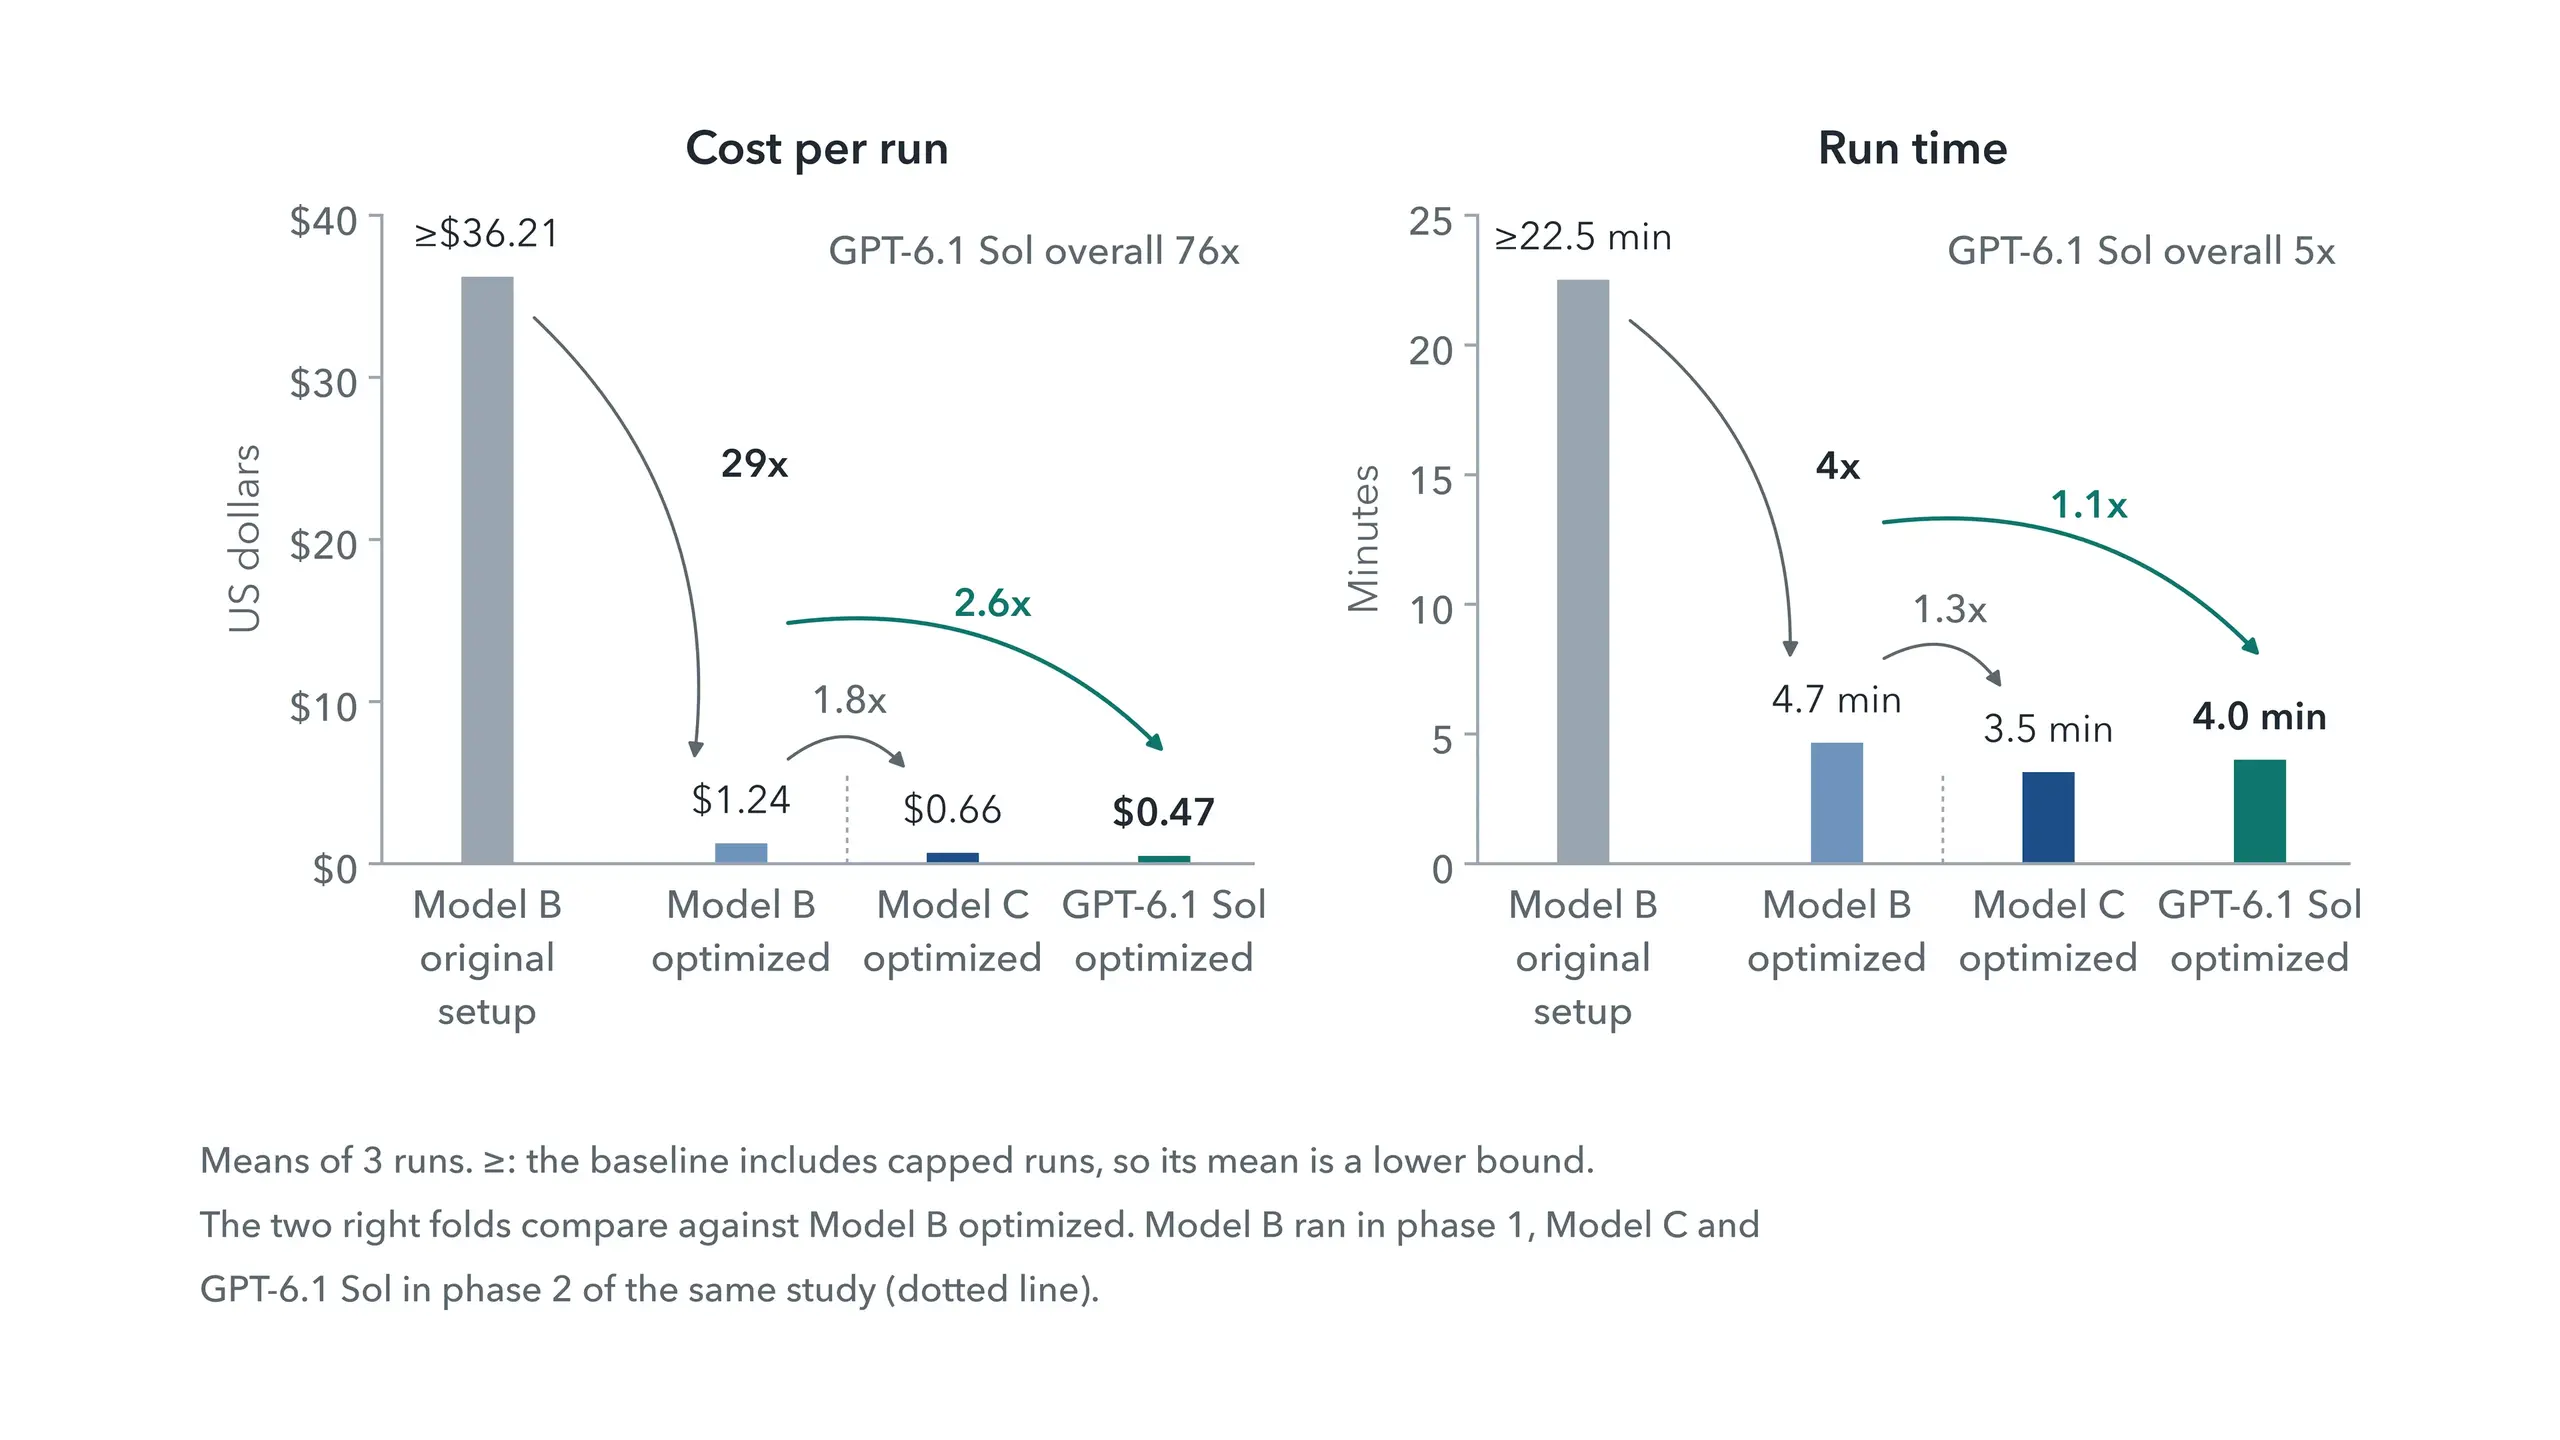
På modell B minskade det bästa villkoret kostnaden per körning 29 gånger och kördes 4 gånger snabbare än den ursprungliga produktionskonfigurationen. På GPT-6.1 Sol kostade samma agent 76 gånger mindre och kördes 5 gånger snabbare, och läste 89 % av sin input från cacheminnet. För varje modell kostade varje körning under bästa förhållanden mindre än varje baslinjekörning och stötte på alla 192 fakta.
Lärdomar
Budgeten måste passa modellen. Nyare modeller förbrukade den mindre budgeten snabbare: Modell C trimmade först sin historik vid samtal 10, modell A vid samtal 64. Vid 120 000 tecken svarade modell C inte i någon av de 18 körningarna och Sol i 3, varav de flesta nådde steggränsen. Vid 480 000 svarade båda modellerna i alla körningar.
Det räcker inte med enbart cachelagring. Utan batchvis rensning kostade det mer att cachelagra historiken med den större budgeten än att inte cachelagra den på tre av fyra modeller: cachen skrevs kontinuerligt om och lästes sällan.
Behöver man ens rensa?
Data per anrop tydde på att rensning kanske inte behövdes här, så en uppföljning behöll alla skärmbilder. Kostnaden per anrop var 1,2 gånger lägre än det bästa villkoret för modell B och Sol, och cirka 5 % lägre för modell C. Beskärning är fortfarande viktigt för långa uppgifter, små kontextfönster och dyrare cacheläsningar.
Med tre eller fyra körningar per villkor och antal anrop som varierar mellan körningarna visar den här studien breda mönster snarare än att skilja mellan villkor som bara skiljer sig åt med några få procent.
Räcken är fortfarande viktiga
Ingen körning nådde budgeten på 480 000 tecken, så den begränsade inte dessa körningar. Begränsningar är fortfarande viktiga: en avvikande agent växer mot kontextgränsen, och om cachen går sönder betalar varje anrop fullt pris. Begränsningar av steg, tokens och kostnad per körning begränsar kostnaden för en dålig körning. Komprimering är ett annat alternativ, men det ligger utanför den här studiens omfattning.
Från resultat till produktion
Vissa resultat framkom senare, när andra agenter granskade varje spår som loggats i Command. Det är svårt att göra från en enda session, där du inte kan vara säker på att alla data har lagrats. Att ha allt i Command, som våra agenter fick åtkomst till via MCP, innebar att vi aldrig behövde upprepa ett experiment för att återställa saknade data, vilket påskyndade arbetet. Resultaten blev ärenden för människor och kodningsagenter, pull requests granskades där och ändringarna skickades till StackAI. Efter studien har vi också kört samma uppgift med Codex, som jämförde sitt tillvägagångssätt med StackAI-agentens och föreslog en andra omgång förbättringar, nu som ärenden i Command.
Vad vi lärde oss
Cacha den växande historiken, inte bara systemuppmaningen.
Se till att historiken endast kan läggas till; när det är nödvändigt att rensa ska det göras i stora satser.
Ställ in historikbudgeten så att den passar modellen.
Mät cache-avläsningar per anrop med hjälp av leverantörens egna räknare.
För ett fullständigt register över varje session, så att analysen och uppföljningsarbetet använder samma register.
Asana utvecklar verktyg för att göra experiment som det här till en rutin. Den fullständiga studien omfattar metoder, resultat och begränsningar.
Leveranshastigheten är inte längre flaskhalsen; det är människors uppmärksamhet. Jag tror att vi är nära en värld där varje ingenjör är en produktchef som leder en flotta av agenter.