Как мы сократили затраты на браузерный агент в 76 раз и повысили его скорость в 5 раз, сохранив кэш без изменений


Исследование с использованием GPT-6 Astra в Codex на четырёх моделях — от анализа кода до оценки результатов


Зачем мы проводили исследование
Asana внедряет автоматизацию рабочих процессов с помощью агентов на своей платформе через StackAI, и в масштабах Asana даже небольшие недостатки накапливаются. Наша цель заключалась в том, чтобы сделать одного агента браузера дешевле и быстрее без ущерба для качества ответов.
«Вот как на практике выглядят команды, состоящие из людей и агентов. Инженер задавал направление, агент проводил эксперименты, а результаты через Command поступали в производственную среду. Это демонстрирует, как Asana воплощает в жизнь команды, состоящие из людей и агентов», — Арнаб Бозе, директор по продукту Asana
Что было не так
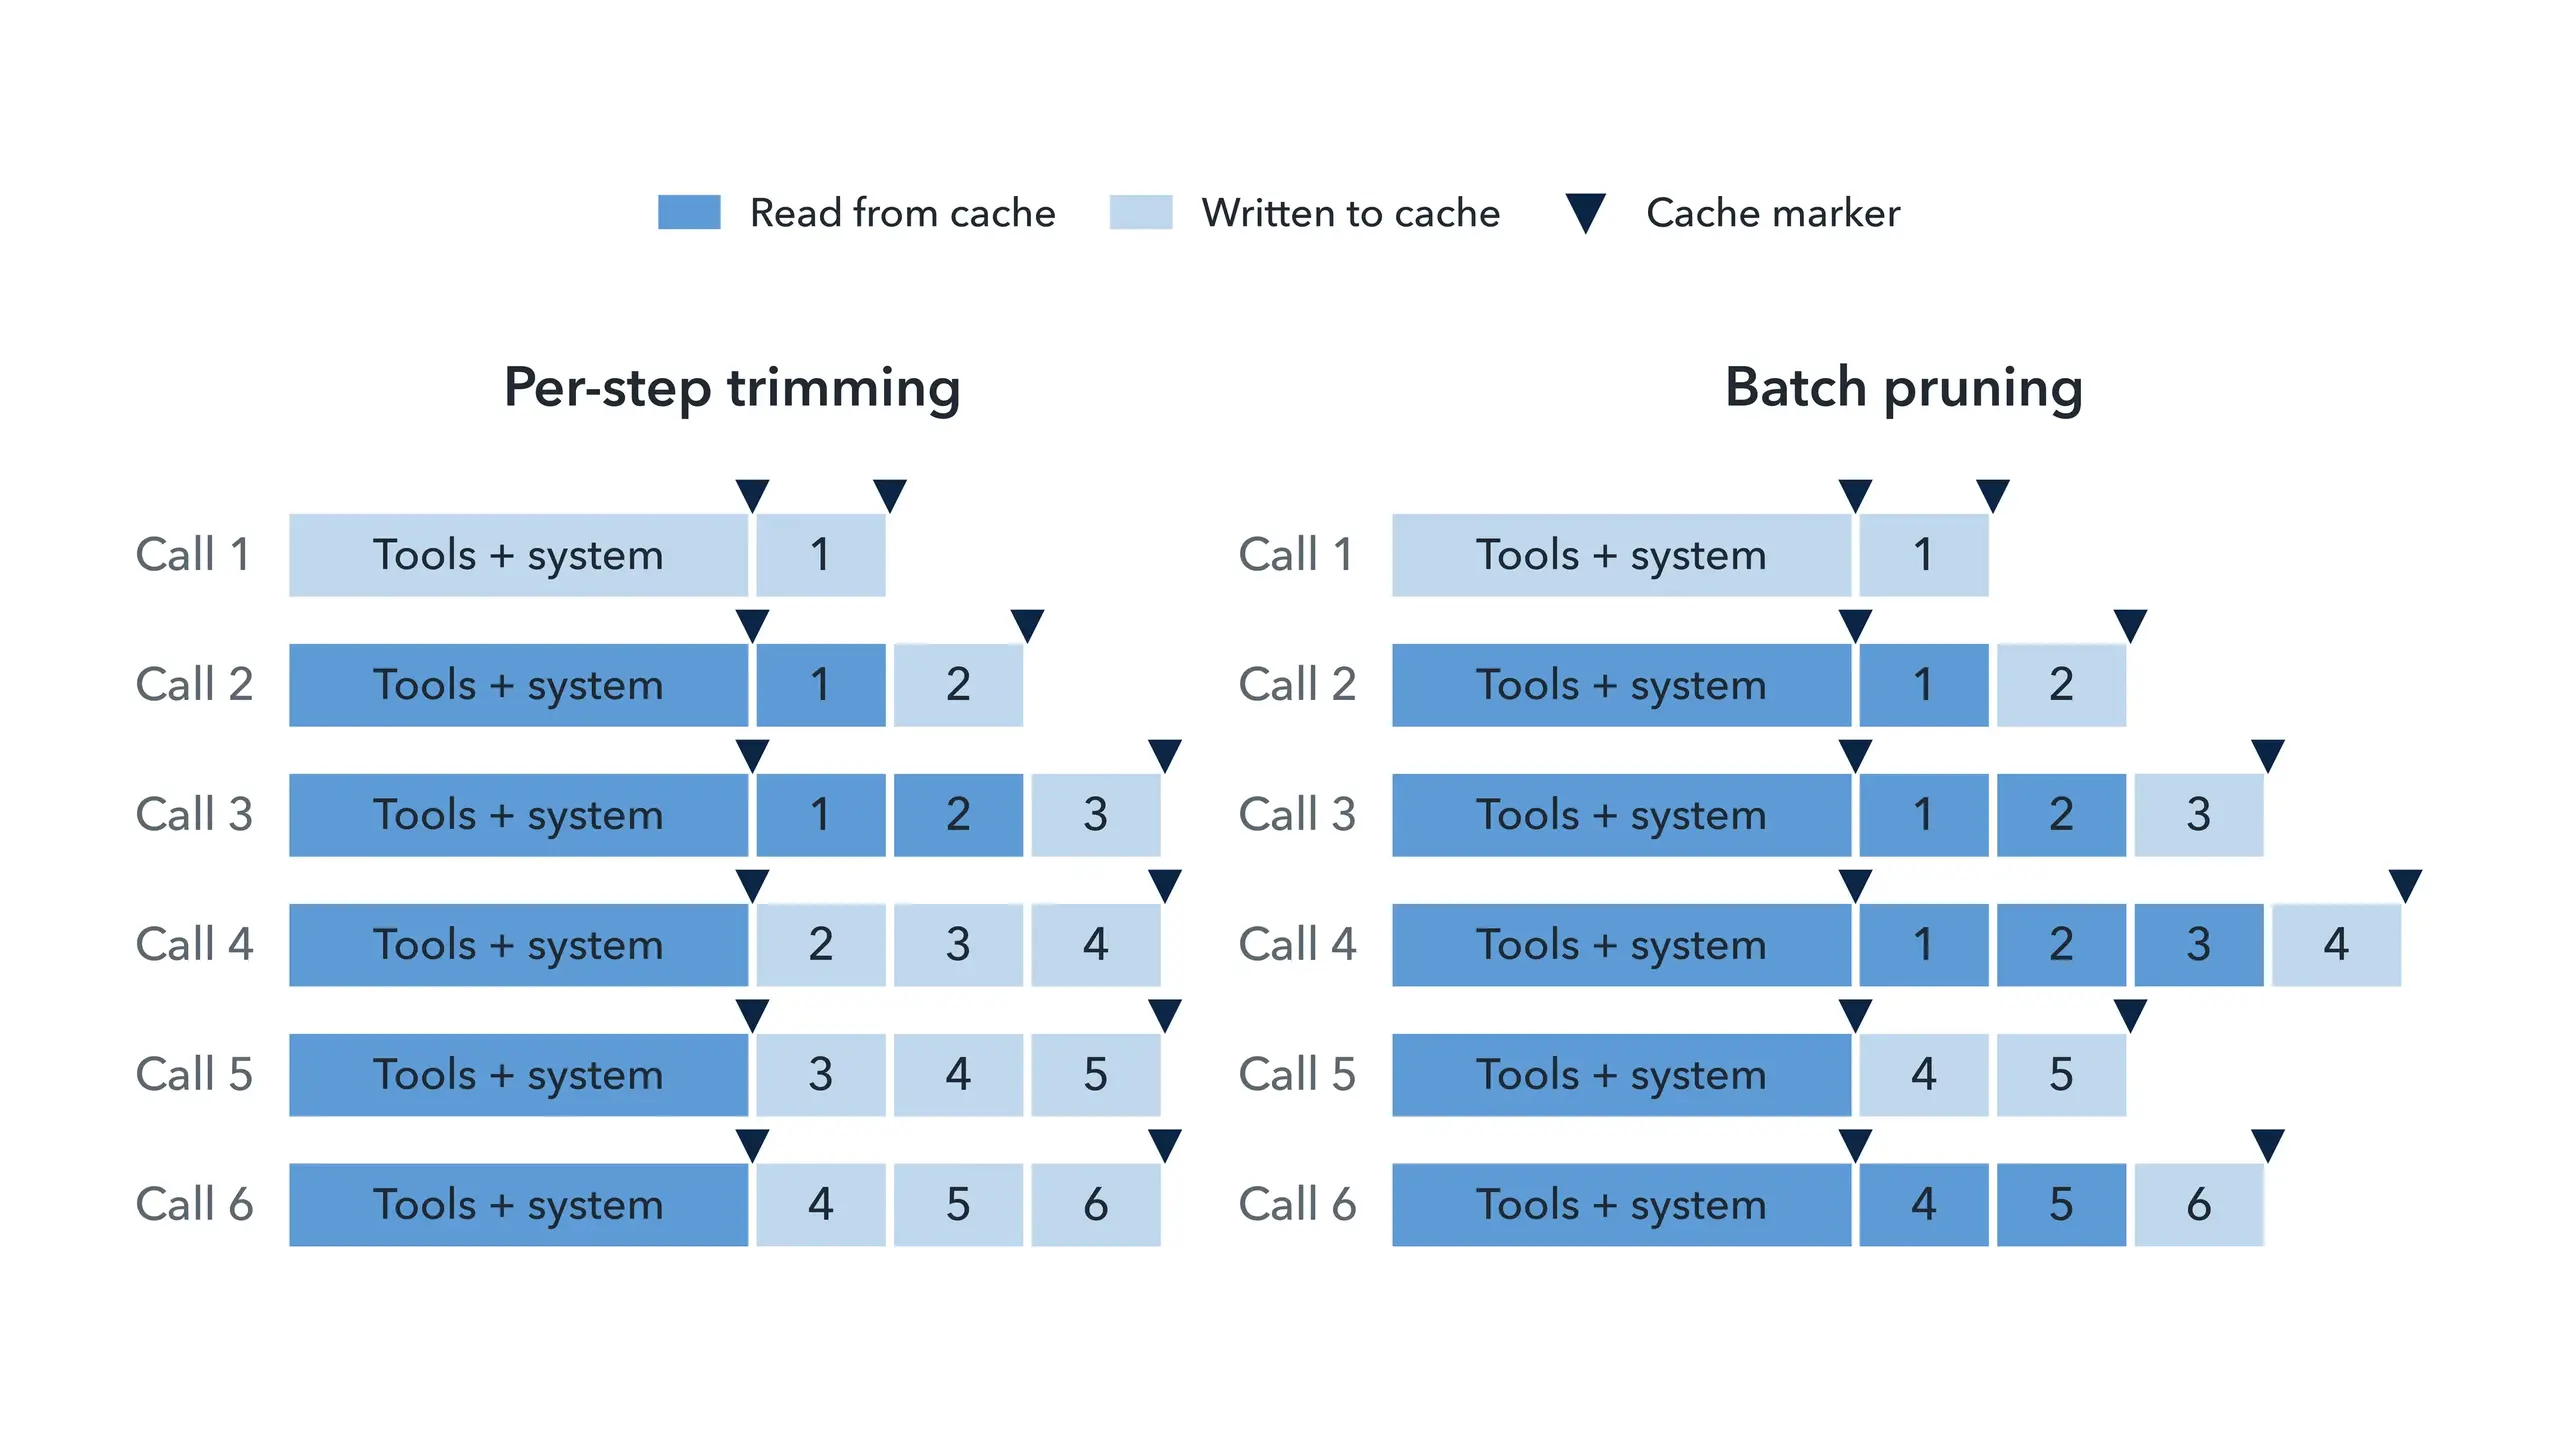
При каждом вызове браузерный агент повторно отправляет свои инструменты, системный промпт и растущую историю текста страниц и снимков экрана. Кэширование промптов снижает стоимость повторного ввода: на протестированных нами моделях чтение из кэша стоит от 0,05 до 0,1 стандартной цены ввода. Однако кэш повторно использует только самый длинный неизменный префикс запроса. Наш агент кэшировал свои инструменты и системный промпт, но не историю, и одного лишь кэширования истории было бы недостаточно: агент удалял предыдущий скриншот на каждом этапе и обрезал более старый текст, чтобы уложиться в лимит истории. Каждое изменение затрагивало более раннюю часть запроса, поэтому повторное использование не срабатывало почти при каждом вызове.
Решение
Во-первых, также кэшировать историю с маркером кэша на последнем результате работы инструмента. Во-вторых, прекратить редактировать его при каждом вызове. При пакетной очистке скриншоты сохраняются и удаляются пакетами: при соотношении 20:1 агент сохраняет до 20 скриншотов, а затем сокращает их количество до 1, поэтому примерно 19 последовательных вызовов повторно используют сохраненную в кэше историю. Мы также увеличили лимит истории со 120 000 до 480 000 символов, чтобы старый текст больше не обрезался.

Как мы это сделали
GPT-6 Astra, работая в Codex, выполнила основную часть работы: провела аудит кода, инструментализировала каждый запрос, выполнила быстрые тесты для выявления важных переменных, рефакторила код для параллельного выполнения рабочих процессов, запустила прогоны и проанализировала трассировки. Люди ставили цель и определяли стандарты, а также проверяли выводы. Платформа доставки программного обеспечения Asana под названием Command выступала в роли системы учёта: в ней регистрировались запросы, трассировки и результаты каждой сессии, что позволяло нам впоследствии проанализировать всё исследование целиком, а полученные результаты превращались в тикеты, заявки на внесение изменений и проверенные изменения, которые затем внедрялись.


Я никогда не думал делать это вручную, поскольку это, вероятно, заняло бы у меня несколько месяцев. С Codex это заняло около недели: я ставил /цель перед сном и просматривал результаты утром.
Теперь каждая ночь, когда наши агенты не работают, кажется потраченной впустую.
Мы протестировали шесть политик кэширования и истории с двумя бюджетами на GPT-6.1 Sol и трёх других передовых моделях — моделях A, B и C (см. таблицу ниже) — с тремя запусками на каждое условие: 144 запуска плюс 12 последующих запусков. Мы рассчитывали затраты по счётчикам токенов каждого провайдера, и каждый ответ оценивался по независимо подготовленному эталону.
Модель | Что это такое | Цена |
Модель A | Менее крупная и более дешевая модель от другой передовой лаборатории, выпущенная осенью 2025 года | Половина цены GPT-6.1 Sol |
Модель B | Модель, первоначально использовавшаяся в производстве, из той же лаборатории, что и модель A, выпущенная летом 2026 года | Такая же, как у GPT-6.1 Sol |
Модель C | Более новая версия модели B, выпущенная осенью 2026 года | То же, что и GPT-6.1 Sol |
GPT-6.1 Sol | Модель OpenAI | Для справки |
Результаты

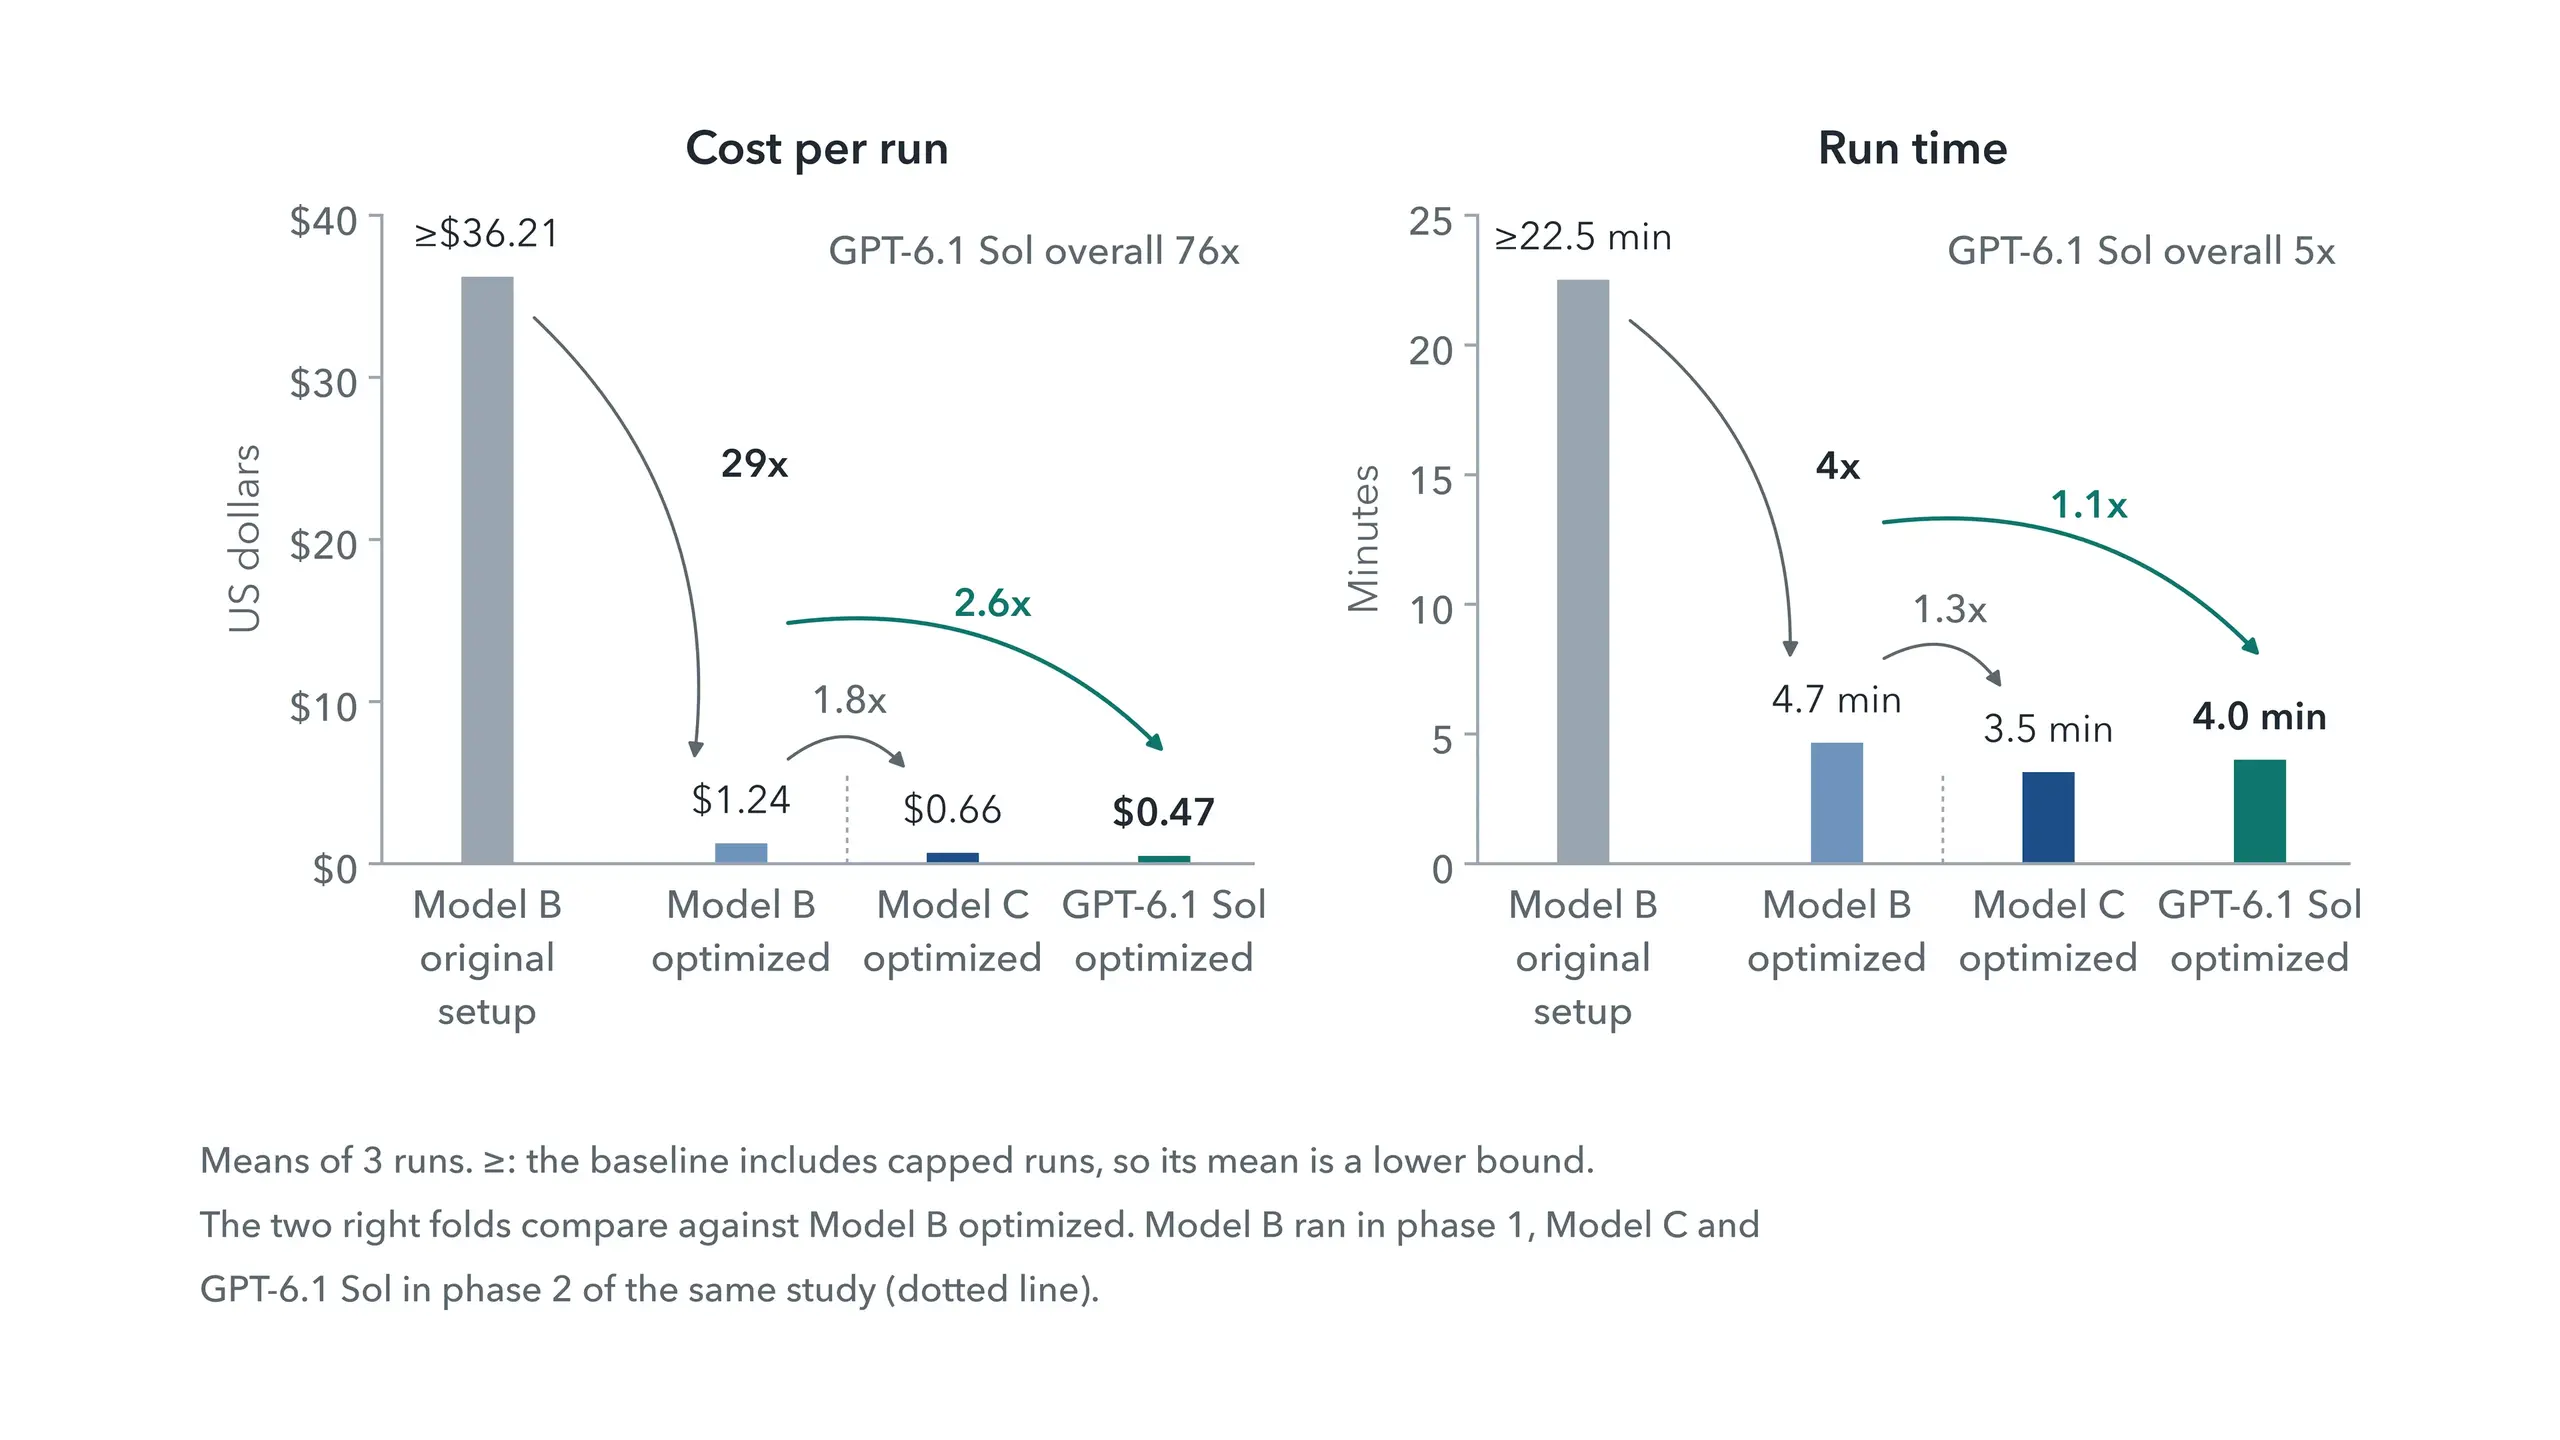
В модели B наилучшие условия позволили снизить стоимость одного запуска в 29 раз и повысить скорость выполнения в 4 раза по сравнению с исходной производственной конфигурацией. На GPT-6.1 Sol тот же агент стоил в 76 раз меньше и работал в 5 раз быстрее, считывая 89% входных данных из кэша. На каждой модели каждый запуск в оптимальных условиях стоил меньше, чем каждый базовый запуск, и при этом обрабатывал все 192 факта.
Выводы
Бюджет должен соответствовать модели. Более новые модели быстрее расходовали меньший бюджет: модель C впервые сократила свою историю на 10-м вызове, а модель A — на 64-м. При 120 000 символов модель C не дала ответа ни в одном из 18 запусков, а Sol — в 3, причем в большинстве случаев был достигнут лимит шагов; при 480 000 символов обе модели дали ответ в каждом запуске.
Одного лишь кэширования недостаточно. Без пакетной обрезки кэширование истории при большем бюджете обходилось дороже, чем отсутствие кэширования, для трех из четырех моделей: кэш постоянно перезаписывался и редко считывался.
Нужна ли вообще обрезка?
Данные по каждому вызову показали, что в данном случае отсечение, возможно, не требуется, поэтому в ходе последующего эксперимента сохранялся каждый снимок экрана. Стоимость одного вызова была в 1,2 раза ниже, чем при наилучших условиях для моделей B и Sol, и примерно на 5 % ниже, чем для модели C. Отсечение по-прежнему имеет значение для длительных задач, небольших окон контекста и более дорогостоящего считывания данных из кэша.
При трех или четырех прогонах на одно условие и различном количестве вызовов в разных прогонах это исследование демонстрирует общие закономерности, а не выявляет условия, отличающиеся друг от друга лишь на несколько процентов.
Защитные механизмы по-прежнему важны
Ни один из запусков не достиг лимита в 480 000 символов, поэтому он не ограничивал эти запуски. Ограничения по-прежнему имеют значение: дрейфующий агент приближается к пределу контекста, и если кэш выходит из строя, за каждый вызов приходится платить полную стоимость. Ограничения по количеству шагов, токенов и стоимости одного запуска ограничивают затраты на неудачный запуск. Еще одним вариантом, выходящим за рамки данного исследования, является сжатие.
От результатов к внедрению
Некоторые результаты были получены позже, когда другие агенты проанализировали каждый трейс, зарегистрированный в Command. Это сложно сделать в рамках одного сеанса, когда нельзя быть уверенным, что все данные были сохранены. Хранение всей информации в Command, к которой наши агенты получали доступ через MCP, означало, что нам никогда не приходилось повторять эксперимент для восстановления отсутствующих данных, что ускорило работу. Результаты превращались в тикеты для людей и агентов-программистов, где рассматривались пул-реквесты, а изменения отправлялись в StackAI. После проведения исследования мы также выполнили то же задание с помощью Codex, который сравнил свой подход с подходом агента StackAI и предложил второй раунд улучшений, теперь уже в виде тикетов в Command.
Чему мы научились
Кэшируйте растущую историю, а не только системный промпт.
Используйте историю только для добавления данных; при необходимости очистки удаляйте данные большими пакетами.
Задавайте бюджет истории в соответствии с моделью.
Измеряйте количество обращений к кэшу за вызов с помощью собственных счётчиков провайдера.
Вести полную запись каждого сеанса, чтобы для анализа и последующей работы использовалась одна и та же запись.
Asana разрабатывает инструменты, чтобы сделать подобные эксперименты обычным делом. Полное исследование охватывает методы, результаты и ограничения.
Скорость выпуска больше не является узким местом; теперь это — человеческое внимание. Думаю, мы близки к миру, в котором каждый инженер — это менеджер проектов, управляющий целым парком агентов.