我們如何透過保持快取完整無損,將瀏覽器代理程式的成本降低 76 倍,並使其速度提升 5 倍


一項在 Codex 中使用 GPT-6 Astra 的研究,涵蓋四種模型,從調查程式碼到評估結果。


為什麼我們要研究
Asana 正透過 StackAI 將代理程式工作流程自動化引入其平台,而在 Asana 的規模下,小小的效率低下問題會累積起來。 我們的目標是讓一個瀏覽器代理程式更便宜、更快,同時不降低答案品質。
「這就是人類和代理程式團隊在實務上的運作方式。 工程師確定方向,代理程式執行實驗,結果透過 Command 進入生產階段。 這展示了 Asana 如何將人與代理程式的團隊化為現實。」- Asana 產品長 Arnab Bose
有哪些地方出了問題?
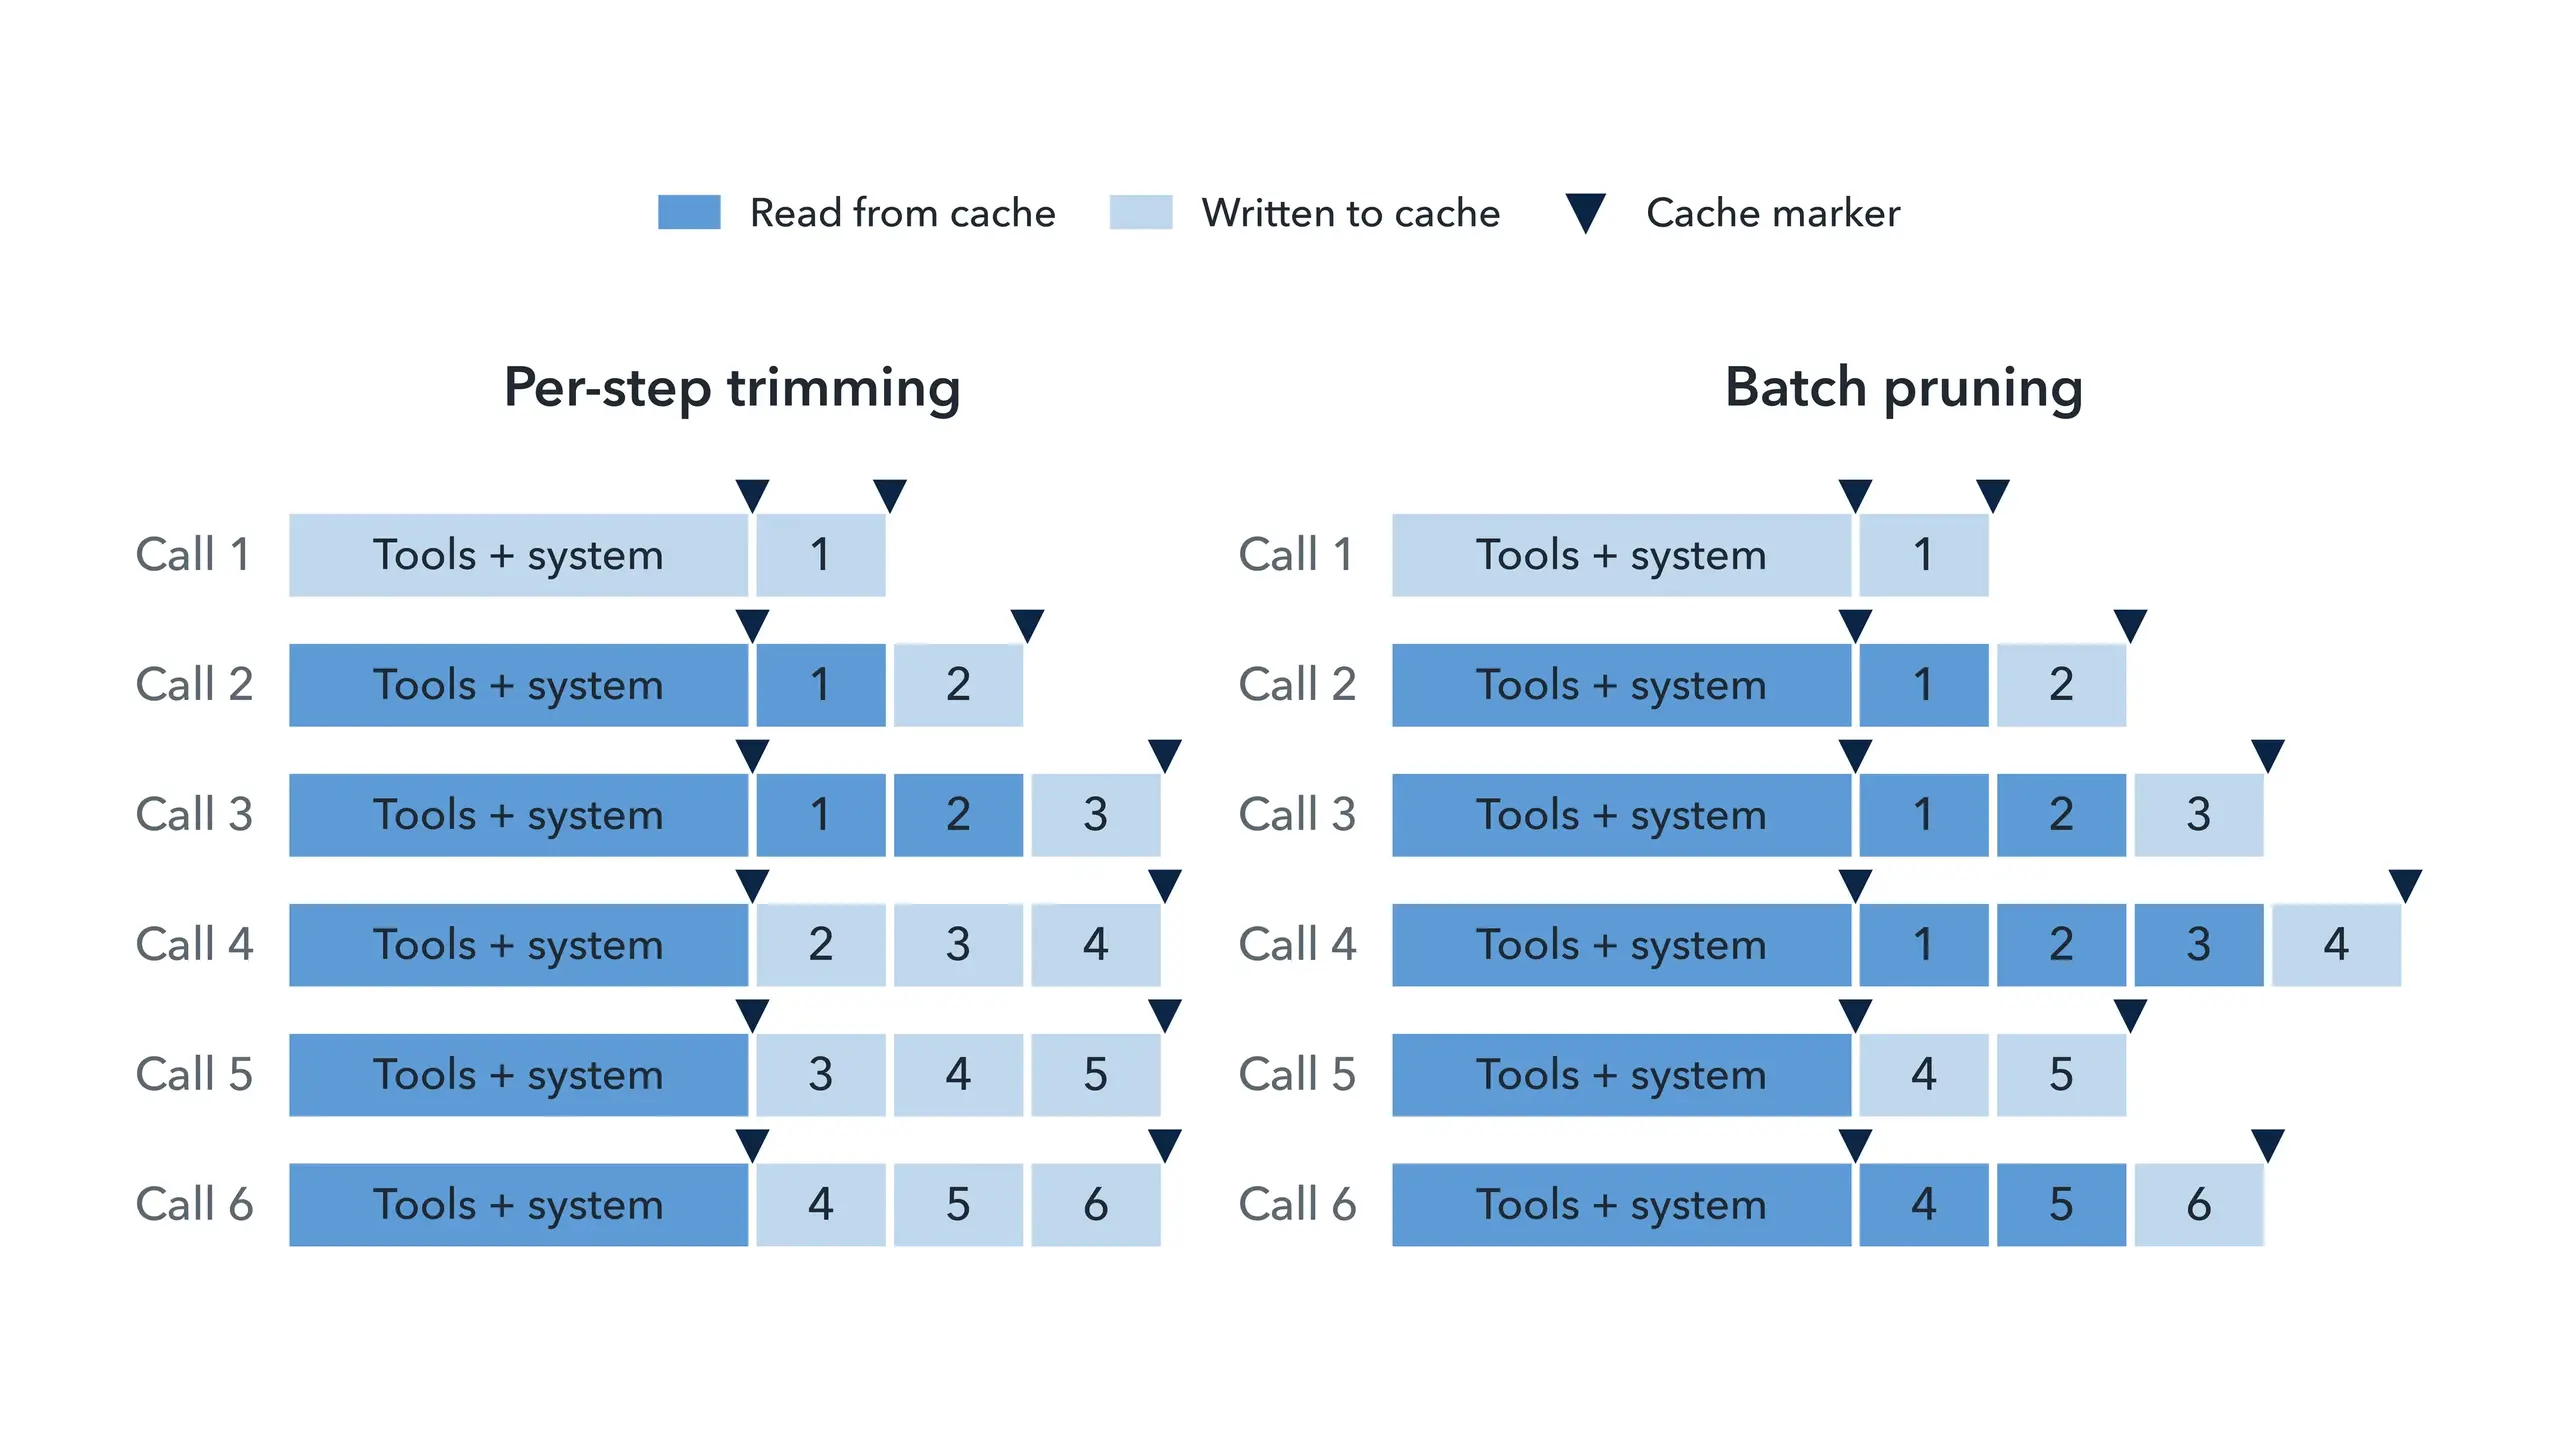
瀏覽器代理程式會在每次呼叫時重新傳送其工具、系統提示以及不斷增加的頁面文字和螢幕截圖歷史記錄。 提示快取可降低重複輸入的成本:在我們測試的模型中,快取讀取的成本是標準輸入價格的 0.05 倍至 0.1 倍。 但快取只會重複使用請求中最長且未變更的前綴。 我們的代理程式將其工具和系統提示快取起來,但沒有快取其歷史紀錄,而單獨快取歷史紀錄並無幫助:代理程式在每個步驟中都會移除先前的螢幕截圖,並修剪較舊的文字以符合歷史紀錄的預算。 每次編輯都會變更請求的前面部分,因此幾乎每次呼叫都會導致重複使用失敗。
解決方法
首先,也要快取歷史紀錄,並在最新的工具結果上加上快取標記。 其次,停止在每次通話中編輯它。 批次修剪會保留螢幕截圖,並以批次方式將其移除:在 20:1 的情況下,代理程式會保留最多 20 個螢幕截圖,然後再減少至 1 個,因此大約有 19 次連續呼叫會重複使用快取歷史紀錄。 我們還將歷程紀錄的預算從 12 萬個字元增加到 48 萬個字元,因此舊的文字不再被截斷。

我們如何執行
在 Codex 中運作的 GPT-6 Astra 完成了大部分的工作:它稽核程式碼、對每個請求進行插樁、執行快速測試以識別重要的變數、重構程式碼以併行執行工作流程、啟動執行並分析追蹤。 人類設定目標和標準,並審查結論。 Asana 的軟體交付平台 Command 是紀錄系統:每個工作階段的請求、追蹤和結果都會記錄在其中,因此我們之後可以分析整個研究,而這些發現則成為了聯絡單、提取請求和已審核的變更。


我從來沒有想過要手動完成,因為這可能需要花上我好幾個月的時間。 使用 Codex 大約花了一週的時間:我會在睡前設定一個 /目標,然後在早上查看結果。
現在,每當我們的代理程式沒有在運作時,都感覺像是浪費了一個晚上。
我們在 GPT-6.1 Sol 和其他三個尖端模型 (模型 A、B 和 C,見下表) 上,以兩種預算測試了六種快取和歷史記錄政策,每個條件執行三次:共 144 次執行,外加 12 次後續執行。 我們根據每個提供者的權杖計數器計算成本,並根據獨立準備的參考資料對每個答案進行評分。
模型 | 這是什麼 | 價格 |
模型 A | 來自另一個尖端實驗室的較小、成本較低的模型,於 2025 年秋季發布 | GPT-6.1 Sol 價格的一半 |
模型 B | 最初用於生產的模型,來自與模型 A 相同的實驗室,於 2026 年夏季發佈 | 與 GPT-6.1 Sol 相同 |
模型 C | 模型 B 的較新版本,於 2026 年秋季發佈 | 與 GPT-6.1 Sol 相同 |
GPT-6.1 Sol | OpenAI 的模型 | 參照 |
結果

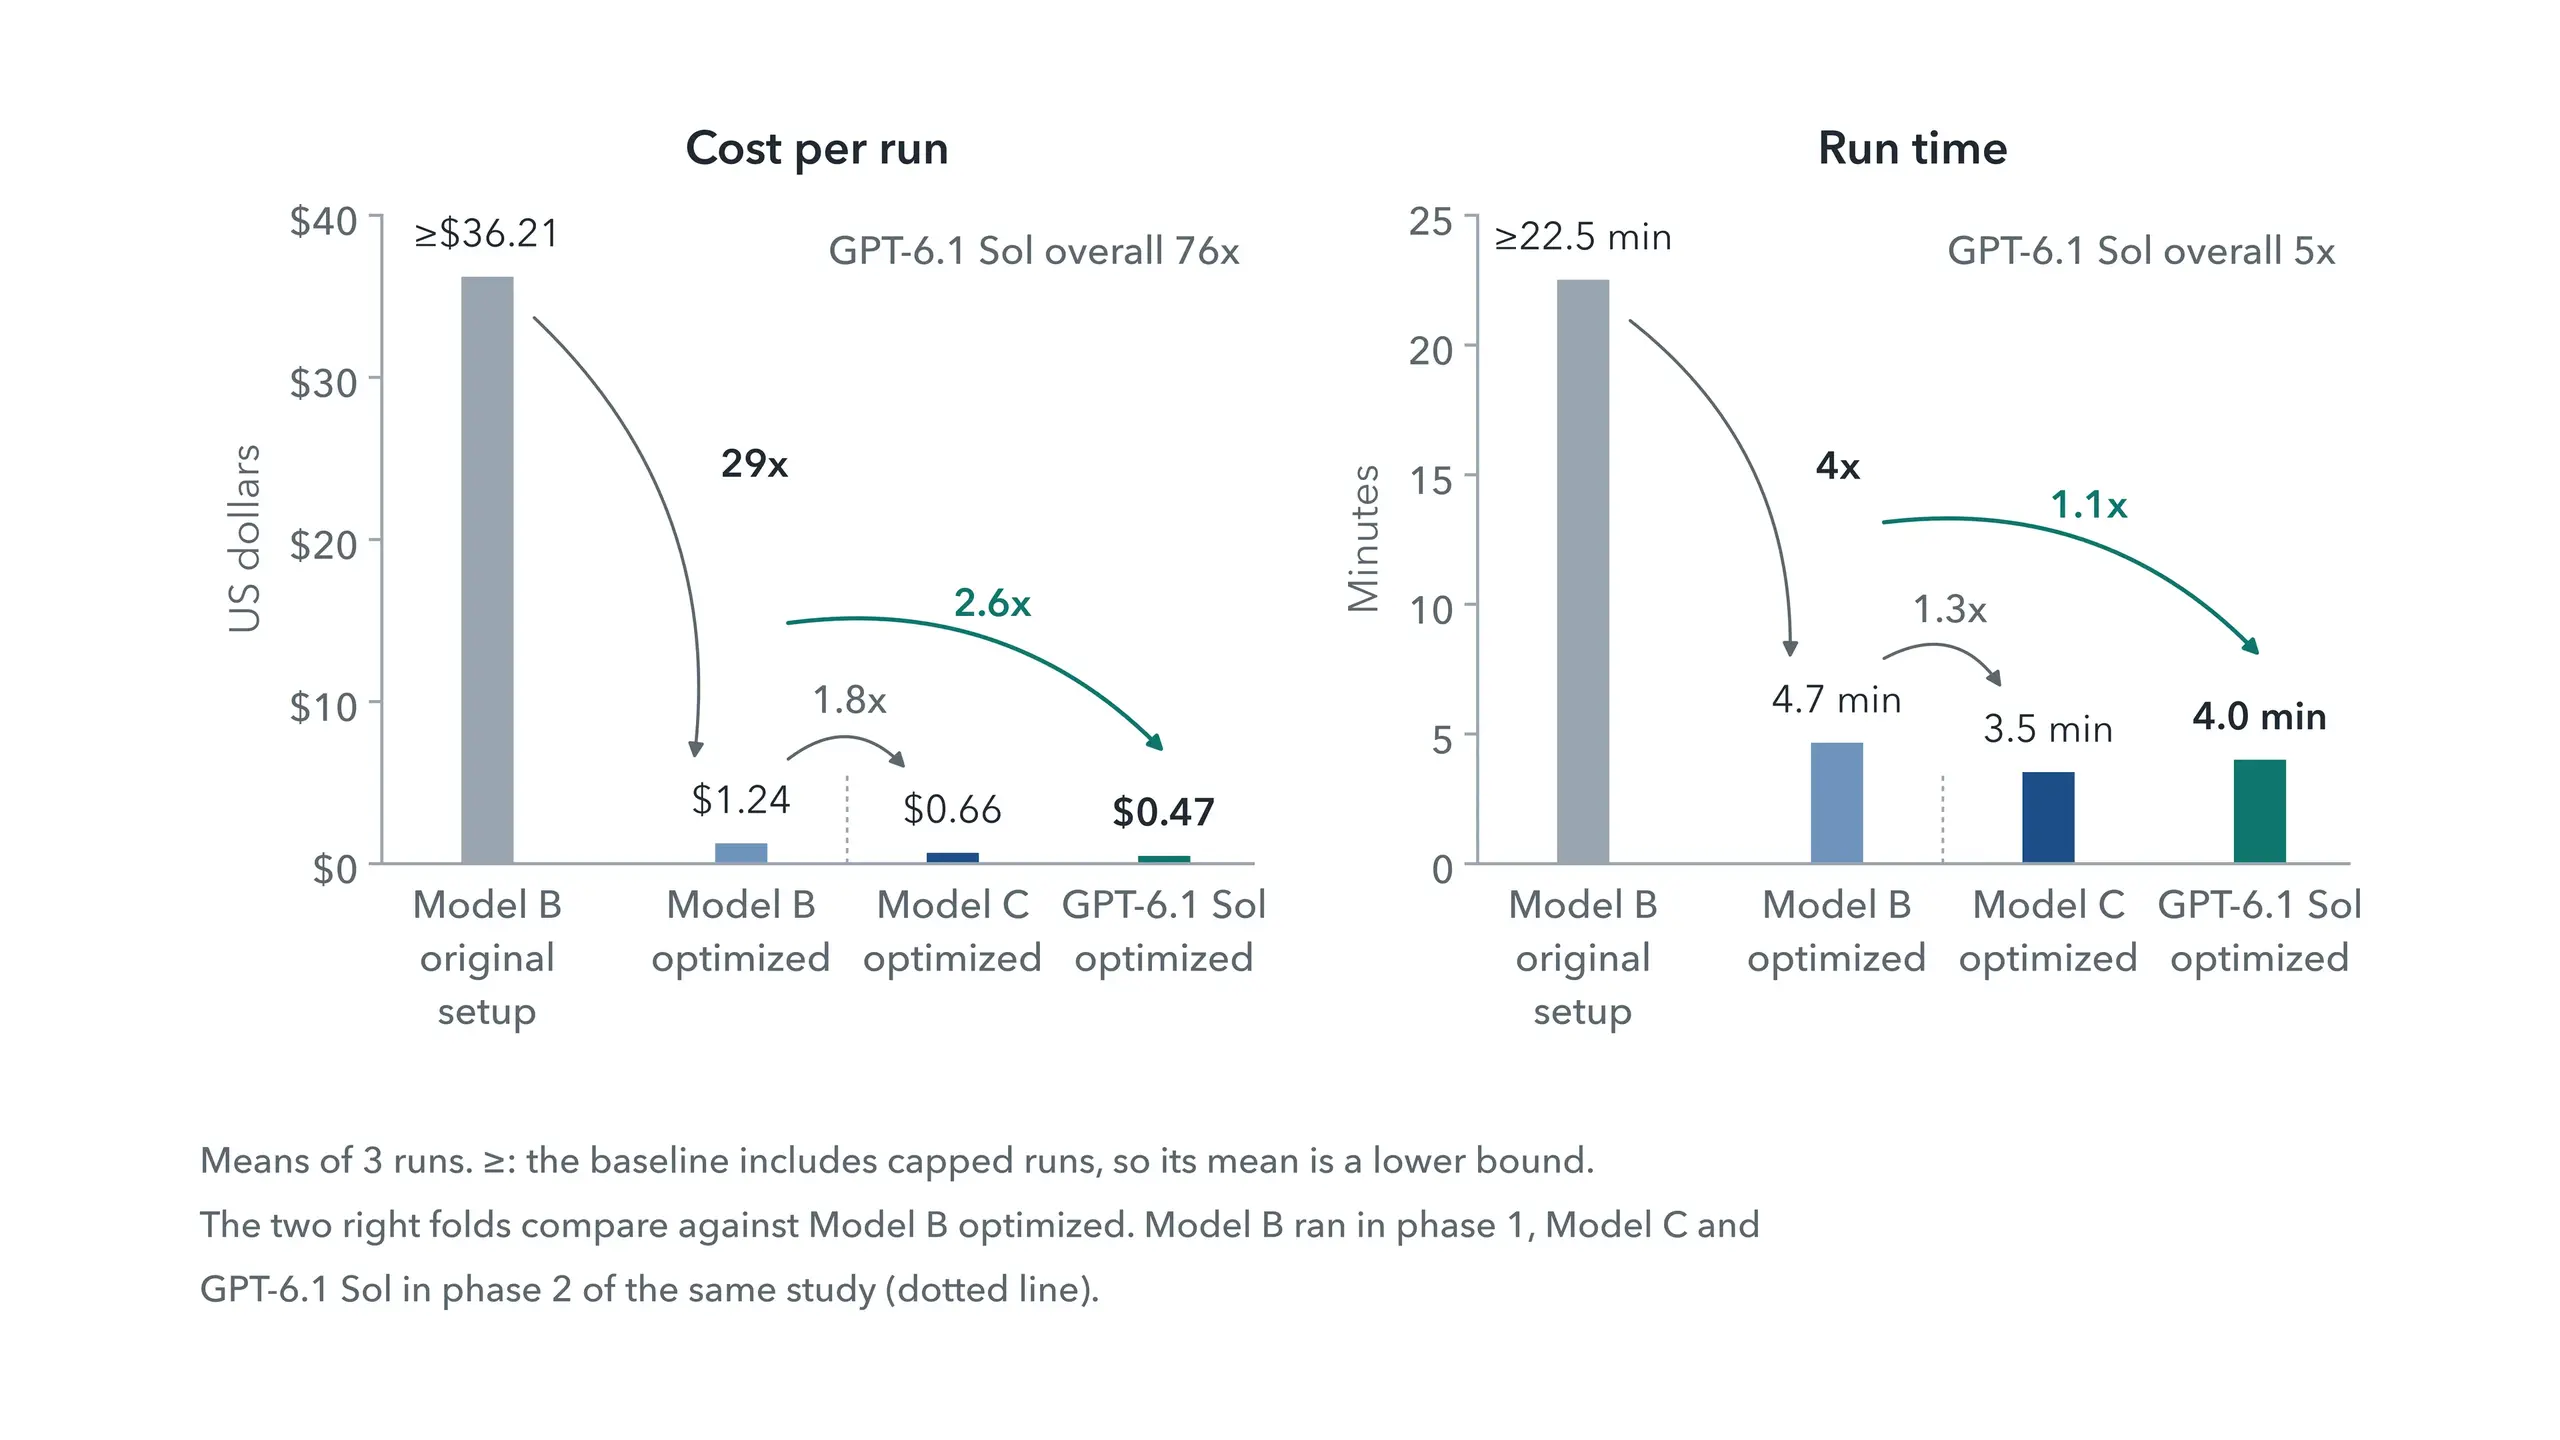
在模型 B 上,最佳條件使每次執行的成本降低了 29 倍,且執行速度比原始生產設定快了 4 倍。 在 GPT-6.1 Sol 上,同一代理程式的成本降低了 76 倍,執行速度提高了 5 倍,並從快取中讀取了 89% 的輸入內容。 在每個模型上,每個最佳條件的執行成本都低於每個基準的執行成本,並遇到了所有 192 個事實。
經驗
預算必須符合模型。 較新的模型更快用完較少的預算:模型 C 在第 10 次呼叫時首次縮減其歷史紀錄,模型 A 則是在第 64 次呼叫時。 在 12 萬個字元的情況下,模型 C 在 18 次執行中均未回答,而 Sol 在 3 次執行中回答,大多數都達到步驟上限;在 48 萬個字元的情況下,兩者在每次執行中均有回答。
單靠快取是不夠的。 若沒有批次修剪,在較大預算下快取歷史記錄的成本,比在四個模型中的三個模型上不快取歷史記錄的成本更高:快取不斷被覆寫,且很少被讀取。
您是否真的需要進行修剪?
每次呼叫的資料顯示,在此處可能不需要進行修剪,因此後續追蹤保留了每個螢幕擷取畫面。 每次呼叫的成本比模型 B 和 Sol 的最佳條件低 1.2 倍,比模型 C 低約 5%。對於長時間任務、較小的上下文視窗和成本較高的快取讀取,修剪仍然很重要。
每個條件執行三到四次,且每次執行的呼叫次數各不相同,本研究顯示出整體模式,而非區分僅相差幾個百分點的條件。
防護機制仍然重要
沒有任何執行達到 480,000 個字元的預算,因此沒有對這些執行造成限制。 限制仍然很重要:偏離的代理程式會朝著情境限制的方向發展,如果快取中斷,每次呼叫都要支付全額費用。 步驟、權杖和每次執行的成本上限可限制不良執行的成本。 壓縮是另一個選項,但不在本研究的範疇內。
從調查結果到生產
當其他代理程式審查記錄到 Command 的每個追蹤時,後來出現了一些發現。 這在單一工作階段中很難做到,因為您無法確定所有資料都已儲存。 將所有內容都保存在 Command 中(我們的代理程式透過 MCP 存取),這意味著我們從來不需要重複實驗來恢復遺失的資料,從而加快了工作進度。 發現結果成為人類與程式碼撰寫代理程式的聯絡單,在此審查了提取請求,並將變更交付給 StackAI。 自研究結束以來,我們也使用 Codex 執行了相同的任務,將其方法與 StackAI 代理程式的方法進行比較,並建議進行第二輪的改進,現在這些改進已成為 Command 中的支援單。
我們的收穫
快取不斷增加的歷史紀錄,而不僅僅是系統提示。
讓歷史紀錄僅限附加;當需要修剪時,請以大批次進行修剪。
設定歷史紀錄預算以適應模型。
使用提供者自己的計數器測量每次呼叫的快取讀取次數。
保留每個工作階段的完整記錄,以便分析和後續工作使用相同的記錄。
Asana 正在建置工具,讓這類實驗成為常規。 完整的研究涵蓋方法、結果和限制。
出貨速度不再是瓶頸;人類的注意力才是。 我認為我們正接近一個每個工程師都是產品經理,領導著一群代理程式的世界。