Come abbiamo ridotto di 76 volte il costo di un agente browser e lo abbiamo reso 5 volte più veloce mantenendo intatta la sua cache


Uno studio con GPT-6 Astra in Codex su quattro modelli, dall'analisi del codice alla misurazione dei risultati


Perché abbiamo condotto lo studio
Asana sta introducendo l'automazione dei flussi di lavoro degli agenti nella sua piattaforma tramite StackAI e, alle dimensioni di Asana, le piccole inefficienze si sommano. Il nostro obiettivo era quello di rendere un agente browser più economico e più veloce senza ridurre la qualità delle risposte.
“Ecco come sono in pratica i team composti da persone e agenti. Un tecnico ha stabilito la direzione, un agente ha condotto gli esperimenti e i risultati sono passati attraverso Command per arrivare alla produzione. Questo dimostra come Asana dia vita ai team composti da persone e agenti.” - Arnab Bose, CPO di Asana
Cosa non andava
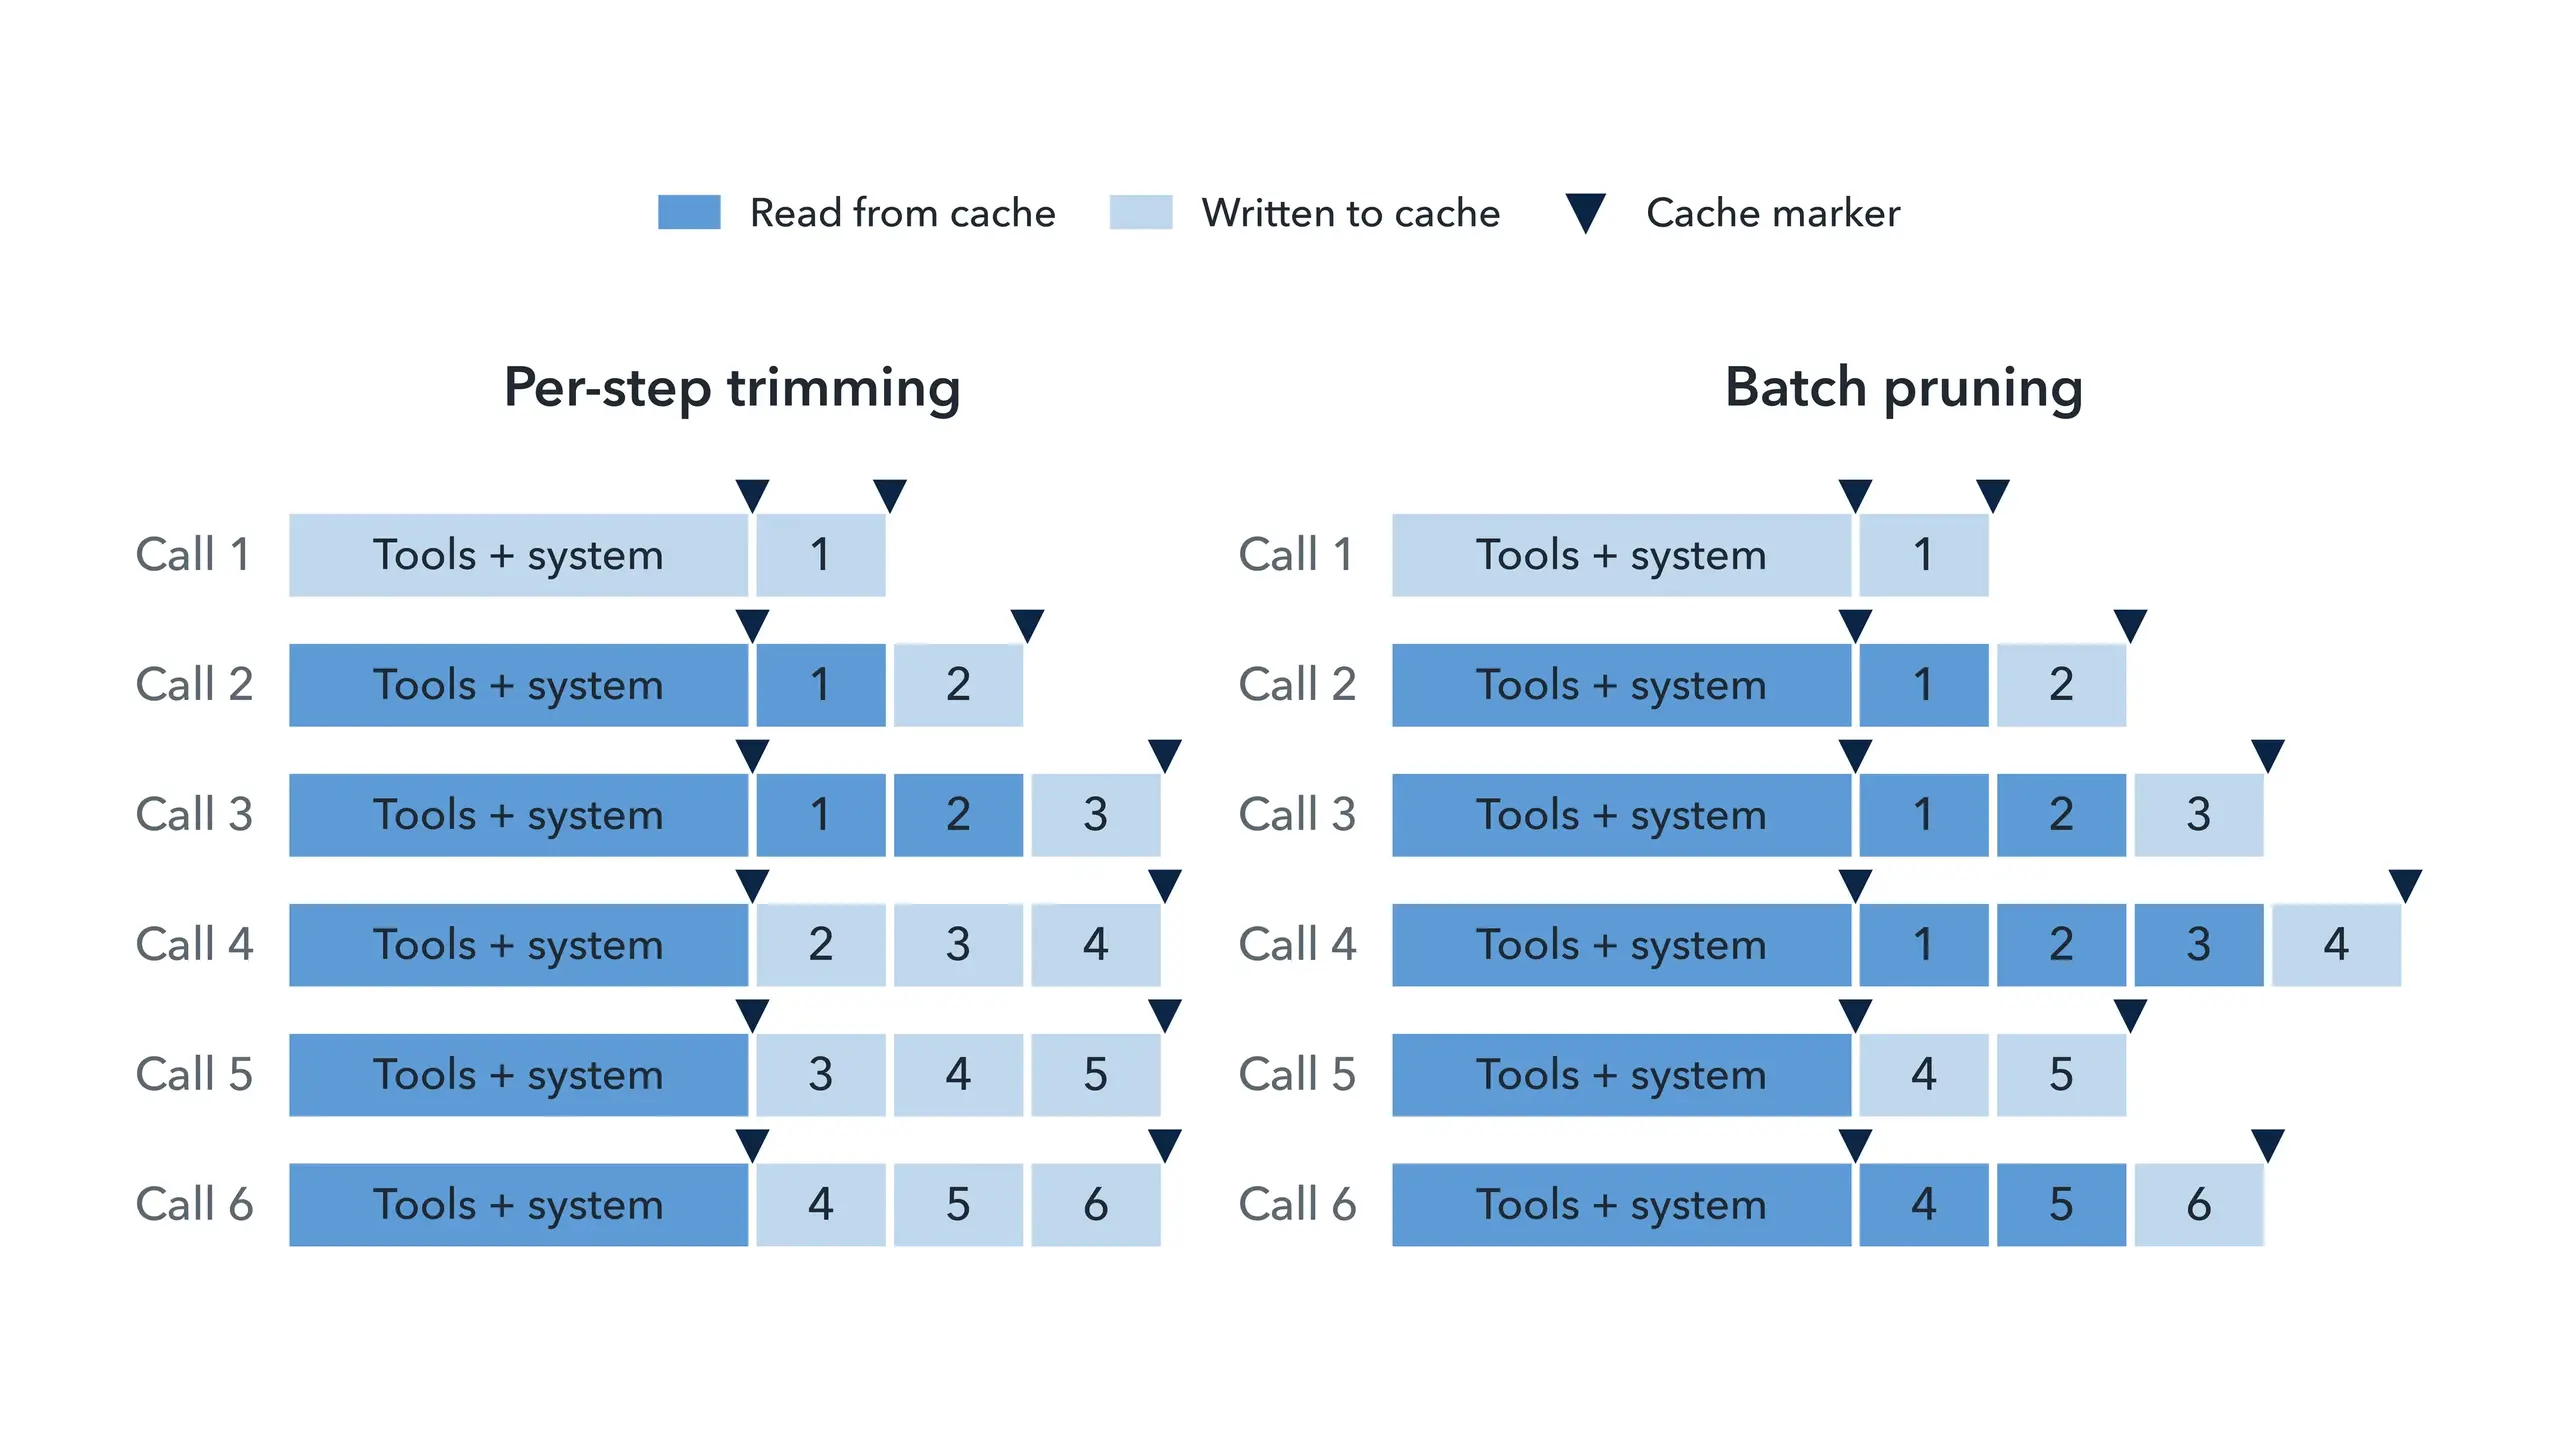
Un agente browser reinvia i suoi strumenti, il prompt di sistema e la cronologia in costante aumento del testo della pagina e degli screenshot a ogni chiamata. Il caching dei prompt riduce il costo degli input ripetuti: sui modelli che abbiamo testato, le letture dalla cache costano da 0,05 a 0,1 volte il prezzo standard dell'input. Tuttavia, una cache riutilizza solo il prefisso più lungo di una richiesta che non è stato modificato. Il nostro agente ha memorizzato nella cache i suoi strumenti e il prompt di sistema, ma non la sua cronologia, e la sola memorizzazione nella cache della cronologia non sarebbe stata utile: l'agente ha rimosso lo screenshot precedente a ogni passaggio e ha ridotto il testo più vecchio per adattarlo a un budget di cronologia. Ogni modifica alterava una parte precedente della richiesta, quindi il riutilizzo non funzionava in quasi tutte le chiamate.
La soluzione
Innanzitutto, memorizzare nella cache anche la cronologia, con un indicatore di cache sull'ultimo risultato dello strumento. In secondo luogo, smettere di modificarla a ogni chiamata. La rimozione in batch conserva gli screenshot e li elimina in batch: con un rapporto di 20:1, l'agente ne conserva fino a 20 e poi li riduce a 1, quindi circa 19 chiamate consecutive riutilizzano la cronologia memorizzata nella cache. Abbiamo anche aumentato il budget della cronologia da 120.000 a 480.000 caratteri, in modo che il testo precedente non venisse più tagliato.

Come lo abbiamo eseguito
GPT-6 Astra, operando in Codex, ha svolto la maggior parte del lavoro: ha verificato il codice, strumentato ogni richiesta, eseguito test rapidi per identificare le variabili rilevanti, rifattorizzato il codice per eseguire i flussi di lavoro in parallelo, avviato le esecuzioni e analizzato le tracce. Gli esseri umani hanno definito l'obiettivo e gli standard e hanno esaminato le conclusioni. Command, la piattaforma di consegna del software di Asana, è stata il sistema di registrazione: le richieste, le tracce e i risultati di ogni sessione sono stati registrati lì, in modo da poter analizzare l'intero studio in seguito, e i risultati sono diventati ticket, pull request e modifiche revisionate che sono state rilasciate.


Non ho mai pensato di farlo manualmente, perché probabilmente ci avrei impiegato mesi. Con Codex, ci è voluta circa una settimana: impostavo un /obiettivo prima di andare a dormire e controllavo i risultati al mattino.
Ora, ogni notte in cui i nostri agenti non sono in esecuzione sembra una notte sprecata.
Abbiamo testato sei policy di caching e cronologia con due budget su GPT-6.1 Sol e su altri tre modelli all'avanguardia, i modelli A, B e C (tabella seguente), con tre esecuzioni per condizione: 144 esecuzioni, più un follow-up di 12 esecuzioni. Abbiamo calcolato i costi in base ai contatori di token di ciascun provider e ogni risposta è stata valutata rispetto a un riferimento preparato in modo indipendente.
Modello | Di cosa si tratta | Prezzo |
Modello A | Un modello più piccolo e meno costoso di un altro laboratorio all'avanguardia, lanciato nell'autunno del 2025 | La metà del prezzo di GPT-6.1 Sol |
Modello B | Il modello originariamente utilizzato in produzione, proveniente dallo stesso laboratorio del modello A, lanciato nell'estate 2026 | Uguale a GPT-6.1 Sol |
Modello C | Una versione più recente del modello B, rilasciata nell'autunno 2026 | Uguale a GPT-6.1 Sol |
GPT-6.1 Sol | Modello di OpenAI | Riferimenti |
Risultati

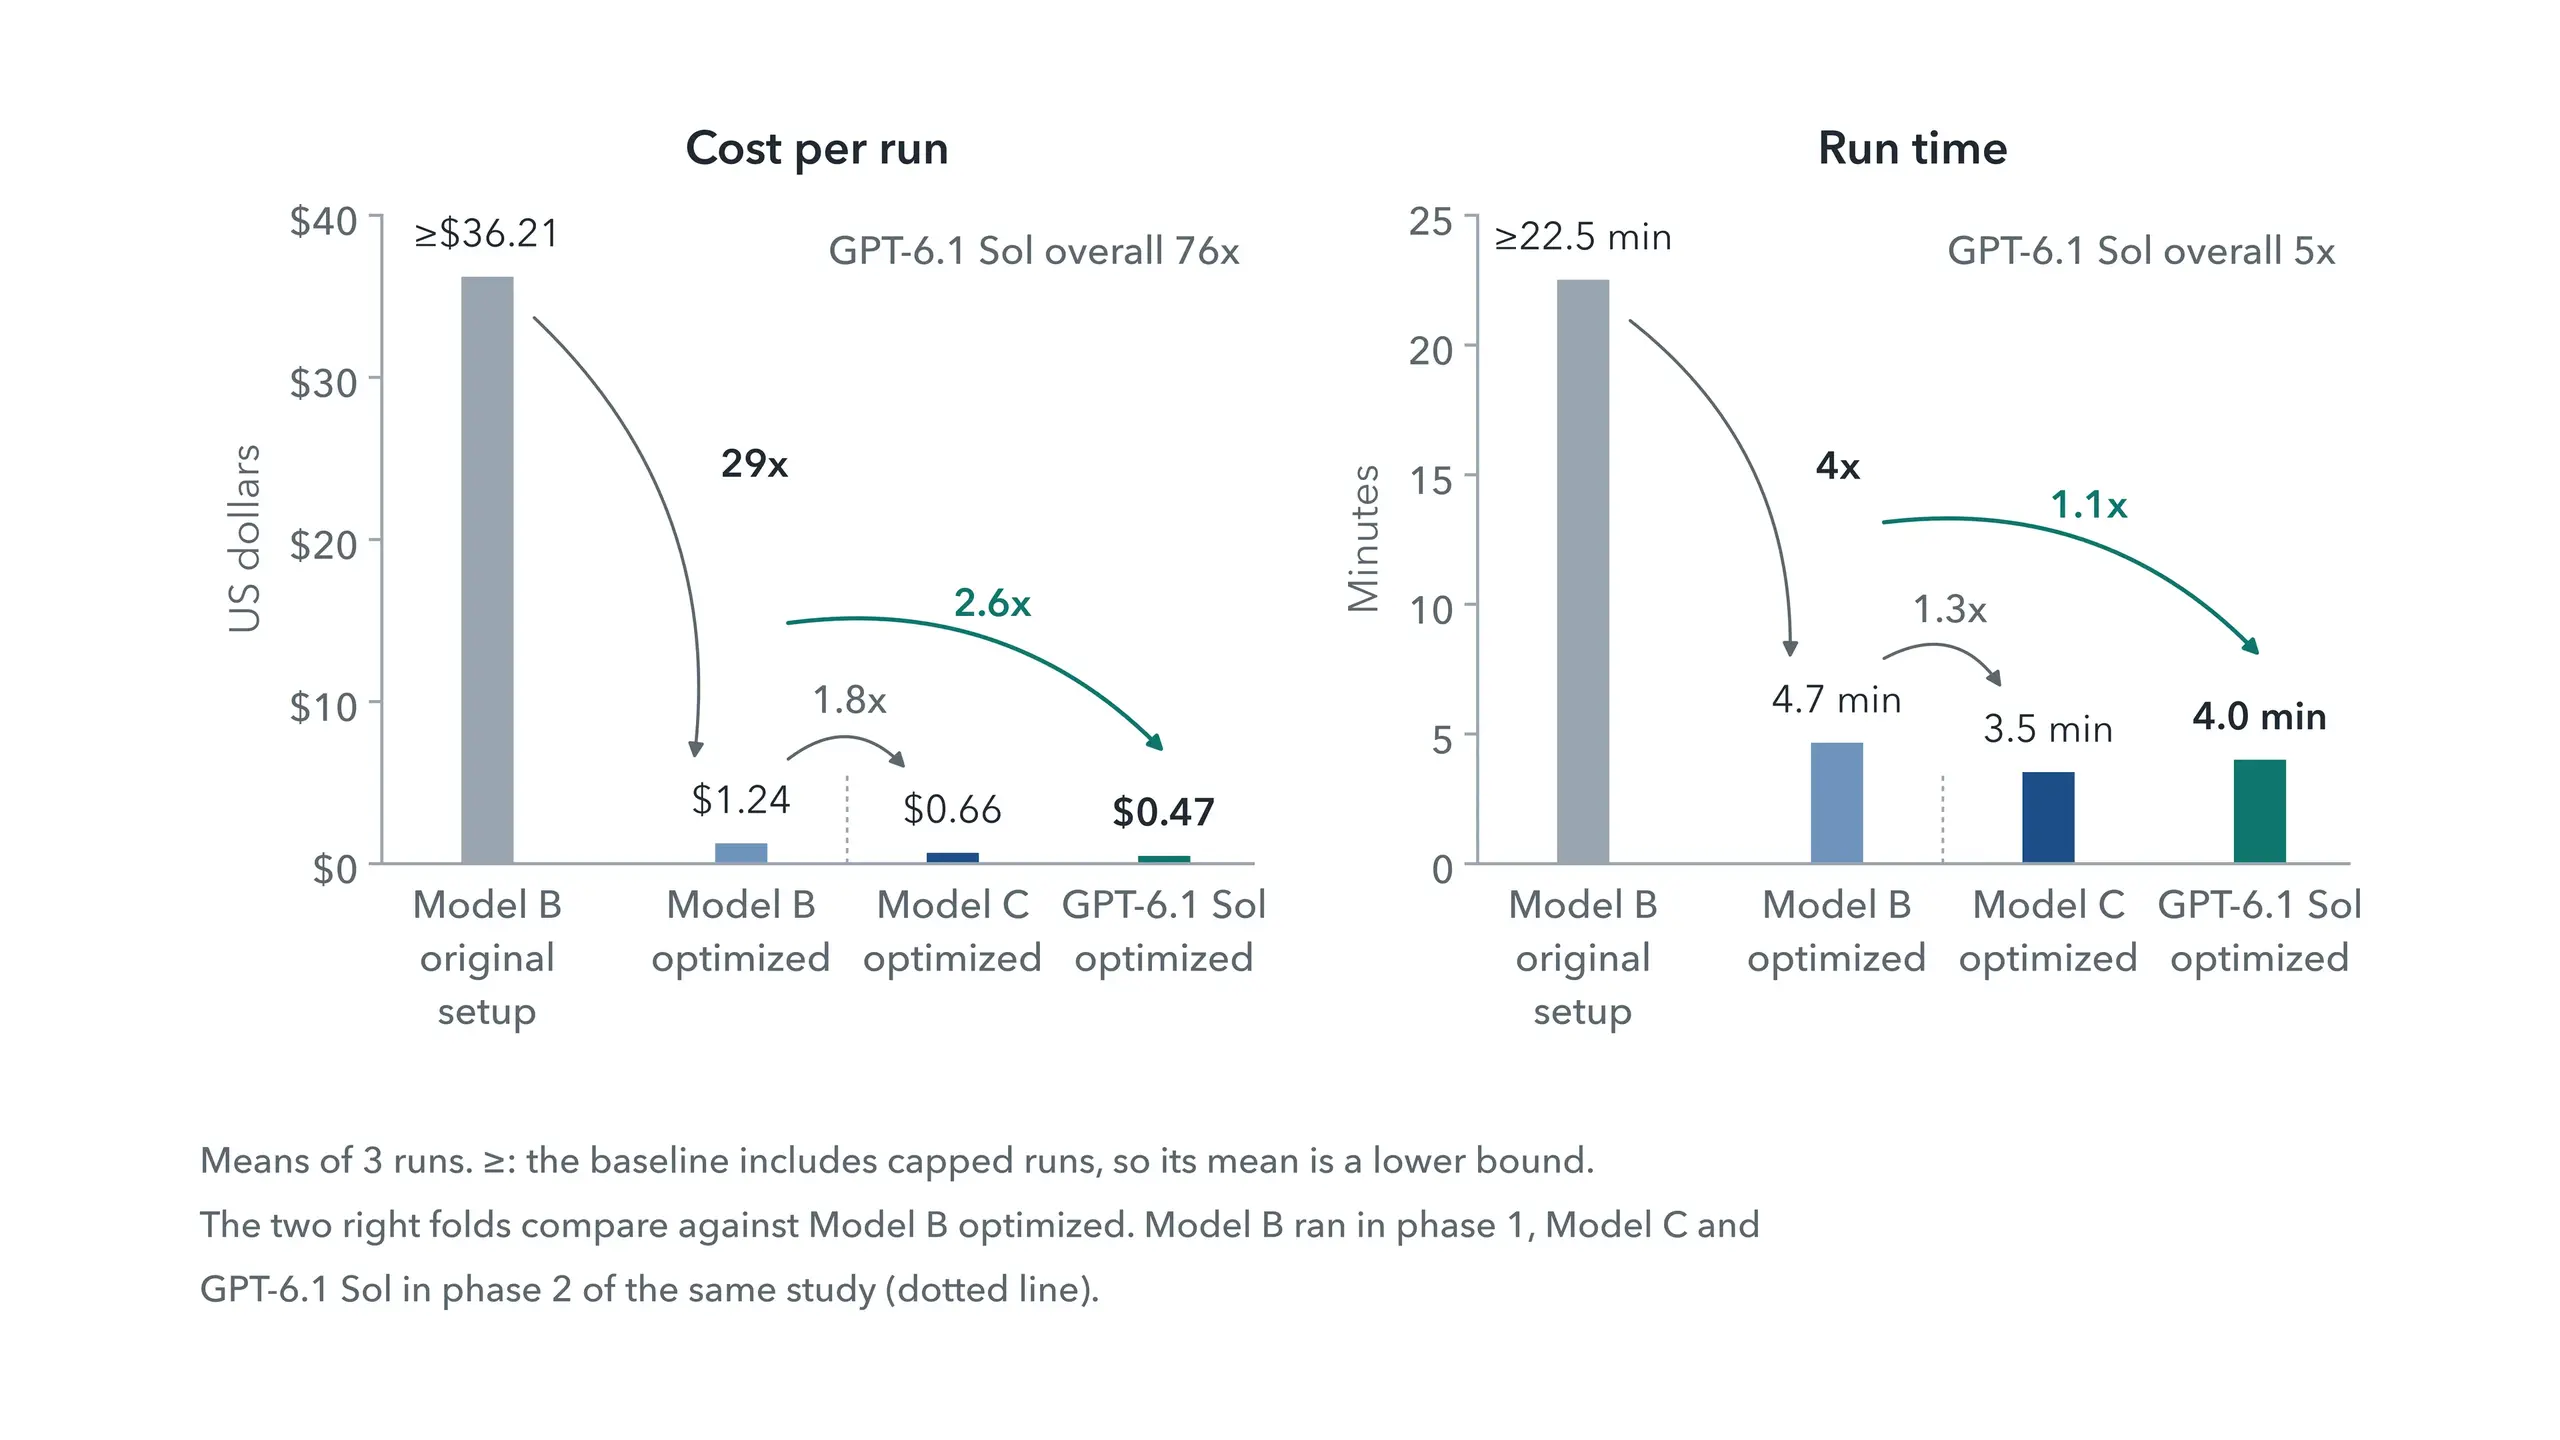
Sul modello B, la condizione migliore ha ridotto il costo per esecuzione di 29 volte e ha eseguito l'operazione 4 volte più velocemente rispetto alla configurazione di produzione originale. Su GPT-6.1 Sol, lo stesso agente è costato 76 volte di meno ed è stato eseguito 5 volte più velocemente, leggendo l'89% del suo input dalla cache. Su ogni modello, ogni esecuzione nelle condizioni ottimali è costata meno di ogni esecuzione di riferimento e ha rilevato tutti i 192 fatti.
Apprendimenti
Il budget deve essere adeguato al modello. I modelli più recenti hanno esaurito il budget inferiore più rapidamente: il modello C ha ridotto per la prima volta la propria cronologia alla chiamata 10, il modello A alla chiamata 64. A 120.000 caratteri, il modello C non ha risposto in nessuna delle 18 esecuzioni e Sol in 3, raggiungendo per lo più il limite di passaggi; a 480.000, entrambi hanno risposto in ogni esecuzione.
La sola memorizzazione nella cache non è sufficiente. Senza il pruning in batch, il caching della cronologia con il budget più elevato è costato di più rispetto al non caching in tre modelli su quattro: la cache è stata continuamente riscritta e raramente letta.
È davvero necessario eseguire il pruning?
I dati per chiamata suggerivano che il pruning potesse non essere necessario in questo caso, quindi un'attività di follow-up ha conservato ogni schermata. Il costo per chiamata è stato 1,2 volte inferiore rispetto alla condizione migliore sul modello B e su Sol, e circa il 5% inferiore sul modello C. Il pruning è comunque importante per le attività lunghe, le finestre di contesto di piccole dimensioni e le letture dalla cache più costose.
Con tre o quattro esecuzioni per condizione e conteggi delle chiamate che variano tra un'esecuzione e l'altra, questo studio mostra modelli generali piuttosto che distinguere condizioni che differiscono solo di pochi punti percentuali.
I guardrail sono ancora importanti
Nessuna esecuzione ha raggiunto il budget di 480.000 caratteri, pertanto non ha rappresentato un vincolo per queste esecuzioni. I limiti sono ancora importanti: un agente che si discosta tende ad avvicinarsi al limite del contesto e, se la cache si interrompe, ogni chiamata comporta il pagamento del prezzo pieno. I limiti di fasi, token e costi per esecuzione riducono il costo di un'esecuzione non riuscita. La compattazione è un'altra opzione, che esula dall'ambito di questo studio.
Dai risultati alla produzione
Alcuni risultati sono emersi successivamente, quando altri agenti hanno esaminato ogni traccia registrata su Command. È difficile farlo da una singola sessione, in cui non si può essere sicuri che tutti i dati siano stati memorizzati. Avere tutto su Command, a cui i nostri agenti hanno avuto accesso tramite MCP, ha significato non dover mai ripetere un esperimento per recuperare i dati mancanti, il che ha accelerato il lavoro. I risultati sono diventati ticket per le persone e gli agenti di programmazione, le richieste pull sono state esaminate lì e le modifiche sono state inviate a StackAI. Dopo lo studio, abbiamo eseguito la stessa attività anche con Codex, che ha confrontato il suo approccio con quello dell'agente StackAI e ha suggerito una seconda serie di miglioramenti, ora sotto forma di ticket su Command.
Cosa abbiamo imparato
Memorizza nella cache la cronologia in crescita, non solo il prompt di sistema.
Mantenere la cronologia in modalità di sola aggiunta; quando è necessario eseguire il pruning, farlo in batch di grandi dimensioni.
Impostare il budget della cronologia in base al modello.
Misurare le letture della cache per chiamata utilizzando i contatori del provider.
Conservare una registrazione completa di ogni sessione, in modo che l'analisi e le attività di follow-up utilizzino la stessa registrazione.
Asana sta sviluppando strumenti per rendere esperimenti come questo una prassi abituale. Lo studio completo illustra metodi, risultati e limitazioni.
La velocità di consegna non è più il collo di bottiglia; lo è l'attenzione umana. Penso che ci stiamo avvicinando a un mondo in cui ogni ingegnere è un PM che guida una flotta di agenti.