캐시를 그대로 유지하여 브라우저 에이전트의 비용을 76배 절감하고 속도를 5배 향상시킨 방법


코드 조사부터 결과 측정까지 4가지 모델에 걸쳐 Codex에서 GPT-6 Astra를 사용한 연구


조사한 이유
Asana는 StackAI를 통해 플랫폼에 에이전트 워크플로 자동화를 도입하고 있으며, Asana의 규모에서는 사소한 비효율성이 누적됩니다. 저희의 목표는 답변 품질을 저하시키지 않으면서 하나의 브라우저 에이전트를 더 저렴하고 빠르게 만드는 것이었습니다.
“이것이 바로 사람과 에이전트의 팀이 실제로 어떤 모습인지 보여줍니다. 엔지니어가 방향을 설정하고, 에이전트가 실험을 수행했으며, 결과는 Command를 통해 운영 환경으로 전달되었습니다. 이는 Asana가 어떻게 인간+에이전트 팀을 실현하는지 보여줍니다.” - Asana의 CPO Arnab Bose
문제점
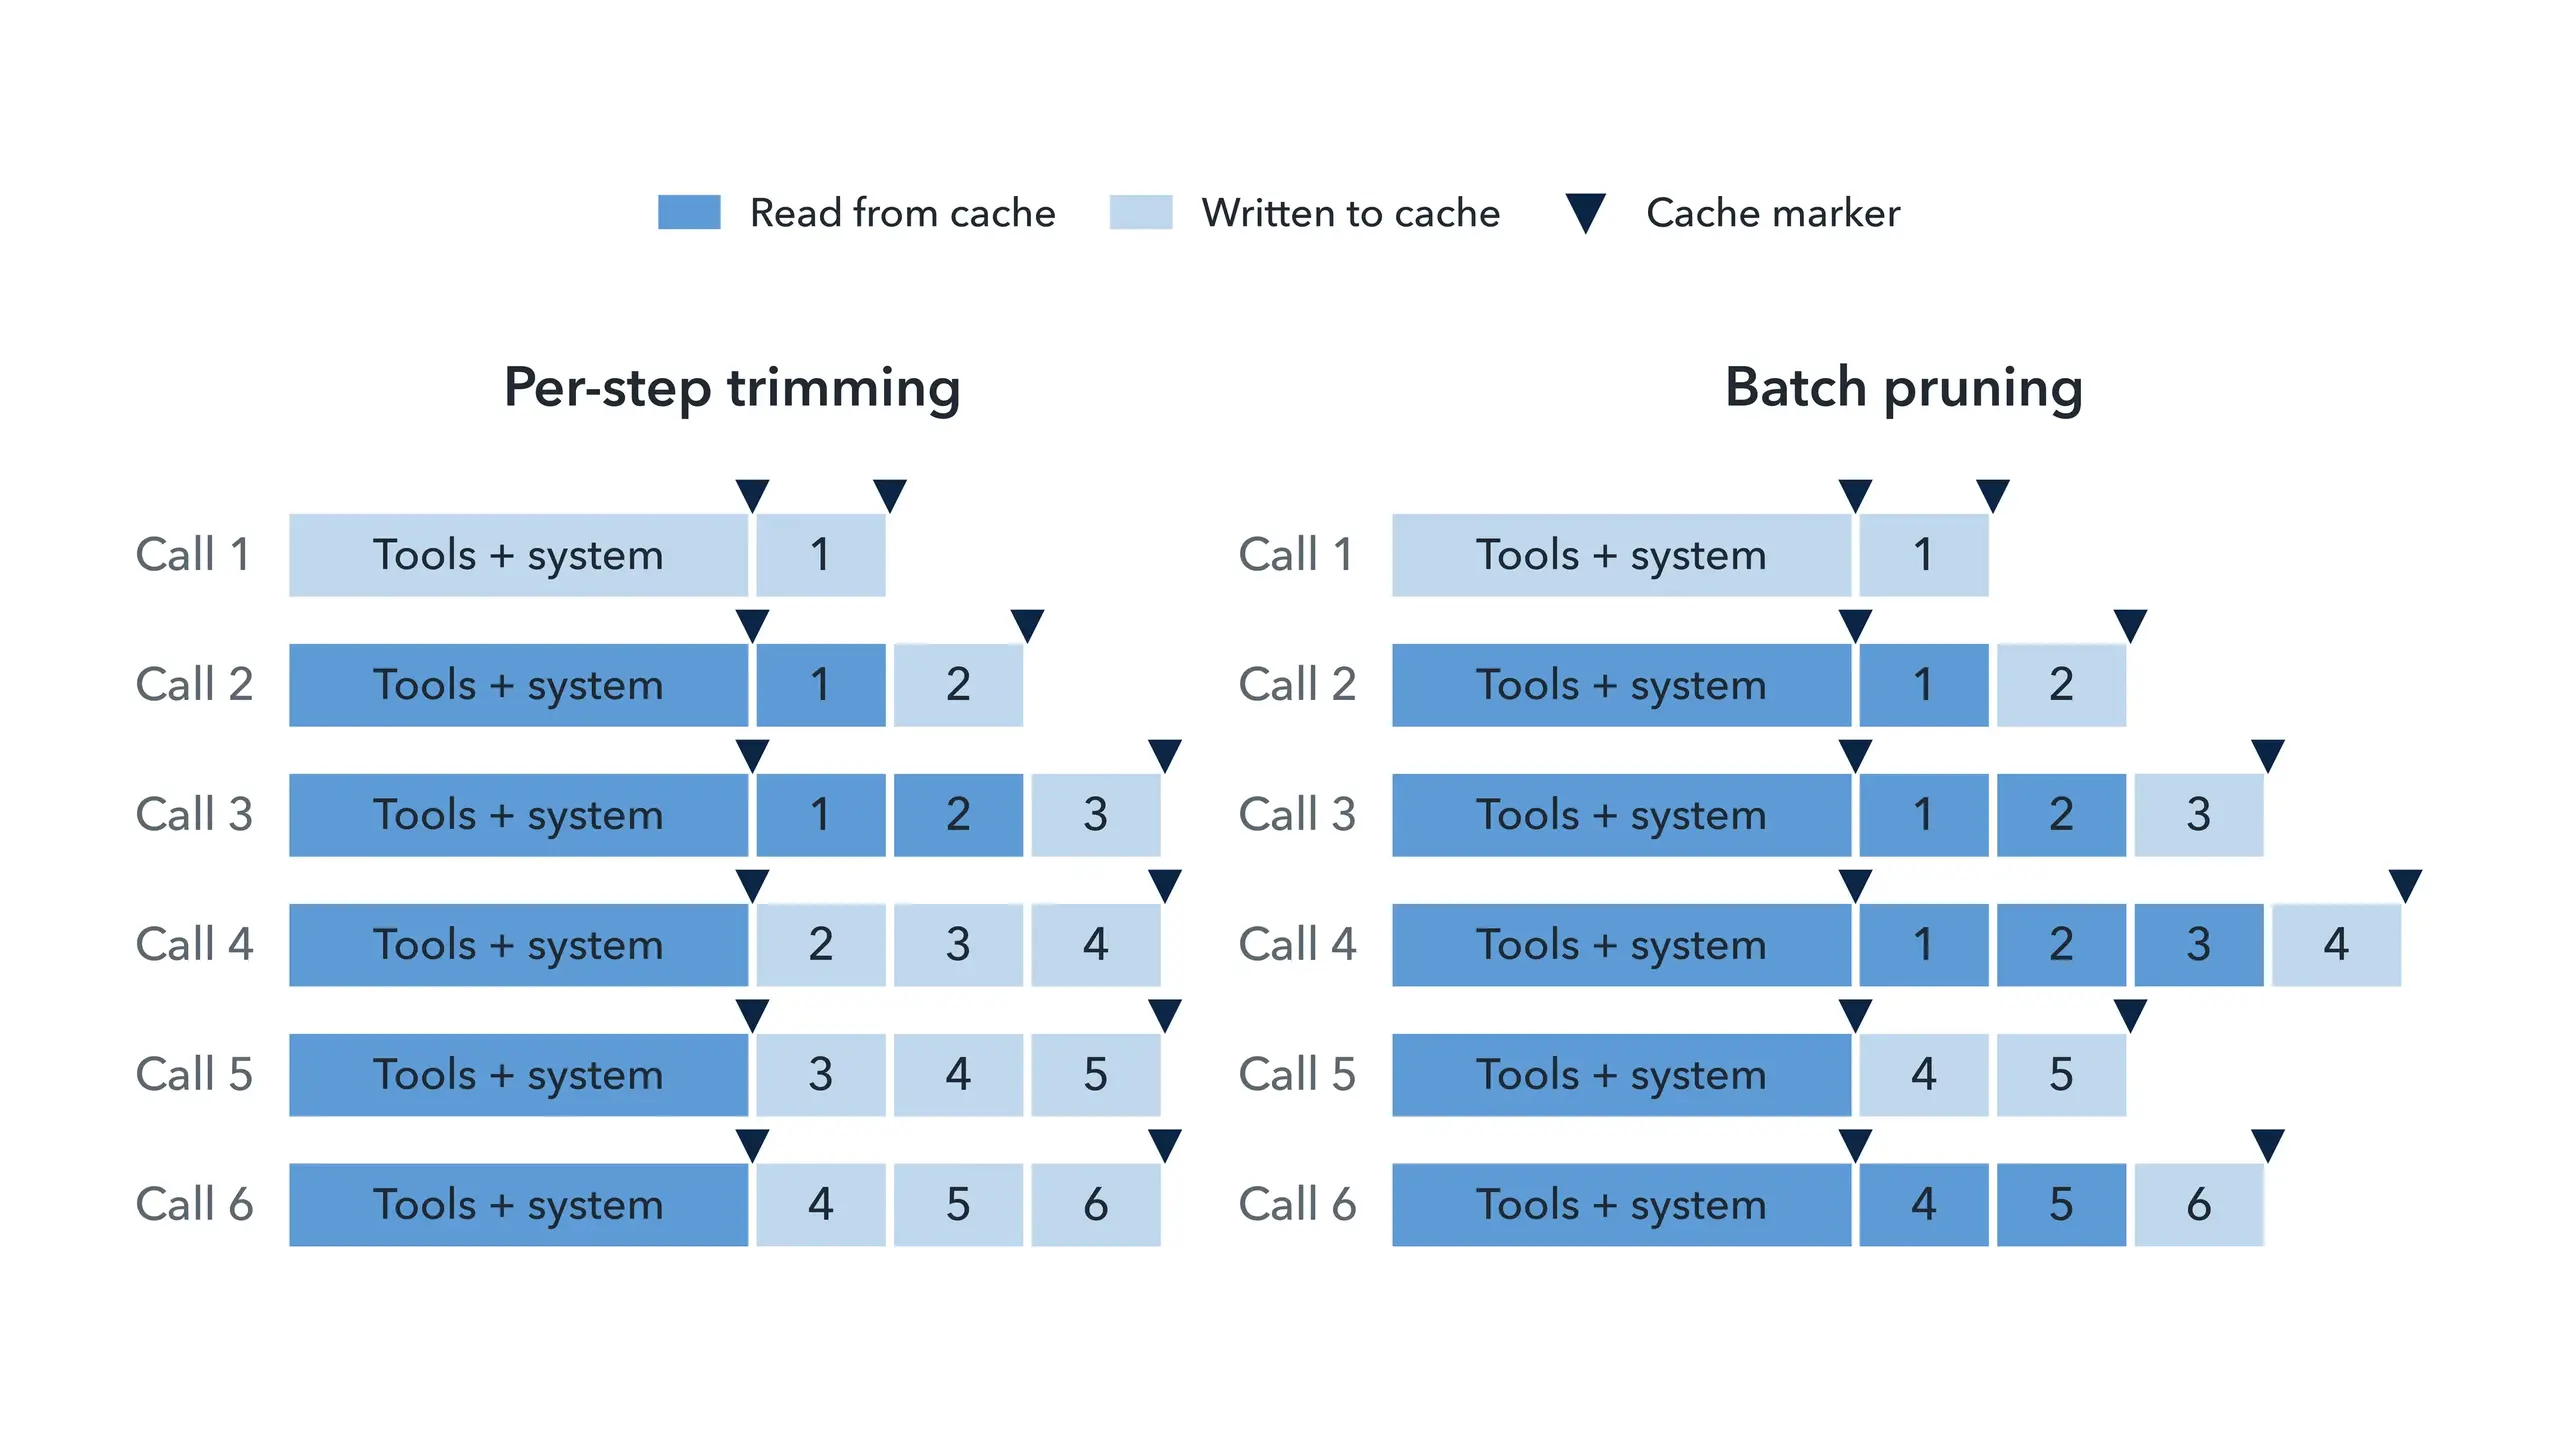
브라우저 에이전트는 모든 호출에서 도구, 시스템 프롬프트, 페이지 텍스트 및 스크린샷의 증가하는 기록을 다시 전송합니다. 프롬프트 캐싱은 반복되는 입력 비용을 낮춥니다. 당사가 테스트한 모델에서 캐시 읽기 비용은 표준 입력 가격의 0.05~0.1배입니다. 하지만 캐시는 요청에서 변경되지 않은 가장 긴 접두사만 재사용합니다. 당사의 에이전트는 도구와 시스템 프롬프트를 캐시했지만 기록은 캐시하지 않았으며, 기록만 캐시해도 도움이 되지 않았을 것입니다. 에이전트는 모든 단계에서 이전 스크린샷을 제거하고 기록 한도에 맞게 이전 텍스트를 잘랐습니다. 각 수정은 요청의 이전 부분을 변경했기 때문에 거의 모든 호출에서 재사용이 중단되었습니다.
해결 방법
먼저, 최신 도구 결과에 캐시 마커를 사용하여 기록도 캐시합니다. 둘째, 모든 호출에서 이를 편집하지 마세요. 배치 가지치기는 스크린샷을 유지하고 배치 단위로 제거합니다. 20:1의 경우, 에이전트는 최대 20개를 유지한 다음 1개로 줄이므로 약 19회의 연속 호출에서 캐시된 기록을 재사용합니다. 또한 기록 예산을 120,000자에서 480,000자로 늘려 더 이상 이전 텍스트가 잘리지 않도록 했습니다.

실행 방법
Codex에서 작동하는 GPT-6 Astra가 대부분의 작업을 수행했습니다. 코드를 감사하고, 모든 요청을 계측하고, 중요한 변수를 식별하기 위해 빠른 테스트를 실행하고, 워크플로를 동시에 실행하도록 코드를 리팩터링하고, 실행을 시작하고, 트레이스를 분석했습니다. 사람들은 목표와 기준을 설정하고 결론을 검토했습니다. Asana의 소프트웨어 제공 플랫폼인 Command가 기록 시스템이었습니다. 모든 세션의 요청, 추적 및 결과가 여기에 기록되었기 때문에 나중에 전체 연구를 분석할 수 있었고, 그 결과가 티켓, 풀 리퀘스트 및 검토된 변경 사항으로 배포되었습니다.


수작업으로 진행하면 몇 달이 걸렸을 것이기 때문에 수작업으로 진행할 생각은 전혀 하지 않았습니다. Codex를 사용하니 약 1주일이 걸렸습니다. 잠자리에 들기 전에 /goal을 설정하고 아침에 결과를 검토했습니다.
이제 에이전트가 실행되지 않는 모든 밤은 낭비된 밤처럼 느껴집니다.
GPT-6.1 Sol과 다른 세 가지 최첨단 모델인 모델 A, B, C(아래 표)에서 두 가지 예산으로 6가지 캐싱 및 기록 정책을 테스트했으며, 조건당 3회 실행하여 총 144회 실행과 12회 후속 실행을 진행했습니다. 각 제공업체의 토큰 카운터에서 비용을 계산했으며, 모든 답변은 독립적으로 준비된 참조 자료를 기준으로 점수를 매겼습니다.
모델 | 정의 | 가격 |
모델 A | 2025년 가을에 출시된 다른 프론티어 랩의 더 작고 저렴한 모델 | GPT-6.1 Sol 가격의 절반 |
모델 B | 모델 A와 동일한 연구소에서 개발되어 2026년 여름에 출시된, 원래 프로덕션에서 사용되었던 모델 | GPT-6.1 Sol과 동일 |
모델 C | 2026년 가을에 출시된 모델 B의 최신 버전 | GPT-6.1 Sol과 동일 |
GPT-6.1 Sol | OpenAI의 모델 | 참조 |
결과

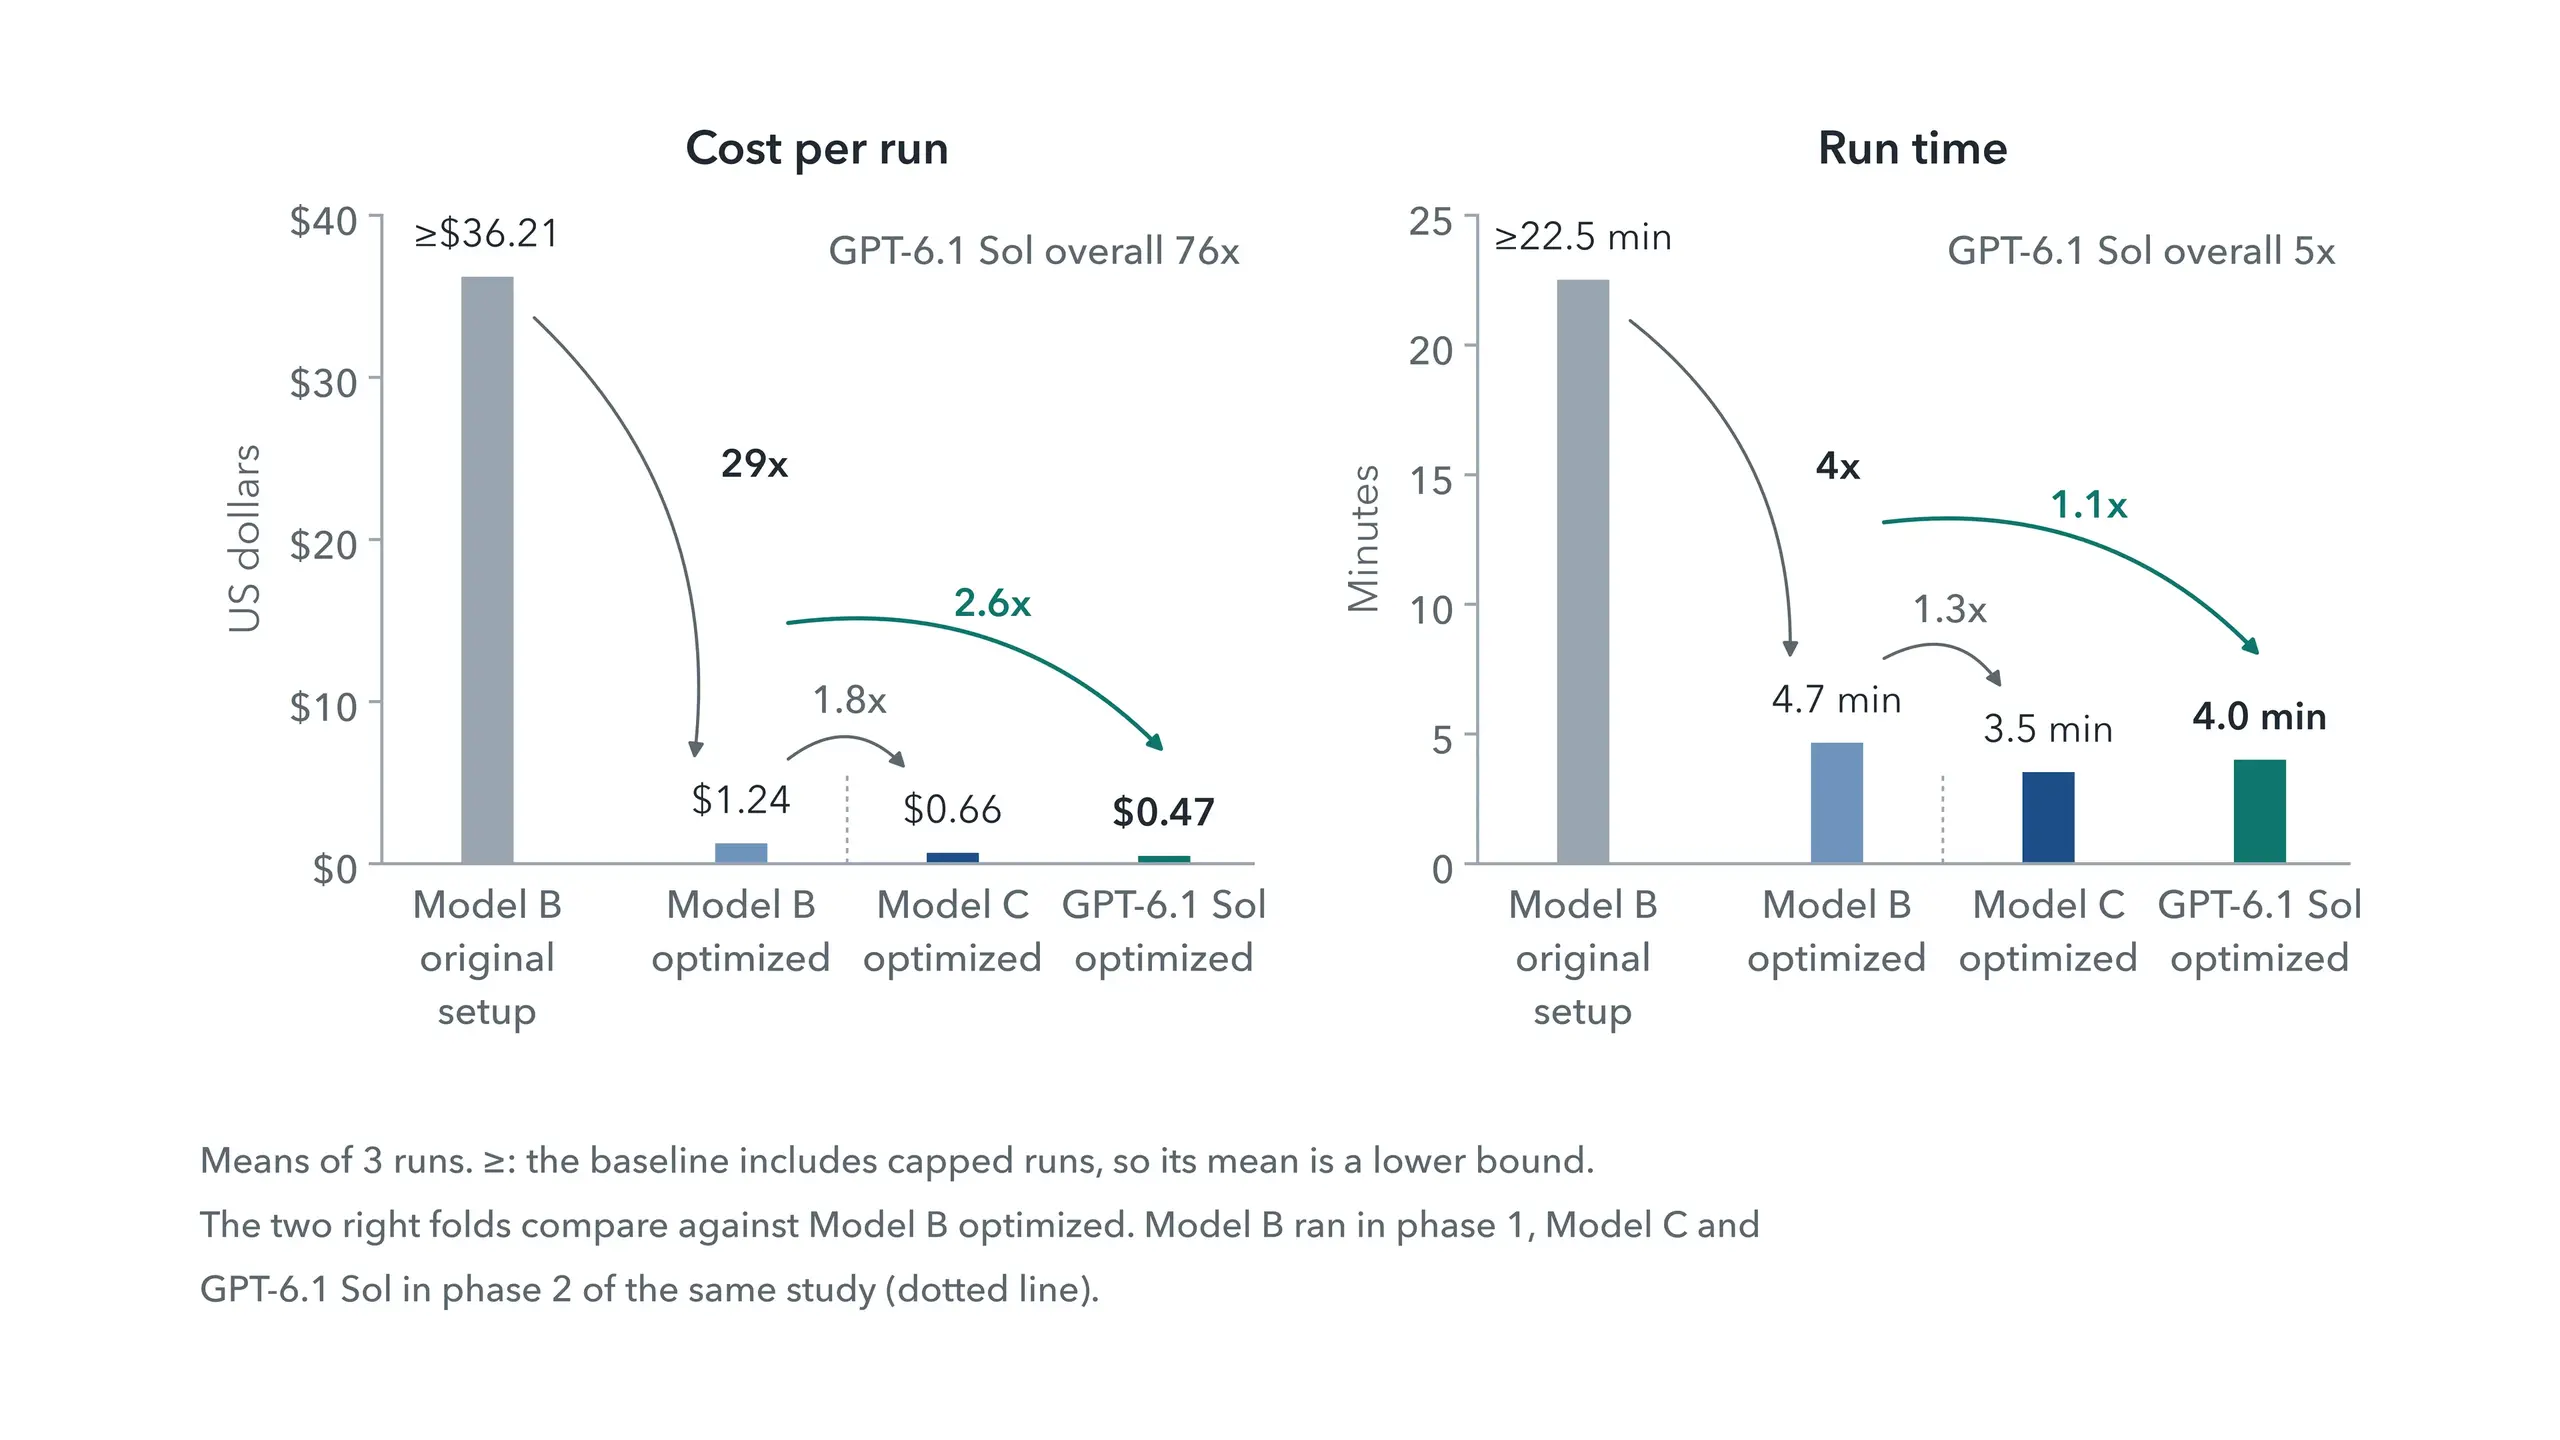
모델 B에서 최적의 조건은 실행 1회당 비용을 29배 절감하고 원래 프로덕션 설정보다 4배 더 빠르게 실행되었습니다. GPT-6.1 Sol에서는 동일한 에이전트의 비용이 76배 낮아졌고 실행 속도가 5배 빨라졌으며, 입력 내용의 89%를 캐시에서 읽었습니다. 모든 모델에서 모든 최적 조건 실행은 모든 기준 실행보다 비용이 적게 들었으며 192개의 모든 사실을 발견했습니다.
학습 내용
예산은 모델에 맞아야 합니다. 더 새로운 모델은 더 적은 예산을 더 빨리 소진했습니다. 모델 C는 10번째 호출에서 처음으로 히스토리를 줄였고, 모델 A는 64번째 호출에서 줄였습니다. 120,000자에서 모델 C는 18번의 실행 중 한 번도 답변하지 않았고, Sol은 3번의 실행에서 답변했으며, 대부분의 경우 단계 한도에 도달했습니다. 480,000자에서는 두 모델 모두 모든 실행에서 답변했습니다.
캐싱만으로는 충분하지 않습니다. 배치 가지치기를 하지 않으면, 더 큰 예산으로 기록을 캐싱하는 것이 4개 모델 중 3개에서 캐싱하지 않는 것보다 비용이 더 많이 들었습니다. 캐시가 지속적으로 다시 작성되고 거의 읽히지 않았기 때문입니다.
정말 가지치기가 필요한가요?
호출당 데이터에 따르면 이 경우에는 가지치기가 필요하지 않을 수 있으므로 후속 작업에서 모든 스크린샷을 보관했습니다. 호출당 비용은 모델 B와 Sol의 최적 조건보다 1.2배 낮았고, 모델 C에서는 약 5% 낮았습니다. 긴 작업, 작은 컨텍스트 창, 비용이 더 많이 드는 캐시 읽기에는 여전히 가지치기가 중요합니다.
조건당 3~4회의 실행과 실행마다 달라지는 호출 횟수를 고려할 때, 이 연구는 단 몇 퍼센트 차이밖에 나지 않는 조건을 구분하기보다는 광범위한 패턴을 보여줍니다.
가드레일은 여전히 중요합니다.
어떤 실행도 480,000자 예산에 도달하지 않았으므로 이러한 실행을 제한하지 않았습니다. 한도는 여전히 중요합니다. 드리프트하는 에이전트는 컨텍스트 한도에 가까워지고, 캐시가 손상되면 모든 호출에 대해 전액이 청구됩니다. 단계, 토큰 및 실행당 비용에 대한 한도는 잘못된 실행의 비용을 제한합니다. 압축은 이 연구의 범위를 벗어나는 또 다른 옵션입니다.
조사 결과에서 프로덕션까지
일부 결과는 다른 에이전트가 Command에 기록된 모든 추적을 검토했을 때 나중에 도출되었습니다. 이는 모든 데이터가 저장되었는지 확인할 수 없는 단일 세션에서는 수행하기 어렵습니다. 에이전트가 MCP를 통해 액세스하는 모든 것을 Command에 보관하면 누락된 데이터를 복구하기 위해 실험을 반복할 필요가 없으므로 작업 속도가 빨라집니다. 발견 사항은 인간과 코딩 에이전트를 위한 티켓이 되었고, 풀 리퀘스트는 이곳에서 검토되었으며, 변경 사항은 StackAI로 전달되었습니다. 연구 이후, 당사는 Codex로도 동일한 작업을 수행했으며, Codex는 자신의 접근 방식을 StackAI 에이전트의 접근 방식과 비교하고 두 번째 개선 사항을 제안했습니다. 이제 이 개선 사항은 Command의 티켓으로 관리됩니다.
얻은 교훈
시스템 프롬프트뿐만 아니라 증가하는 기록을 캐시하세요.
기록을 추가 전용으로 유지하세요. 가지치기가 필요한 경우 대량으로 가지치기를 수행하세요.
모델에 맞게 기록 예산을 설정하세요.
제공업체의 자체 카운터를 사용하여 호출당 캐시 읽기를 측정합니다.
모든 세션에 대한 전체 기록을 보관하여 분석 및 후속 작업에 동일한 기록을 사용합니다.
Asana는 이러한 실험을 일상적으로 수행할 수 있는 툴을 개발하고 있습니다. 전체 연구는 방법, 결과 및 제한 사항을 다룹니다.
더 이상 배송 속도가 병목 현상이 아닙니다. 이제는 인간의 주의가 병목 현상입니다. 저는 우리가 모든 엔지니어가 에이전트 군단을 이끄는 PM이 되는 세상에 가까워지고 있다고 생각합니다.