Cara kami memangkas biaya agen browser sebesar 76x dan membuatnya 5x lebih cepat dengan menjaga cache tetap utuh


Sebuah studi dengan GPT-6 Astra di Codex di empat model, mulai dari menyelidiki kode hingga mengukur hasilnya


Alasan kami menelitinya
Asana menghadirkan automasi alur kerja agen ke platformnya melalui StackAI, dan pada skala Asana, inefisiensi kecil akan terakumulasi. Tujuan kami adalah membuat satu agen browser lebih murah dan lebih cepat tanpa mengurangi kualitas jawaban.
“Seperti inilah wujud tim manusia dan agen dalam praktiknya. Seorang teknisi menetapkan arah, seorang agen menjalankan eksperimen, dan hasilnya melewati Command menuju produksi. Ini menunjukkan bagaimana Asana mewujudkan tim manusia+agen.” - Arnab Bose, CPO di Asana
Apa yang berjalan buruk
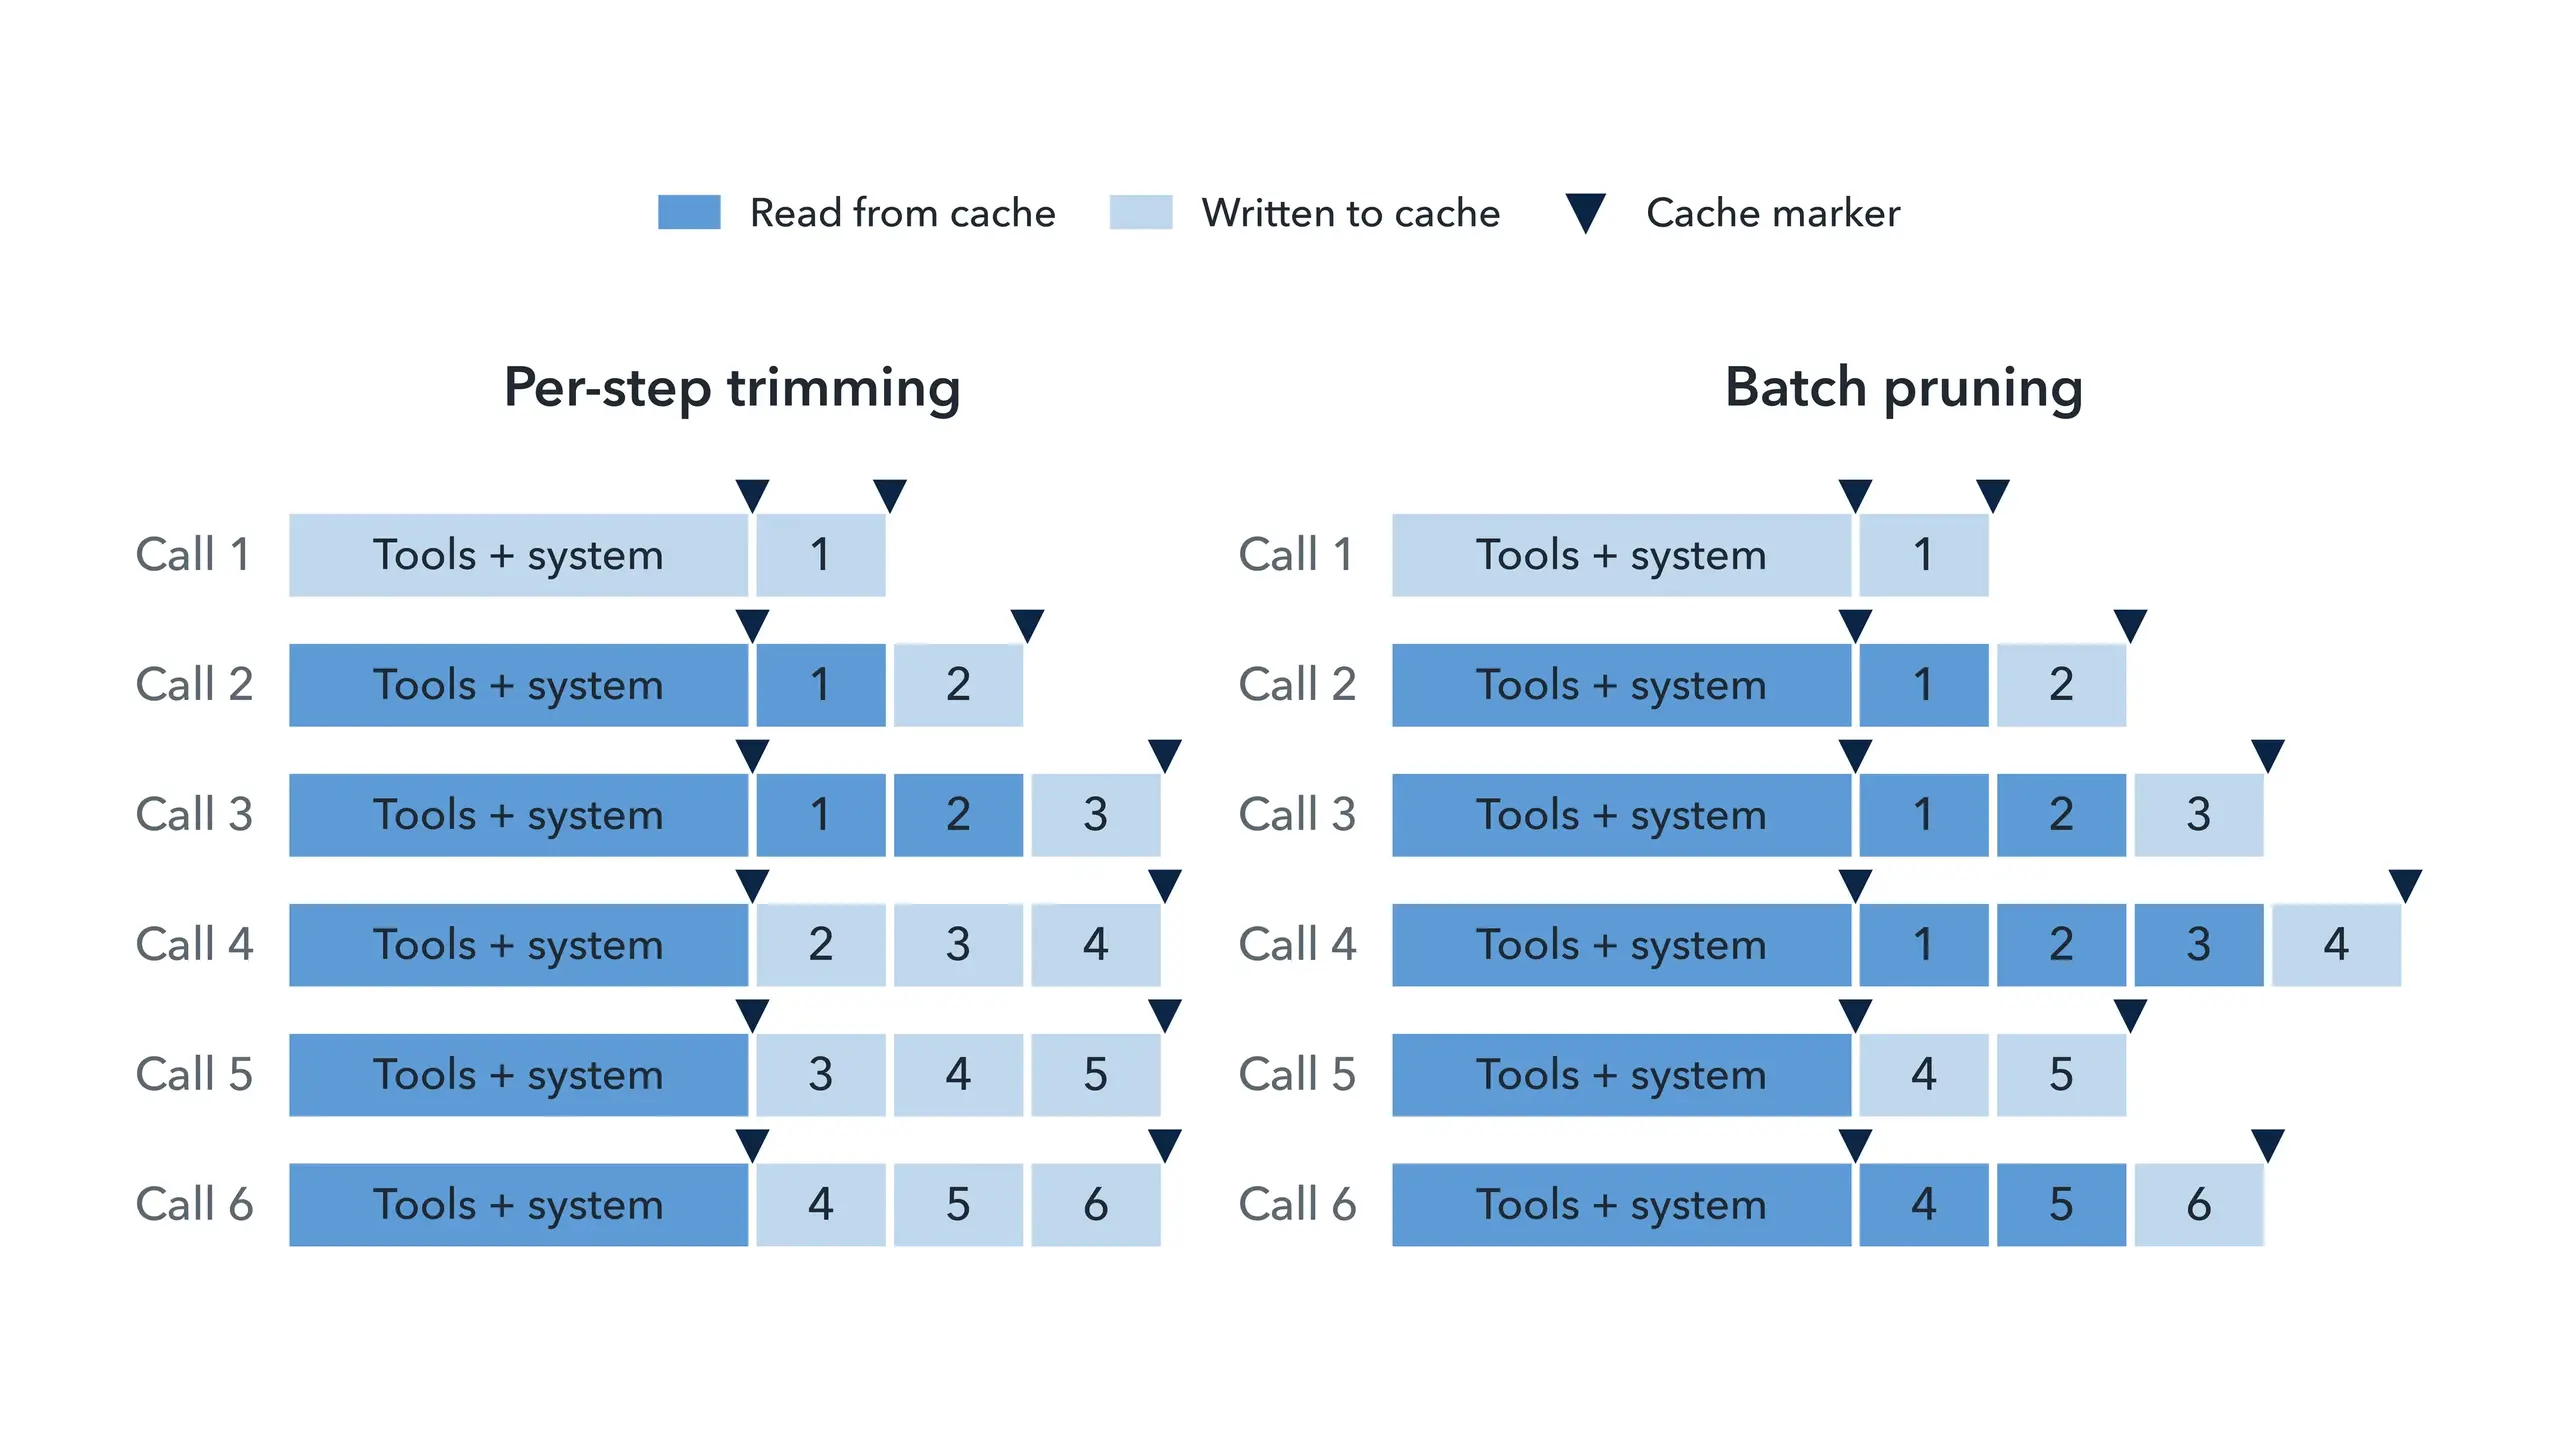
Agen browser mengirim ulang alatnya, prompt sistem, dan riwayat teks halaman serta tangkapan layar yang terus bertambah pada setiap panggilan. Caching prompt menurunkan biaya input berulang: pada model yang kami uji, pembacaan cache dikenakan biaya 0,05x hingga 0,1x dari harga input standar. Namun, cache hanya menggunakan kembali awalan terpanjang yang tidak berubah dari suatu permintaan. Agen kami menyimpan alat dan prompt sistemnya dalam cache, tetapi tidak menyimpan riwayatnya, dan menyimpan riwayat saja dalam cache tidak akan membantu: agen menghapus tangkapan layar sebelumnya di setiap langkah dan memangkas teks yang lebih lama agar sesuai dengan anggaran riwayat. Setiap pengeditan mengubah bagian sebelumnya dari permintaan, sehingga penggunaan ulang gagal hampir di setiap panggilan.
Perbaikannya
Pertama, simpan juga riwayat dalam cache, dengan penanda cache pada hasil alat terbaru. Kedua, hentikan pengeditan pada setiap panggilan. Pemangkasan batch menyimpan tangkapan layar dan menghapusnya secara batch: pada 20:1, agen menyimpan hingga 20 tangkapan layar dan kemudian mengurangi menjadi 1, sehingga sekitar 19 panggilan berturut-turut menggunakan kembali riwayat yang di-cache. Kami juga meningkatkan anggaran riwayat dari 120.000 menjadi 480.000 karakter, jadi teks lama tidak lagi dipangkas.

Cara kami menjalankannya
GPT-6 Astra, yang bekerja di Codex, melakukan sebagian besar pekerjaan: mengaudit kode, menginstrumentasi setiap permintaan, menjalankan pengujian cepat untuk mengidentifikasi variabel yang penting, melakukan refaktor kode untuk menjalankan alur kerja secara paralel, meluncurkan eksekusi, dan menganalisis jejak. Manusia menetapkan gol dan standar serta meninjau kesimpulan. Command, platform pengiriman perangkat lunak Asana, adalah sistem pencatatan: permintaan, jejak, dan hasil setiap sesi dicatat di sana, sehingga kami dapat menganalisis seluruh studi setelahnya, dan temuan-temuan tersebut menjadi tiket, permintaan penarikan, dan perubahan yang ditinjau dan dirilis.


Saya tidak pernah terpikir untuk melakukannya secara manual karena kemungkinan besar akan memakan waktu berbulan-bulan. Dengan Codex, proses ini memakan waktu sekitar seminggu: Saya menetapkan /goal sebelum tidur dan meninjau hasilnya di pagi hari.
Sekarang, setiap malam ketika agen kami tidak beroperasi terasa seperti malam yang sia-sia.
Kami menguji enam kebijakan caching dan riwayat pada dua anggaran di GPT-6.1 Sol dan tiga model frontier lainnya, Model A, B, dan C (tabel di bawah), dengan tiga kali eksekusi per kondisi: 144 kali eksekusi, ditambah 12 kali eksekusi tindak lanjut. Kami menghitung biaya dari penghitung token setiap penyedia, dan setiap jawaban dinilai berdasarkan referensi yang disiapkan secara independen.
Model | Definisi | Harga |
Model A | Model yang lebih kecil dan lebih murah dari lab terdepan lainnya, dirilis pada Musim Gugur 2025 | Setengah dari harga GPT-6.1 Sol |
Model B | Model yang awalnya digunakan dalam produksi, dari lab yang sama dengan Model A, dirilis pada Musim Panas 2026 | Sama dengan GPT-6.1 Sol |
Model C | Versi terbaru dari Model B, dirilis pada Musim Gugur 2026 | Sama dengan GPT-6.1 Sol |
GPT-6.1 Sol | Model OpenAI | Referensi |
Hasil

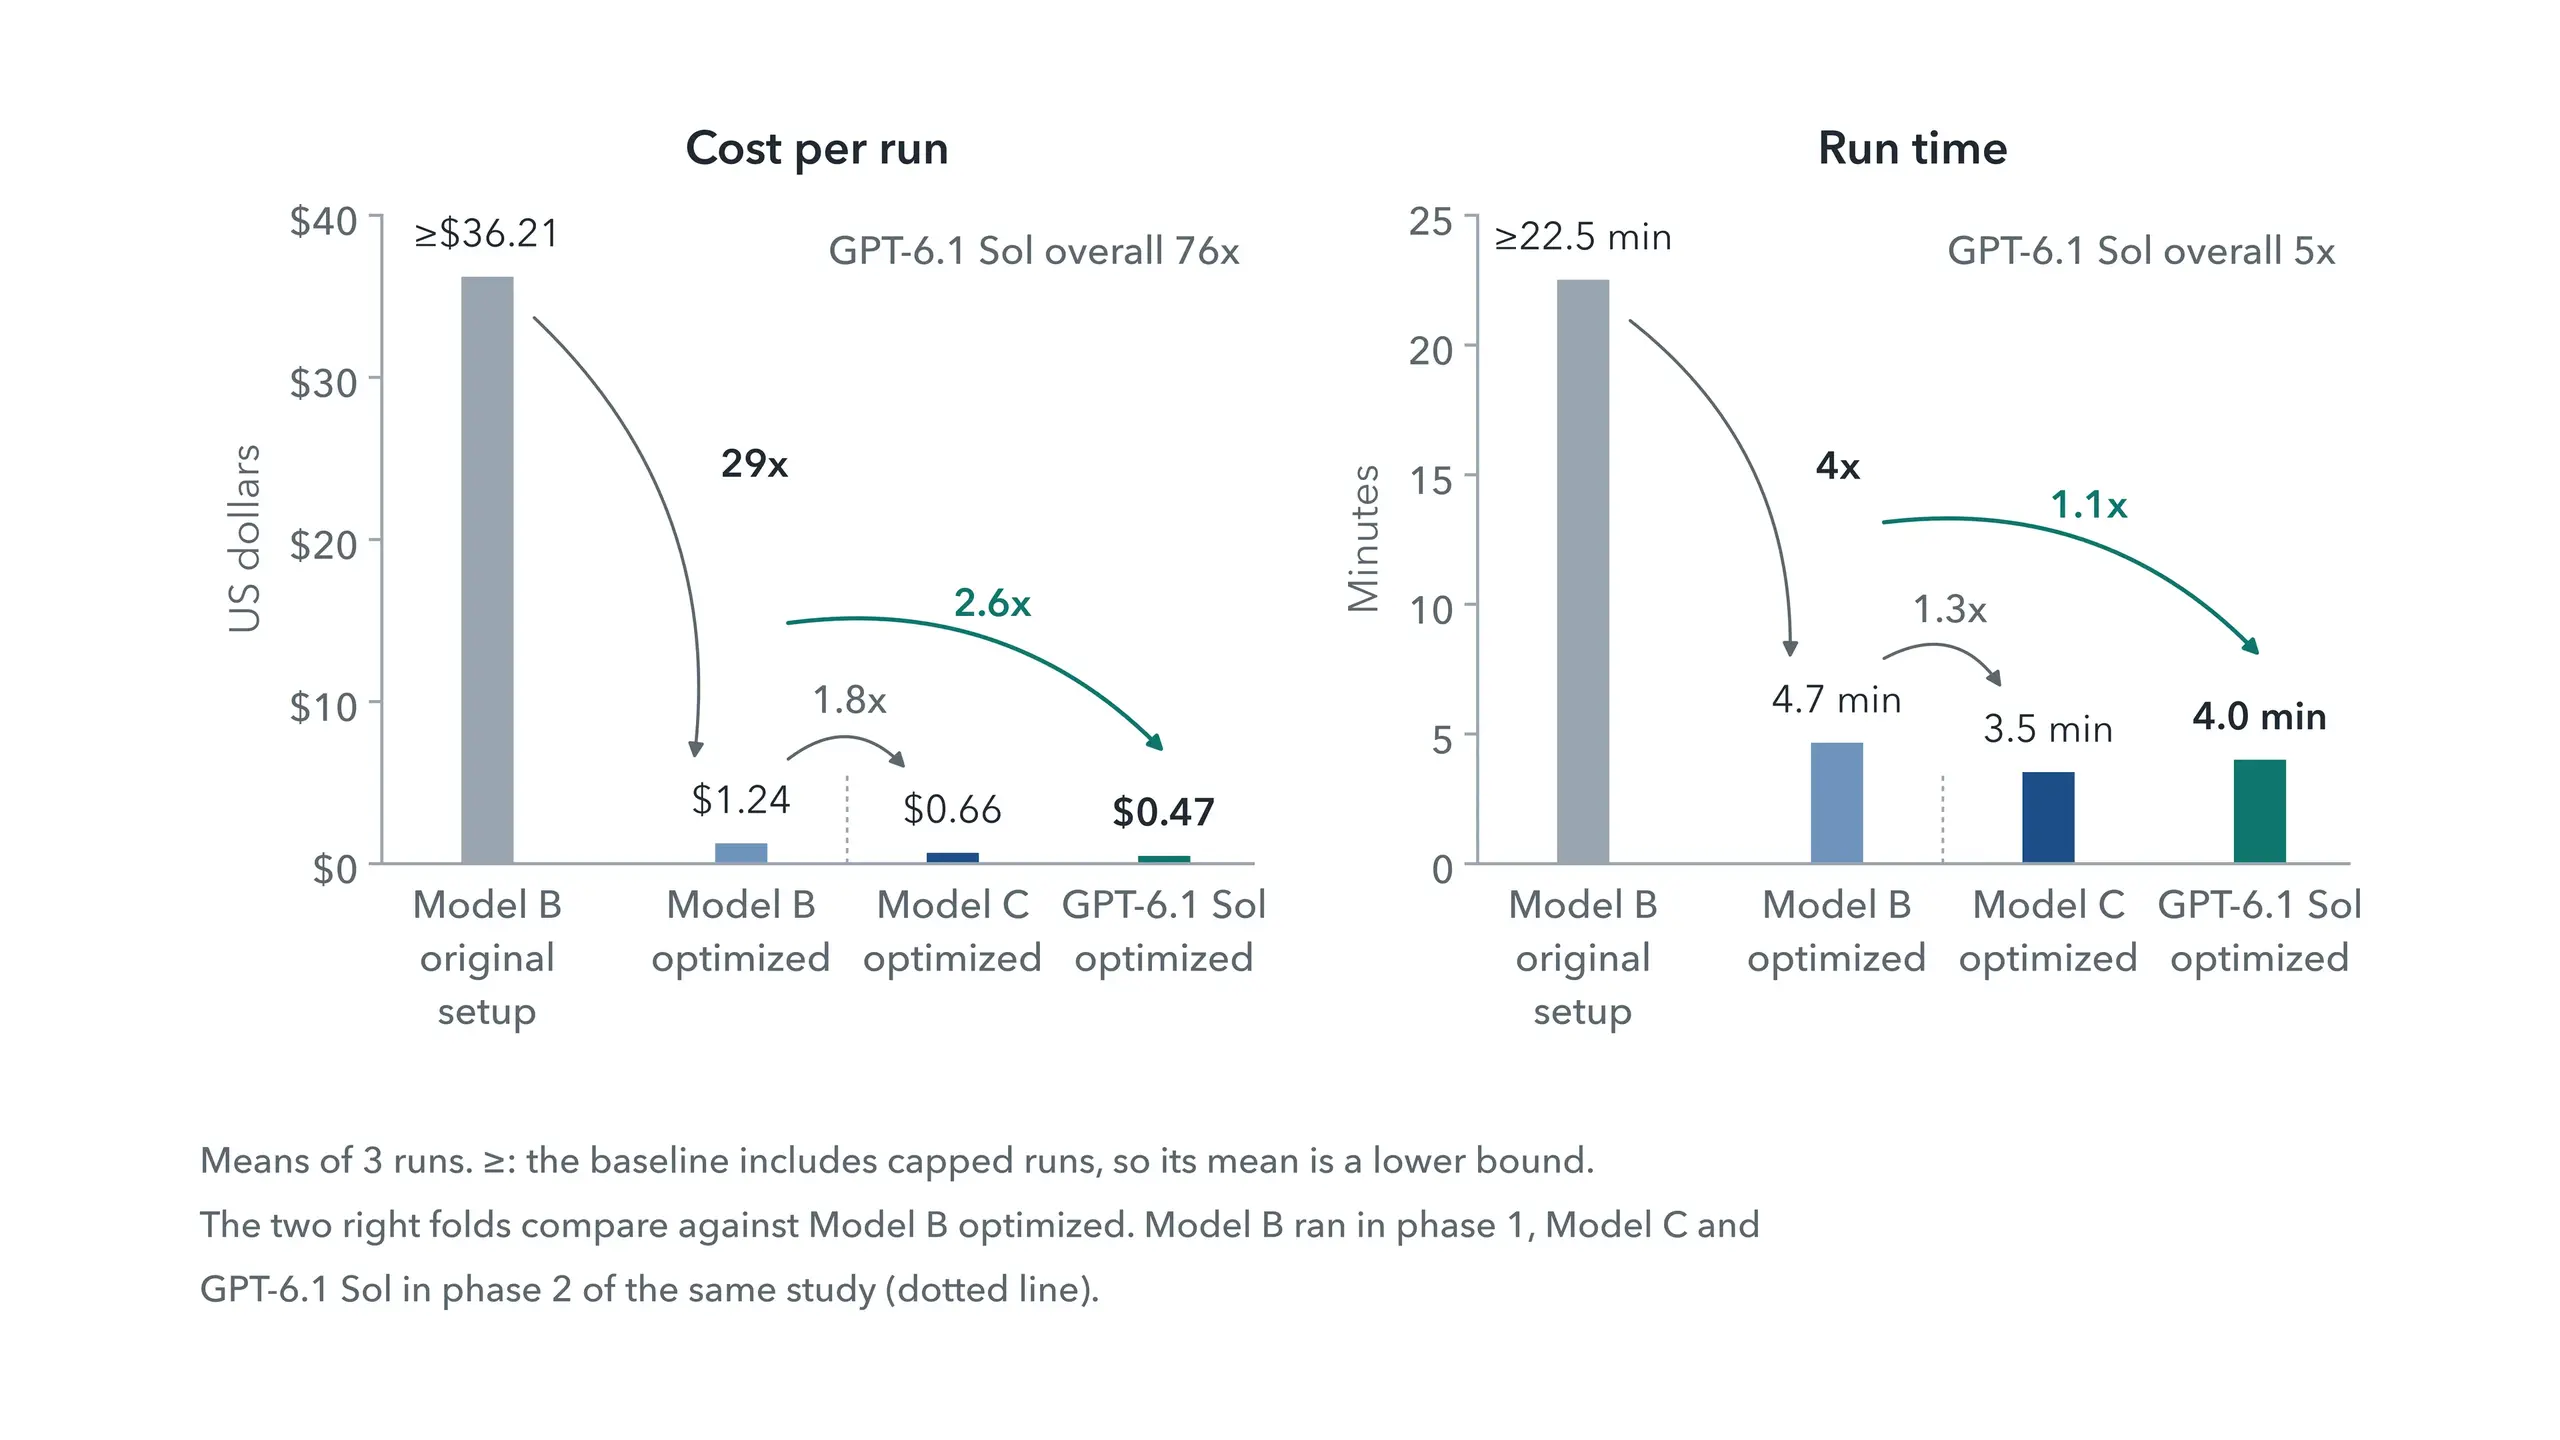
Pada Model B, kondisi terbaik memangkas biaya per proses sebanyak 29x dan berjalan 4x lebih cepat daripada pengaturan produksi awal. Pada GPT-6.1 Sol, agen yang sama biayanya 76x lebih murah dan berjalan 5x lebih cepat, membaca 89% inputnya dari cache. Pada setiap model, setiap pelaksanaan dalam kondisi terbaik berbiaya lebih rendah daripada setiap pelaksanaan dasar dan menemukan ke-192 fakta.
Pembelajaran
Anggaran harus sesuai dengan model. Model yang lebih baru menghabiskan anggaran yang lebih kecil lebih cepat: Model C pertama kali memangkas riwayatnya pada panggilan ke-10, Model A pada panggilan ke-64. Pada 120.000 karakter, Model C tidak menjawab pada satu pun dari 18 kali eksekusi dan Sol menjawab pada 3 kali eksekusi, sebagian besar mencapai batas langkah; pada 480.000 karakter, setiap eksekusi pada kedua model menjawab.
Caching saja tidak cukup. Tanpa pemangkasan batch, menyimpan riwayat dalam cache dengan anggaran yang lebih besar biayanya lebih mahal daripada tidak menyimpannya dalam cache pada tiga dari empat model: cache terus-menerus ditulis ulang dan jarang dibaca.
Apakah Anda benar-benar perlu melakukan pemangkasan?
Data per panggilan menunjukkan bahwa pemangkasan mungkin tidak diperlukan di sini, jadi tindak lanjut menyimpan setiap tangkapan layar. Biaya per panggilan 1,2x lebih rendah daripada kondisi terbaik pada Model B dan Sol, dan sekitar 5% lebih rendah pada Model C. Pemangkasan tetap penting untuk tugas yang panjang, jendela konteks yang kecil, dan pembacaan cache yang lebih mahal.
Dengan tiga atau empat kali eksekusi per kondisi dan jumlah panggilan yang bervariasi antar-eksekusi, studi ini menunjukkan pola yang luas, bukan membedakan kondisi yang hanya berjarak beberapa persen.
Pembatas tetap penting
Tidak ada proses yang mencapai anggaran 480.000 karakter, jadi ini tidak membatasi proses-proses ini. Batasan masih penting: agen yang menyimpang bertambah mendekati batas konteks, dan jika cache rusak, setiap panggilan dikenakan biaya penuh. Batas pada langkah, token, dan biaya per proses membatasi biaya proses yang buruk. Pemadatan adalah opsi lain, yang berada di luar ruang lingkup studi ini.
Dari temuan hingga produksi
Beberapa temuan muncul kemudian, ketika agen lain meninjau setiap jejak yang dicatat ke Command. Ini sulit dilakukan dari satu sesi, di mana Anda tidak dapat memastikan bahwa semua data telah disimpan. Menyimpan semuanya di Command, yang diakses oleh agen kami melalui MCP, berarti kami tidak pernah harus mengulangi eksperimen untuk memulihkan data yang hilang, yang mempercepat pekerjaan. Temuan menjadi tiket untuk manusia dan agen pengodean, pull request ditinjau di sana, dan perubahan dikirim ke StackAI. Sejak studi ini, kami juga telah menjalankan tugas yang sama dengan Codex, yang membandingkan pendekatannya dengan pendekatan agen StackAI dan menyarankan putaran kedua perbaikan, yang sekarang menjadi tiket di Command.
Pelajaran yang kami petik
Simpan riwayat yang terus bertambah dalam cache, bukan hanya prompt sistem.
Pastikan riwayat hanya dapat ditambahkan; jika pemangkasan diperlukan, lakukan pemangkasan dalam batch besar.
Atur anggaran riwayat agar sesuai dengan model.
Ukur pembacaan cache per panggilan menggunakan penghitung milik penyedia.
Simpan bukti proses lengkap dari setiap sesi, sehingga analisis dan pekerjaan tindak lanjut menggunakan bukti proses yang sama.
Asana sedang membangun alat untuk menjadikan eksperimen seperti ini sebagai rutinitas. Studi lengkap mencakup metode, hasil, dan batasan.
Kecepatan pengiriman bukan lagi penyebab kemacetan; perhatian manusia lah penyebabnya. Saya rasa kita hampir mencapai dunia di mana setiap teknisi adalah PM yang memimpin sekelompok agen.