Hoe we de kosten van een browseragent met een factor 76 hebben verlaagd en deze 5x sneller hebben gemaakt door de cache intact te houden


Een studie met GPT-6 Astra in Codex over vier modellen, van het onderzoeken van de code tot het meten van de resultaten


Waarom we hebben gekeken
Asana brengt workflowautomatisering voor agenten naar haar platform via StackAI, en op de schaal van Asana tellen kleine inefficiënties op. Ons doel was om één browseragent goedkoper en sneller te maken zonder de kwaliteit van de antwoorden te verminderen.
“Dit is hoe teams van mensen en agents er in de praktijk uitzien. Een engineer bepaalde de richting, een agent voerde de experimenten uit en de resultaten gingen via Command naar de productie. Dit toont aan hoe Asana teams van mensen en agenten tot leven brengt.” - Arnab Bose, CPO bij Asana
Wat ging er mis?
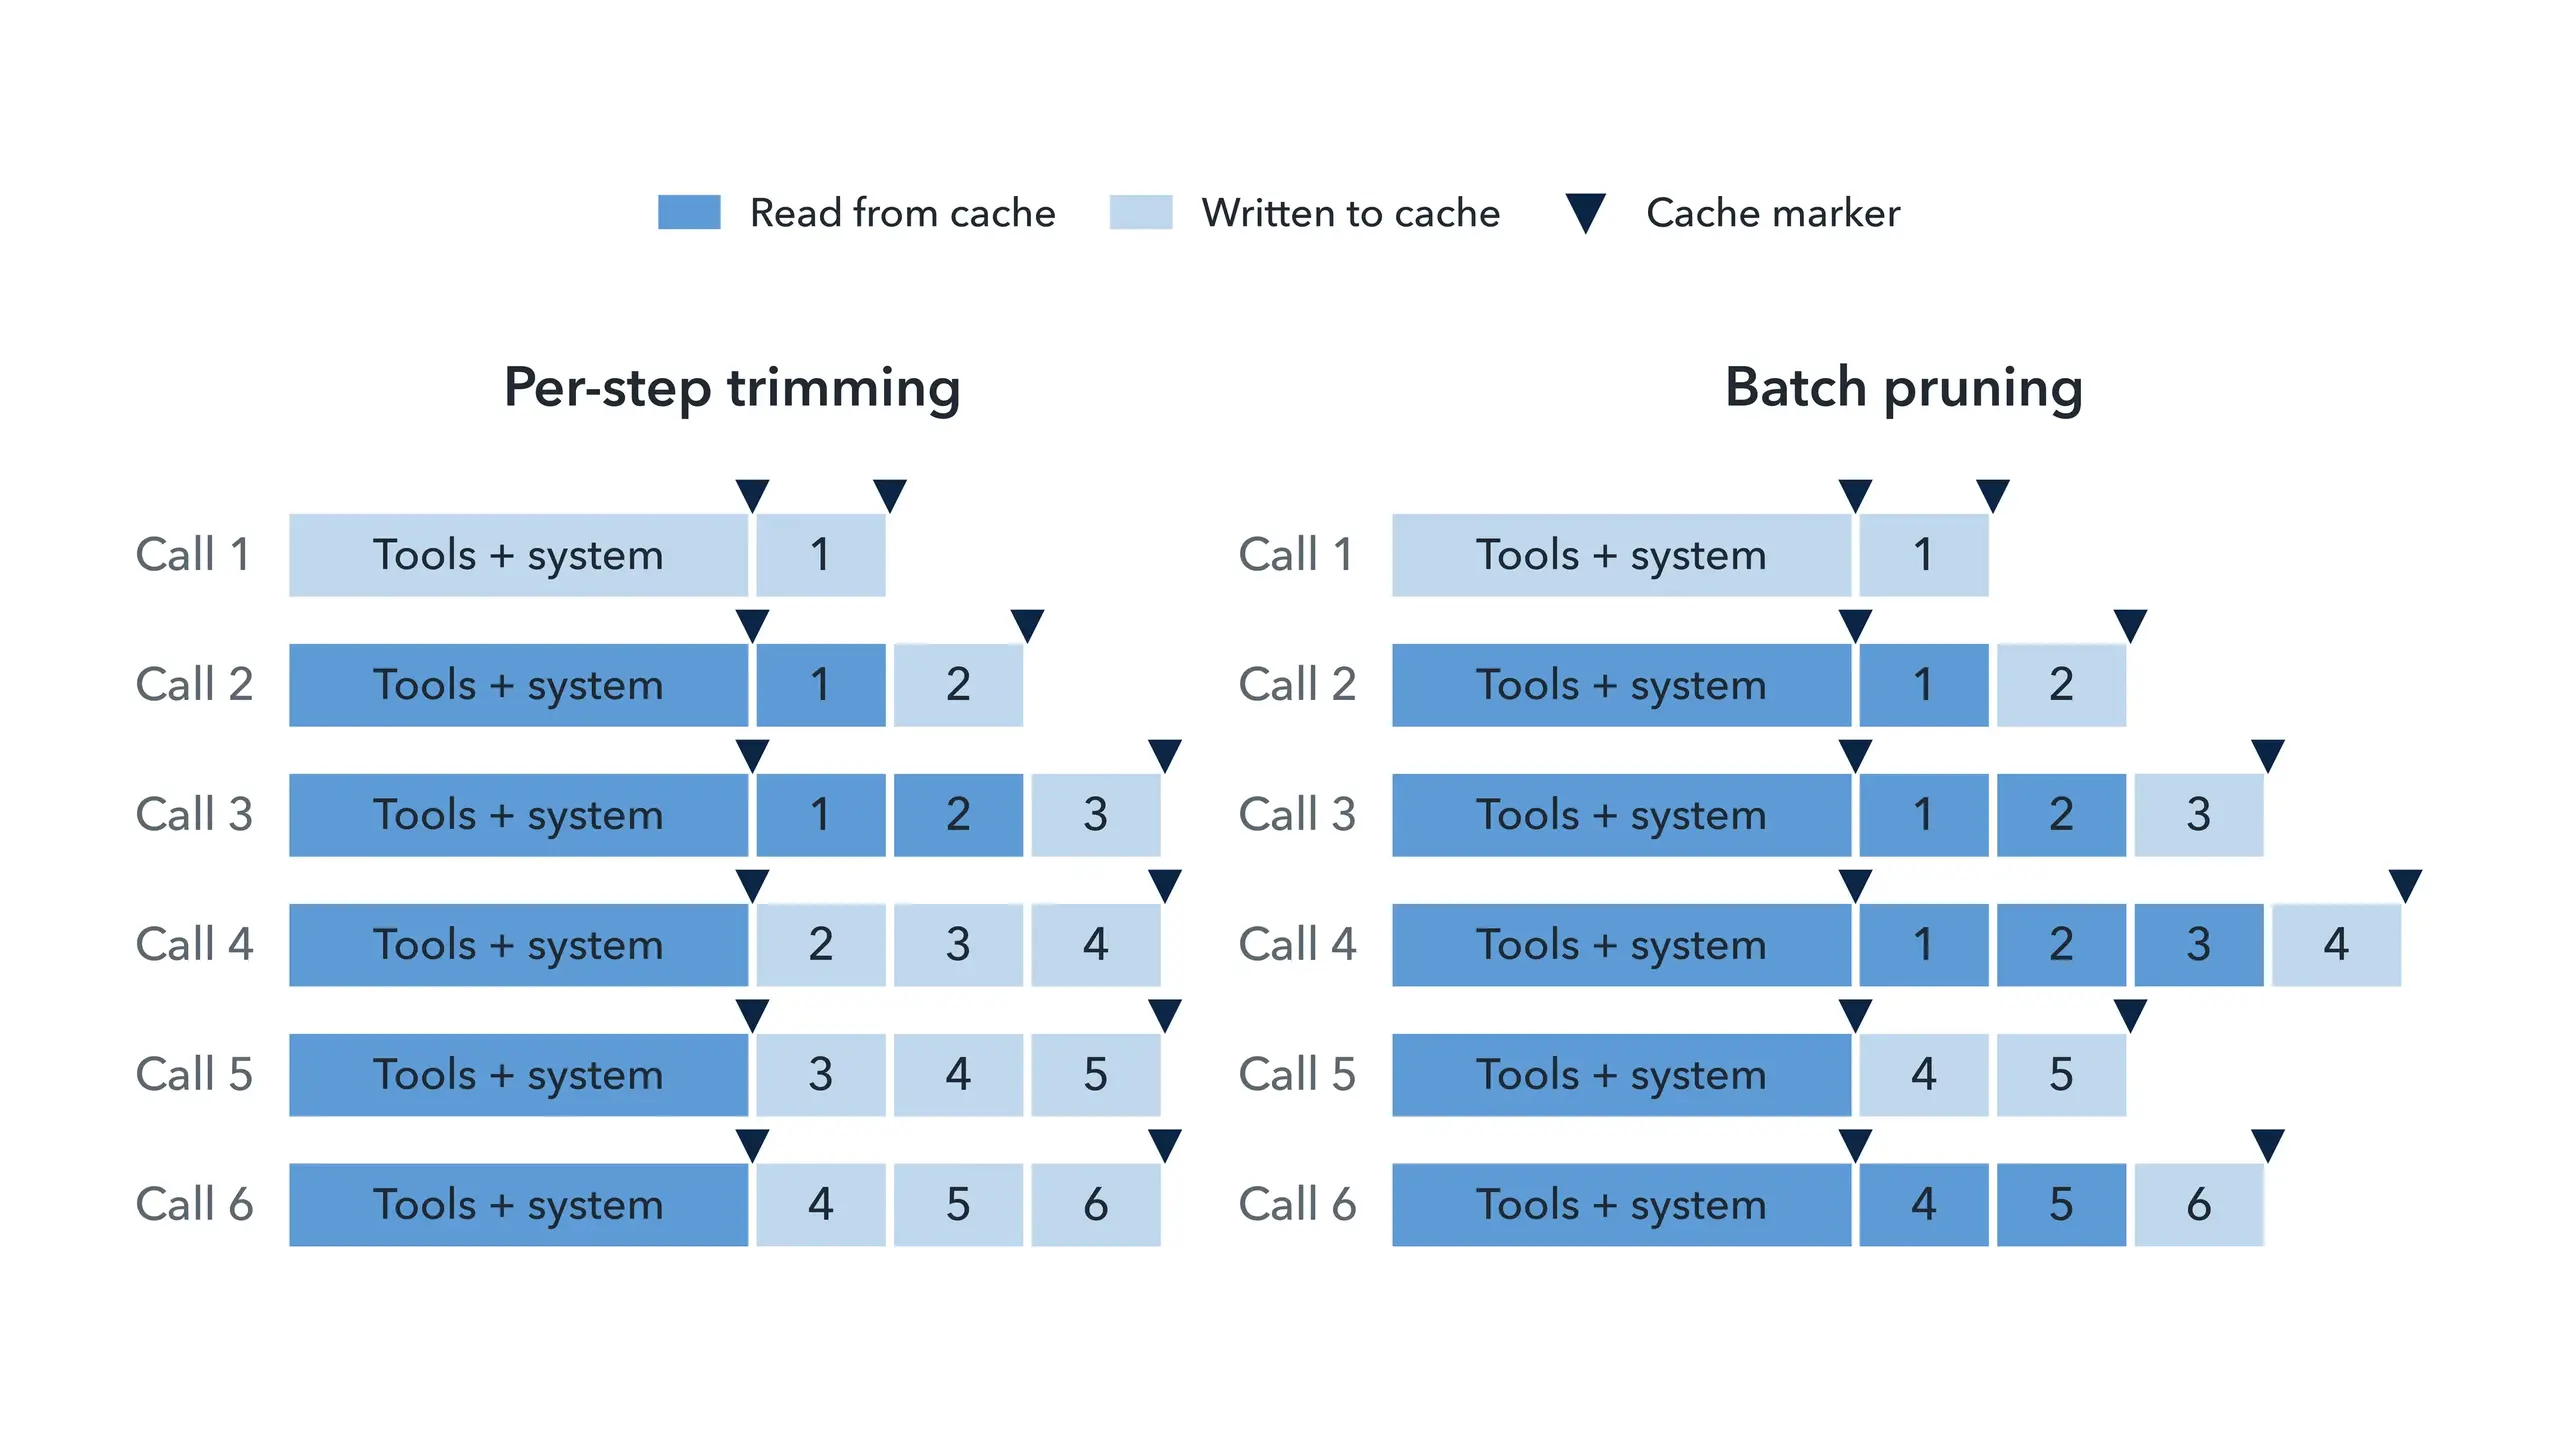
Een browseragent verzendt bij elke oproep zijn tools, systeemprompt en groeiende geschiedenis van paginatekst en screenshots opnieuw. Promptcaching verlaagt de kosten van herhaalde invoer: op de modellen die we hebben getest, kosten cache-lezingen 0,05x tot 0,1x de standaardinvoerprijs. Maar een cache gebruikt alleen het langste ongewijzigde voorvoegsel van een aanvraag opnieuw. Onze agent heeft zijn tools en systeemprompt in de cache opgeslagen, maar niet zijn geschiedenis, en alleen het cachen van de geschiedenis zou niet hebben geholpen: de agent verwijderde bij elke stap de vorige screenshot en snoeide oudere tekst om binnen een geschiedenisbudget te passen. Elke bewerking veranderde een eerder deel van de aanvraag, dus hergebruik ging bij bijna elke aanroep mis.
De oplossing
Cache eerst ook de geschiedenis, met een cachemarkering op het meest recente toolresultaat. Ten tweede, stop met het bewerken ervan bij elk gesprek. Batchgewijs snoeien bewaart screenshots en verwijdert ze in batches: bij 20:1 bewaart de agent er maximaal 20 en snoeit hij vervolgens terug tot 1, zodat ongeveer 19 opeenvolgende oproepen de gecachte geschiedenis hergebruiken. We hebben ook het geschiedenisbudget verhoogd van 120.000 naar 480.000 tekens, zodat oude tekst niet langer werd ingekort.

Hoe we het hebben uitgevoerd
GPT-6 Astra, werkend in Codex, deed het meeste werk: het controleerde de code, instrumenteerde elk verzoek, voerde snelle tests uit om de belangrijke variabelen te identificeren, refactoreerde de code om workflows parallel uit te voeren, startte de runs en analyseerde de traces. Mensen stelden het doel en de normen vast en beoordeelden de conclusies. Command, het softwareleveringsplatform van Asana, was het registratiesysteem: de verzoeken, traces en resultaten van elke sessie werden daar geregistreerd, zodat we het volledige onderzoek achteraf konden analyseren, en de bevindingen werden tickets, pull requests en beoordeelde wijzigingen die werden uitgebracht.


Ik heb er nooit aan gedacht om het handmatig te doen, omdat het me waarschijnlijk maanden zou hebben gekost. Met Codex duurde het ongeveer een week: ik stelde een /doel in voordat ik naar bed ging en bekeek de resultaten 's ochtends.
Nu voelt elke nacht dat onze agenten niet actief zijn als een verspilde nacht.
We hebben zes caching- en geschiedenisbeleidsregels getest met twee budgetten op GPT-6.1 Sol en drie andere geavanceerde modellen, Modellen A, B en C (tabel hieronder), met drie runs per voorwaarde: 144 runs, plus een follow-up van 12 runs. We hebben de kosten berekend op basis van de tokentellers van elke provider, en elk antwoord is beoordeeld aan de hand van een onafhankelijk opgestelde referentie.
Model | Wat het is | Prijs |
Model A | Een kleiner, goedkoper model van een ander frontierlab, uitgebracht in het najaar van 2025 | De helft van de prijs van GPT-6.1 Sol |
Model B | Het model dat oorspronkelijk in productie werd gebruikt, van hetzelfde lab als Model A, uitgebracht in de zomer van 2026 | Hetzelfde als GPT-6.1 Sol |
Model C | Een nieuwere versie van Model B, uitgebracht in het najaar van 2026 | Hetzelfde als GPT-6.1 Sol |
GPT-6.1 Sol | Het model van OpenAI | Referentie |
Resultaten

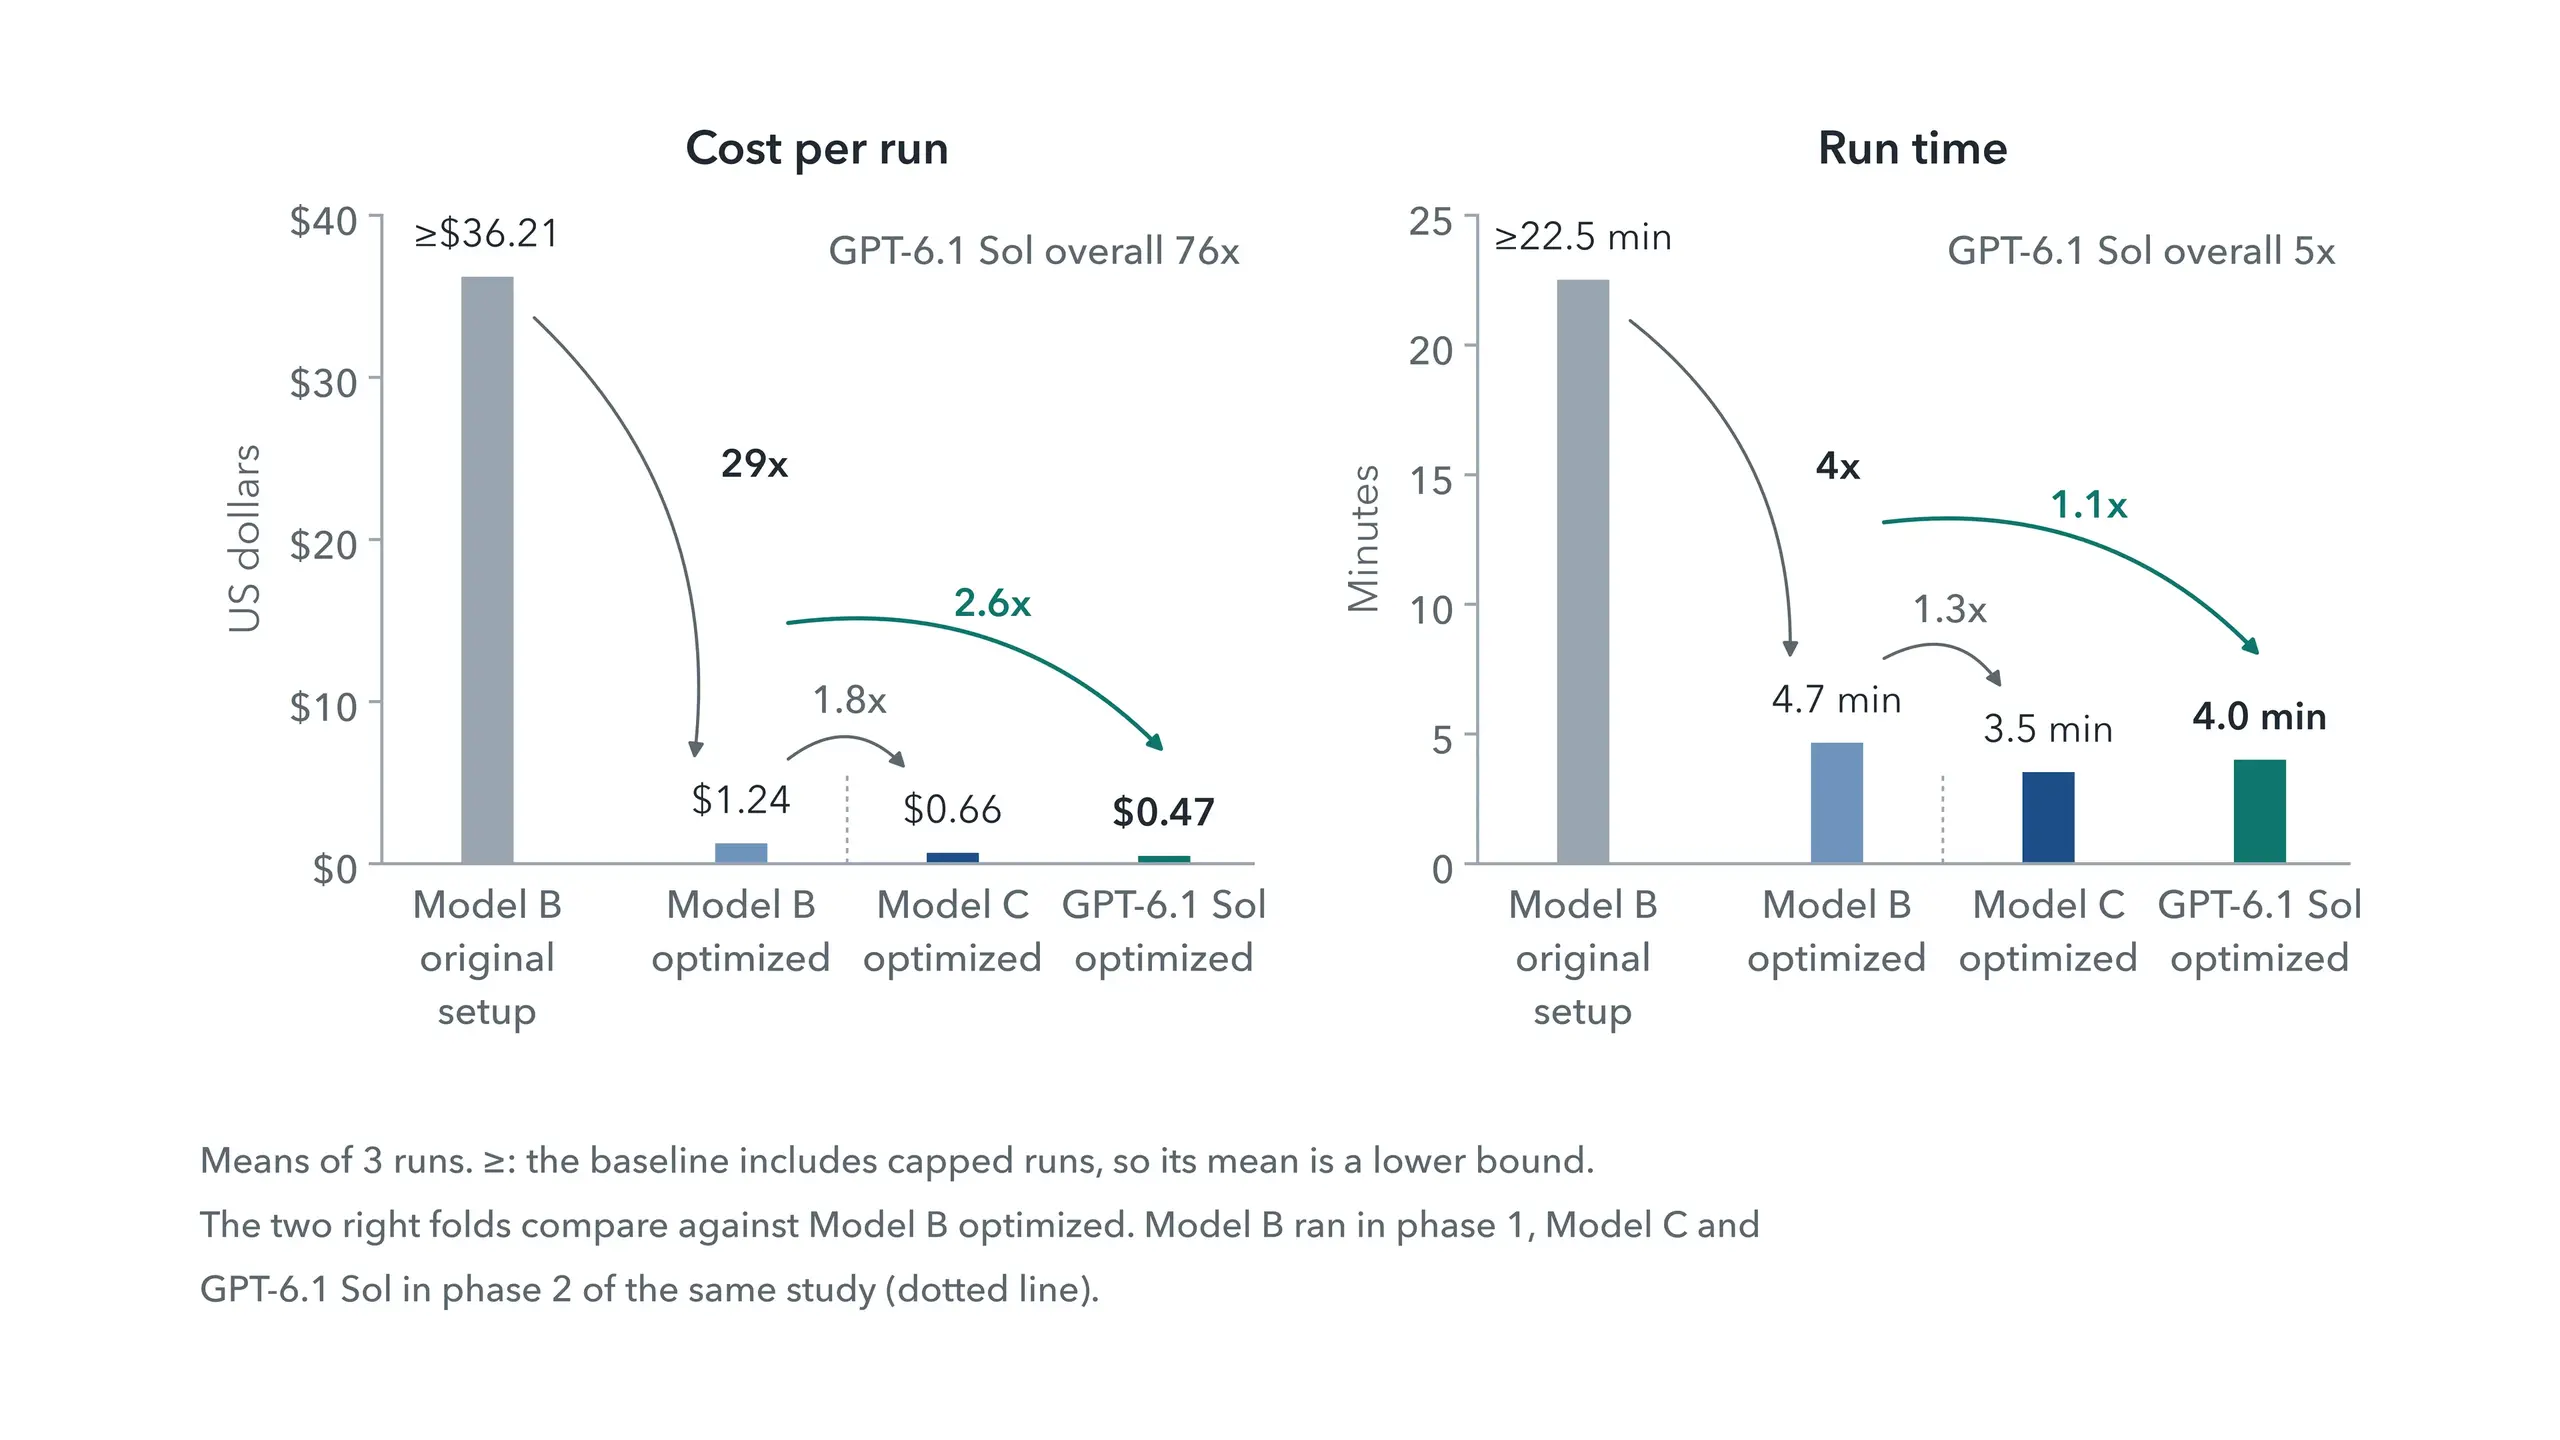
Op Model B verlaagde de beste conditie de kosten per uitgevoerde actie met een factor 29 en was de uitvoering 4x sneller dan de oorspronkelijke productieopstelling. Op GPT-6.1 Sol kostte dezelfde agent 76x minder en draaide hij 5x sneller, waarbij 89% van zijn input uit de cache werd gelezen. Bij elk model kostte elke run in de beste omstandigheden minder dan elke run in de basissituatie en werden alle 192 feiten gevonden.
Lessen
Het budget moet passen bij het model. Nieuwere modellen gebruikten het kleinere budget sneller op: Model C snoeide zijn geschiedenis voor het eerst bij oproep 10, Model A bij oproep 64. Bij 120.000 tekens gaf model C in geen van de 18 runs antwoord en Sol in 3, waarbij de meeste de staplimiet bereikten; bij 480.000 gaf elke run op beide modellen antwoord.
Alleen caching is niet genoeg. Zonder batch-snoeiing kostte het cachen van de geschiedenis bij het grotere budget meer dan het niet cachen ervan bij drie van de vier modellen: de cache werd voortdurend herschreven en zelden gelezen.
Moet je überhaupt snoeien?
De gegevens per oproep suggereerden dat snoeien hier misschien niet nodig was, dus bij een vervolgtaak werd elke schermafbeelding bewaard. De kosten per oproep waren 1,2x lager dan de beste conditie op Model B en Sol, en ongeveer 5% lager op Model C. Snoeien blijft belangrijk voor lange taken, kleine contextvensters en duurdere cache-lezingen.
Met drie of vier uitvoeringen per voorwaarde en aantallen oproepen die tussen de uitvoeringen verschillen, toont dit onderzoek brede patronen in plaats van voorwaarden te onderscheiden die slechts een paar procent van elkaar verschillen.
Beveiligingsmaatregelen blijven belangrijk
Geen enkele run bereikte het budget van 480.000 tekens, dus het beperkte deze runs niet. Limieten blijven belangrijk: een afdrijvende agent groeit naar de contextlimiet toe, en als de cache kapot gaat, betaalt elke aanroep de volle prijs. Limieten op stappen, tokens en kosten per uitgevoerde actie beperken de kosten van een slechte uitgevoerde actie. Compactie is een andere optie, die buiten het bereik van dit onderzoek valt.
Van bevindingen tot productie
Sommige bevindingen kwamen later naar voren, toen andere agenten elk spoor dat in Command was geregistreerd, beoordeelden. Dat is moeilijk te doen vanuit één sessie, waarbij je er niet zeker van kunt zijn dat alle gegevens zijn opgeslagen. Door alles in Command te bewaren, waartoe onze agenten toegang hadden via MCP, hoefden we nooit een experiment te herhalen om ontbrekende gegevens te herstellen, wat het werk versnelde. Bevindingen werden tickets voor mensen en codeeragenten, pull requests werden daar beoordeeld en de wijzigingen werden naar StackAI gestuurd. Sinds het onderzoek hebben we dezelfde taak ook uitgevoerd met Codex, die zijn aanpak vergeleek met die van de StackAI-agent en een tweede ronde van verbeteringen voorstelde, nu tickets in Command.
Wat we hebben geleerd
Cache de groeiende geschiedenis, niet alleen de systeemprompt.
Houd de geschiedenis alleen-toevoegen; wanneer snoeien nodig is, snoei dan in grote batches.
Stel het geschiedenisbudget in zodat het past bij het model.
Meet cache-lezingen per oproep met behulp van de eigen tellers van de provider.
Houd een volledig verslag bij van elke sessie, zodat de analyse en het vervolgwerk hetzelfde verslag gebruiken.
Asana bouwt tools om experimenten zoals deze routinematig te maken. De volledige studie omvat methoden, resultaten en beperkingen.
De verzendsnelheid is niet langer het knelpunt; menselijke aandacht is dat wel. Ik denk dat we dicht bij een wereld staan waar elke engineer een PM is die een vloot van agenten leidt.